
DynamoDB Export를 BigQuery CDC로 처리하기까지
DynamoDB Incremental Export 데이터를 BigQuery CDC로 적재하는 방식을 다룹니다. SQL MERGE 쿼리로 Insert·Update·Delete 변경을 반영합니다.
#DynamoDB#BigQuery#CDC
500
DynamoDB Export를 BigQuery CDC로 처리하기까지
SQL 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 11개 · 많이 쓴 회사 밸런스히어로·8퍼센트·마켓컬리
20개 표시
DynamoDB Incremental Export 데이터를 BigQuery CDC로 적재하는 방식을 다룹니다. SQL MERGE 쿼리로 Insert·Update·Delete 변경을 반영합니다.
그래프 데이터 모델링에 따라 관계 탐색 깊이와 결과 의미가 달라짐을 설명했습니다. SQL·Cypher와 BFS·DFS·Dijkstra·A*를 서비스 아키텍처 관점에서 비교했습니다.
비개발자 대상 사내 바이브코딩 교육의 커리큘럼과 실습 운영 경험을 공유했습니다. AI 기획 인터뷰와 배포 환경이 완성 장벽을 낮춘 과정을 설명합니다.
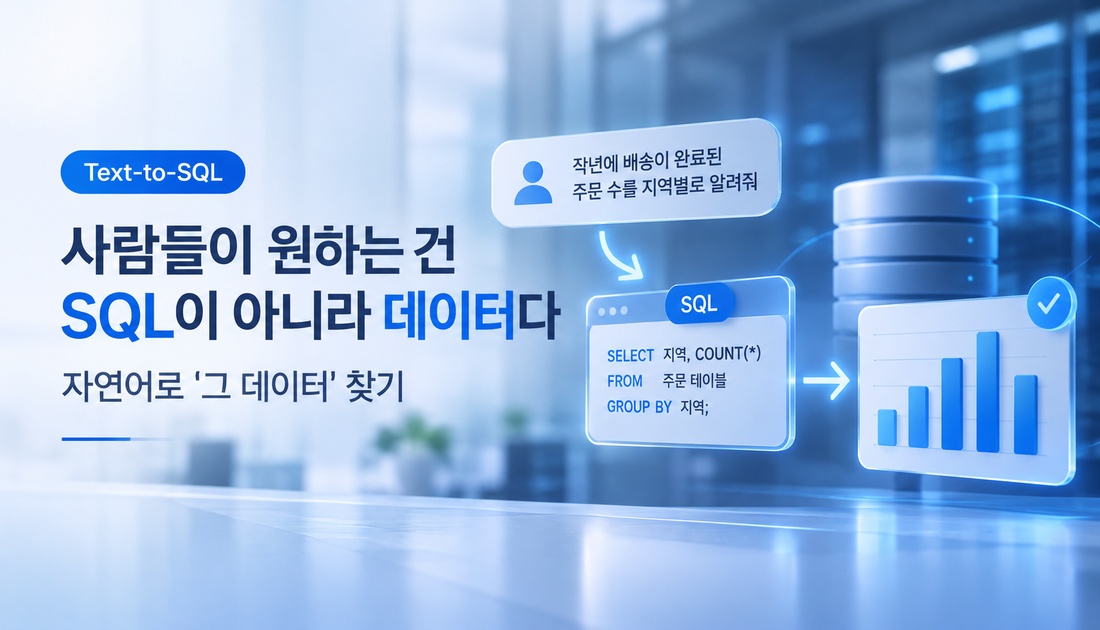
Text-to-SQL의 핵심 난제가 SQL 문법이 아닌 스키마 링킹임을 설명했습니다. 데이터 사전·관계 정보·예시 쿼리 정비와 안전한 운영 방안을 제안합니다.
분산된 정책·배포·실험 기록을 시간축과 질문별 화면으로 연결한 허브 사례를 소개했습니다. 변경 근거와 수집 한계를 함께 보여 신뢰 가능한 분석 맥락을 만들었습니다.

갤럭시 워치 홈 앱의 간헐적 Jank 원인을 찾는 AI 에이전트 개발 사례를 소개합니다. 자동 재현, Perfetto SQL 전처리, 소스코드 매칭으로 개선안 도출을 시도했습니다.
데이터 거버넌스와 업무 맥락을 기반으로 AI 셀프서비스 분석 환경을 구축했습니다. 라우팅·역질문·평가 체계로 신뢰성을 높이고 데이터 요청 문의를 약 95% 줄였습니다.
추천팀은 AI 에이전트가 지침 문서를 바탕으로 SQL을 작성하고 Hadoop에서 분석하도록 구성했습니다. 로그 접근 방법과 분석 기준을 컨텍스트로 설계해 신뢰 가능한 분석 환경을 만들고자 했습니다.
검증된 SQL·문서·코드를 repo 컨텍스트로 활용해 Slack 기반 AI 데이터 분석가를 만들었습니다. 반복 분석을 5분 내 처리하되, 지표 정의와 복잡한 판단은 사람이 맡습니다.

검증된 분석 산출물을 repo 컨텍스트로 활용해 Slack AI 데이터 분석가를 구축했습니다. 반나절 걸리던 분석을 5분으로 줄이고, 스레드 맥락·신뢰 장치·24시간 운영을 보완했습니다.
검증된 분석 산출물을 repo에 축적해 Slack 기반 AI 데이터 분석가를 구축했습니다. 스레드 맥락·스키마 검증·원격 운영으로 분석 요청을 약 5분 내 처리합니다.
조직 데이터 맥락을 반영해 자연어 질문을 SQL 쿼리로 바꾸는 Data Query ACE를 소개했습니다. Private 환경과 접근 권한 통제로 민감한 데이터 조회를 지원합니다.
폐쇄망 분석실에서 Python과 SQLite로 약 19.8억 행의 SAS 데이터를 월별로 적재·정제했습니다. 색인과 PRAGMA를 작업별로 조정하고 조인 팬아웃을 검증하는 방법을 설명합니다.
Investigating unintended model actions in our evaluations and internal use
Anthropic은 Claude 평가와 내부 사용에서 확인한 의도치 않은 외부 시스템 상호작용 사례를 공개했습니다. 모든 내부 평가의 라이브 인터넷 접근을 중단하고 탐지·완화 조치를 확대했습니다.
Amazon Quick으로 사내 데이터와 업무를 연결하는 AI 에이전트 실습을 소개했습니다. 보안 거버넌스와 자연어 기반 분석·자동화 기능을 함께 다뤘습니다.
A2A 역할 분리와 온톨로지 기반 RAG로 대화형 BI의 지표 해석 근거를 보강했습니다. Query Guardrail의 RLS·CLS 검증으로 LLM 생성 SQL의 실행 안전성을 통제했습니다.
AI로 분석 툴 노트북을 빠르게 검증하고, 디자인으로 밀도와 사용성을 완성한 3개월의 과정을 정리했습니다. 고객이 실제로 쓸 수 있는 제품이 되기까지의 판단과 협업 방식을 소개합니다.
Kafka Rebalancing 원인을 메시지 처리 지연과 DB 저장 병목에서 찾고, 운영 완화를 위해 설정을 조정했습니다. 이후 Batch Insert로 처리 시간을 줄여 반복 Rebalancing을 완화했습니다.
AI를 새로운 데이터 소비자로 보고 데이터 플랫폼의 조건을 세 가지 질문으로 정리했습니다. 맥락 제공, 접근 통제, 공통 인터페이스를 통해 AI-Ready Data Platform을 설계하는 방향을 소개했습니다.

AI를 개인 생산성 도구가 아니라 조직의 공통 지식 기반으로 확장하는 방법을 설명했습니다. 서비스 설계도와 코드, 데이터, 정책을 연결해 문제정의와 유지보수 속도를 높이는 사례를 소개했습니다.