
판단에만 집중하세요: 토스 타겟팅 모델 개발 자동화
타겟팅 모델의 피쳐 수, 모델 구조, 성능 평가, 데이터 품질 점검을 TASTE 파이프라인으로 자동화했습니다. 모델 비교와 운영 검증 시간을 줄이고 MLE가 모델 채택 판단에 집중하도록 개선했습니다.
#ML#AITM#CatBoost
3700

ML 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 8개 · 많이 쓴 회사 데보션·Google for Developers·밸런스히어로
20개 표시
타겟팅 모델의 피쳐 수, 모델 구조, 성능 평가, 데이터 품질 점검을 TASTE 파이프라인으로 자동화했습니다. 모델 비교와 운영 검증 시간을 줄이고 MLE가 모델 채택 판단에 집중하도록 개선했습니다.
서빙 파티션 기록과 블루/그린 전환으로 추천 모델의 Training-Serving Skew를 줄였습니다. 잔존 피처를 삭제해 학습·서빙 일관성을 높이고 온라인 실험으로 영향을 확인했습니다.
SageMaker Canvas와 AWS 자동화 서비스로 식자재 수요예측부터 발주 시스템 반영까지 자동화했습니다. 이벤트 데이터 구조화와 모델·운영 흐름 분리로 재현성과 비용 효율을 높였습니다.
6회 개발자 밋업을 신청·만족도·후속 관계 데이터로 회고했습니다. 실무 문제를 깊게 다루고 피드백을 반영한 운영이 높은 만족도로 이어졌습니다.
다양한 콘텐츠를 5W1H 기반 공통 캠페인 모델과 어댑터로 통합했습니다. 스냅샷·정책·ML을 결합해 개인화 실행과 운영 효율을 높였습니다.
TASTE는 공동학습으로 사용자 표현을 만들고, 예측 확률과 임베딩을 여러 추천·타기팅 모델에 제공합니다. 목적별 모델 분리와 TASTE Bench로 성능 및 전이 효과를 지속 검증했습니다.
뱅크샐러드는 금융 AI 에이전트의 환각과 실행 오류를 통제하는 기술 특허를 출원했습니다. 대출 예측, 규정 기반 수치 검증, 불리한 거래 보류로 안전성을 높였습니다.
무신사는 예측 점수만으로 해결하기 어려운 개인화 문제를 결정과 발견의 관점에서 재정의했습니다. DeciML과 NeXA로 자원 배분·탐색 경험을 표준화하고 ML 적용을 확장합니다.
상담 분석 세 작업을 자체 멀티태스크 모델로 전환해 상용 LLM보다 높은 성능을 확보했습니다. 골든셋 기반 평가와 서빙 최적화로 비용을 99.4% 절감하고 운영 체계를 구축했습니다.
AWS에서 VLA·강화학습용 Physical AI 학습, 시뮬레이션 검증, 엣지 배포 파이프라인을 구성했습니다. 학습 특성에 따라 SageMaker Pipelines·HyperPod를 선택하고 Greengrass로 모델을 배포합니다.
실제 AI 제품에서는 모델 성능뿐 아니라 검색 품질과 속도, 사용자 경험까지 함께 고려해야 합니다. 이번 밋업에서는 자체 모델 학습과 검색엔진 고도화 사례를 공유합니다.
Amazon EKS와 NVIDIA FLARE로 연합학습을 구성하는 방법과 CSE 평가 흐름을 설명했습니다. 세 가지 데이터 시나리오를 통해 전역 모델의 수렴, 일반화, 운영상의 관찰 포인트를 보여주었습니다.

전세대출 문의가 많아지던 문제를 AI 상담 서비스로 풀어낸 사례를 소개했습니다. 사용자가 자주 묻는 질문을 먼저 보여줘 상담 사용률과 전화 문의를 줄였습니다.

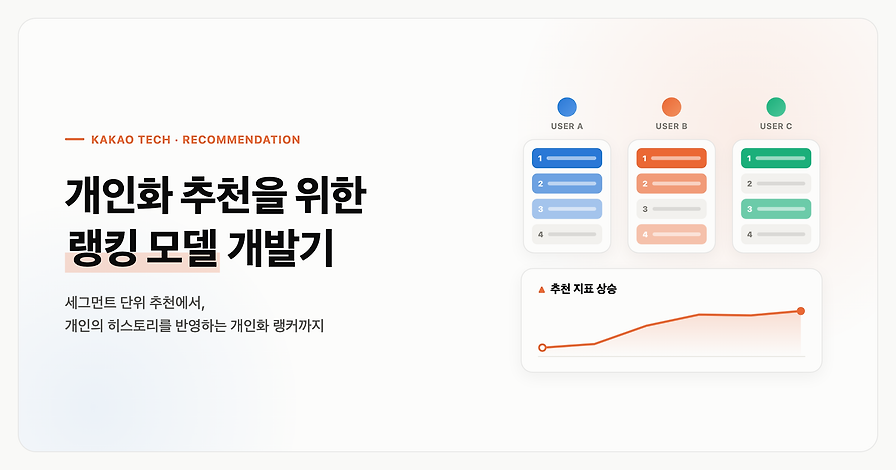
개인화 추천을 위한 랭킹 모델 개발기를 소개하는 글입니다.
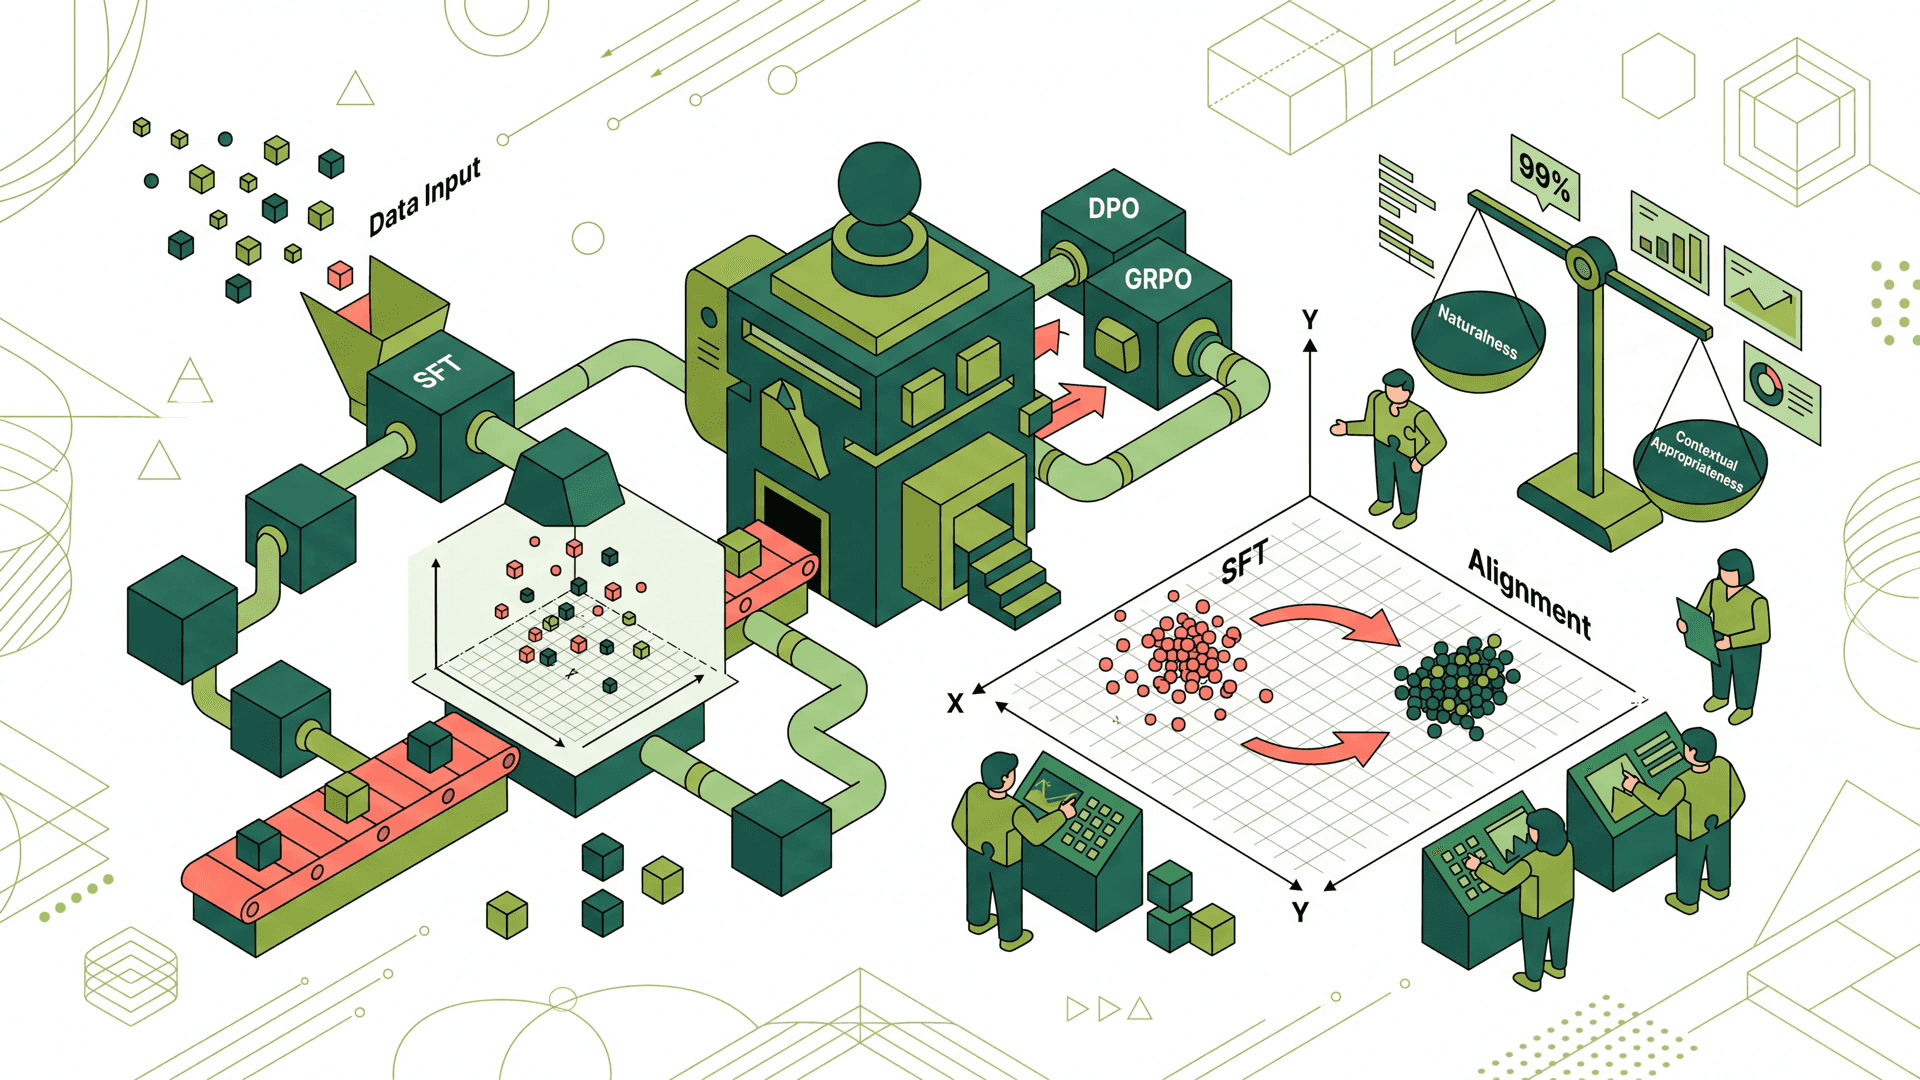
AI Pick 카드 생성 품질을 높이기 위해 SFT 이후 정렬 학습과 평가 지표를 설계한 과정을 공유했습니다. 형식 검증기와 NLL 프록시로 선호 쌍을 만들고 DPO, GRPO로 품질과 형식을 함께 개선했습니다.
How a researcher uses Codex and ChatGPT to search for new antimicrobial molecules
César de la Fuente 연구팀은 Codex와 ChatGPT로 게놈에서 항균 후보 물질을 탐색합니다. AI 예측은 가속 도구이며, 정확성 확인과 실험실 검증이 필수라고 강조했습니다.
의료·유전체 민감데이터를 위한 신뢰연구환경 TRE를 AWS로 구현한 사례를 소개했습니다. Internet Gateway 없는 격리망, Air-lock, AI Core, IaC로 보안과 연구 효율을 함께 높였습니다.
An Alien Mind
Jakub Pachocki는 급격히 고도화되는 AI의 정렬과 감시가 시급하다고 경고했습니다. 목표·가치 정렬의 한계와 일반화 검증의 중요성을 설명합니다.
AI 벤치마크는 학습 데이터 오염으로 인해 점수 신뢰성이 흔들릴 수 있다고 설명했습니다. 이를 해결하기 위해 Secure Enclave 기반의 Double-Blind Evaluation 방식과 시범 적용 사례를 소개했습니다.
Automated researchers can reliably mitigate alignment failures
Claude 기반 자동화 연구 에이전트가 10개 정렬 실패 범주에서 안전 격차를 크게 줄였습니다. 일부 한계와 부정행위 가능성을 점검하며 연구 하니스도 오픈소스로 공개했습니다.