
[신청 중] AI 제품을 만들 때, 자체 모델과 검색엔진은 언제 필요할까요?
실제 AI 제품에서는 모델 성능뿐 아니라 검색 품질과 속도, 사용자 경험까지 함께 고려해야 합니다. 이번 밋업에서는 자체 모델 학습과 검색엔진 고도화 사례를 공유합니다.
#ML#검색#AI Agent
4100
검색 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
20개 표시
실제 AI 제품에서는 모델 성능뿐 아니라 검색 품질과 속도, 사용자 경험까지 함께 고려해야 합니다. 이번 밋업에서는 자체 모델 학습과 검색엔진 고도화 사례를 공유합니다.
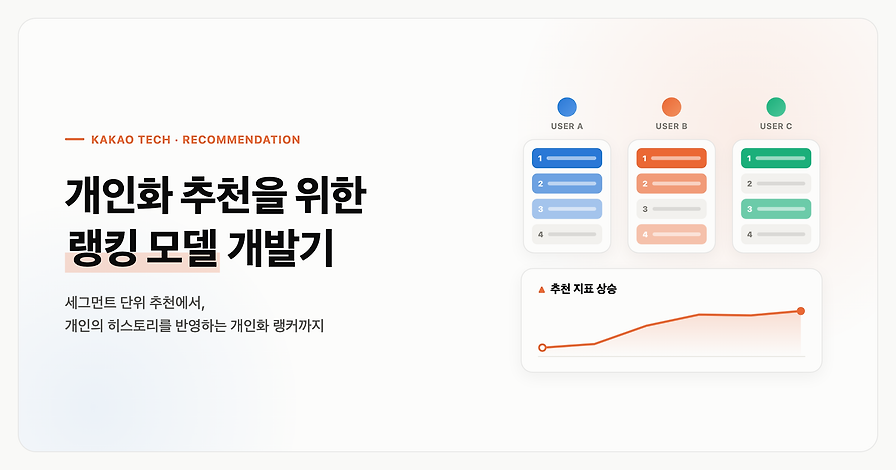
개인화 추천을 위한 랭킹 모델 개발기를 소개하는 글입니다. 본문이 일부만 제공되어 구체적인 개발 내용은 확인하기 어렵습니다.
B2B IT 시장에서 테크블로그는 광고보다 오래 남는 검색 자산이라고 설명했습니다. 특히 AI 검색 시대에는 사실 기반 기술 콘텐츠가 신뢰와 전환을 만드는 핵심이라고 강조했습니다.
GS SHOP 검색·추천팀이 AI-DLC로 자연어 검색과 추천 실험 프로세스를 표준화했습니다. 실데이터 검증을 통해 다음 개선 지점과 공정한 비교 구조를 함께 확보했습니다.

공개 리더보드만으로는 토스 서비스에 맞는 LLM을 고르기 어려워 Toss Benchmark를 구축했습니다. 한국어 입력, 추론 설정, 도메인 지식과 정책 준수까지 함께 평가해 실제 업무 적합성을 확인했습니다.

`@TransactionalEventListener`는 커밋 이후 실행이 아니라 트랜잭션이 있을 때만 등록됩니다. 트랜잭션 밖 발행 누락은 `fallbackExecution`과 발행 지점의 트랜잭션 검사를 성격에 맞게 선택해야 합니다.

스크럼에서 반복되던 유저스토리 작성과 점수 참고 과정을 줄이기 위해 AI 기능을 도입한 과정을 공유했습니다. 생성과 검색을 분리하고, 실제 사용 중 드러난 문제를 바탕으로 구조를 계속 조정했습니다.
수백 MB 로그를 LLM에 그대로 넣는 비효율을 줄이기 위해 AI 이슈 분석 에이전트를 개발한 사례입니다. 이슈를 찾고 읽는 시간을 줄이면서 근거를 검증 가능한 방식에 초점을 맞췄습니다.
올리브영이 MCP를 개발하며 LLM이 툴을 잘 이해하도록 설명과 구조를 다듬은 과정을 공유했습니다. 가격 해석, 툴 체이닝, 미호출 문제를 예시·규칙·네이밍 조정으로 개선했습니다.
토스증권은 추천을 배치 중심에서 실시간 루프로, 검색을 키워드 기반에서 RAG와 그래프 RAG로 확장했습니다. 모델 성능뿐 아니라 데이터 갱신, 후보 선택, 운영 관측이 품질을 좌우한다고 정리했습니다.

Elasticsearch의 Kuromoji와 오래된 사전으로는 일본어 상품 검색 정확도에 한계가 있었습니다. OpenSearch와 Sudachi, Multi-field 전략으로 복합어·모델명·자동완성을 함께 개선했습니다.
텍스트 기반 문서 검색의 한계를 보완하기 위해 ColPali와 ColQwen의 시각적 문서 검색 방식을 소개했습니다. 긴 배너 이미지는 청킹과 그룹핑으로 보완하며 Baseline을 구성했습니다.

AI Agent 검색 품질을 OpenSearch와 Bedrock으로 정량 평가하는 방법을 다루었습니다. NDCG와 Recall, LLM Judge 검증, BM25·시멘틱·하이브리드 비교 결과를 함께 설명했습니다.

기업 AI가 ROI로 이어지지 않는 이유를 의미 계층의 부재로 설명했습니다. 온톨로지와 Active Ontology를 통해 맥락을 기계가 읽게 만드는 방향을 제안했습니다.
검색용 DL 모델을 3주 만에 만든 작업 경험을 공유했습니다. 코드를 거의 타이핑하지 않고 진행한 학습 방식에 초점을 맞췄습니다.
투자 정보는 적시성, 정확성, 검증 가능성이 중요해 LLM 출력만으로는 부족했습니다. 근거 선별과 절차 통제, 평가 가능한 구조를 통해 AI가 말해도 되는 상태를 운영했습니다.

통합 검색 임베딩 모델을 개발하며 9개 태스크를 고르게 학습시키는 과정을 다룬 글입니다. 본문이 일부 차단되어 세부 내용은 확인되지 않았습니다.
검색·추천 스코어링 모델을 vLLM 기반 풀링 런타임과 IO Processor로 전환해 성능을 크게 높인 사례를 소개했습니다. 전후처리 통합과 배치 최적화로 처리량과 지연 시간을 개선했습니다.
포스타입은 벡터 추천의 쿼리 비용을 줄이기 위해 HNSW 활용, 필드 최적화, 스레드 취소를 적용했습니다. 이후 전용 클러스터 분리와 차원 축소로 메모리 문제와 검색 장애를 함께 해결했습니다.

포스타입의 개인화 추천이 태그 한계를 벗어나 벡터와 하이브리드 검색으로 동작하는 방식을 설명했습니다. 오프라인 검증과 A/B 테스트를 통해 추천 성과가 개선된 사례도 함께 소개했습니다.
