
Hive는 잊으려 했지만, Spark는 기억하고 있었다: 사라진 get_table RPC 복원기
Hive 4.2에서 제거된 get_table RPC로 Spark 잡이 실패한 원인을 추적했습니다.\nThrift IDL 계약을 보존한 RPC 복원과 생성 코드 검증 방식을 정리했습니다.
#Hive#Spark#Thrift
1500
Hive는 잊으려 했지만, Spark는 기억하고 있었다: 사라진 get_table RPC 복원기
Spark 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
20개 표시
Hive 4.2에서 제거된 get_table RPC로 Spark 잡이 실패한 원인을 추적했습니다.\nThrift IDL 계약을 보존한 RPC 복원과 생성 코드 검증 방식을 정리했습니다.
Oozie/Sqoop 기반 데이터 파이프라인을 Airflow/Spark로 전환한 사례를 정리했습니다.\nYAML 템플릿, 동적 파티셔닝, Parquet 최적화로 운영성과 조회 성능을 함께 개선했습니다.
흩어진 클라우드 운영 데이터를 하나의 기준으로 모으기 위해 레이크하우스 기반 통합 플랫폼 Deck 구축 과정을 소개했습니다. Object Storage를 SSOT로 두고 레이어를 분리해 과금과 분석의 신뢰성을 높였습니다.

검색 리랭킹의 콜드 스타트와 임베딩 공간 불일치 문제를 안정화 기법으로 해결했습니다. 오프라인과 A/B 테스트에서 성능과 매출 개선도 확인했습니다.
Spark Connect를 멀티세션 서비스로 운영하며 생기는 단일 장애점과 리소스 경합 문제를 다뤘습니다. replica, Gateway, 부하 점수 기반 세션 배치로 안정성을 높인 과정을 정리했습니다.

Iceberg 운영에서 스냅샷 폭증과 Small File 문제를 어떻게 다뤘는지 정리했습니다. 작업 이력 관리와 메인터넌스 정책으로 비용과 성능을 개선한 사례입니다.
200개 이상 DB를 BigQuery로 옮기던 ELT 운영 문제를 DT Platform으로 분리·표준화했습니다. UI와 DSL, 자동 마이그레이션으로 리드타임과 리뷰 병목을 줄였습니다.
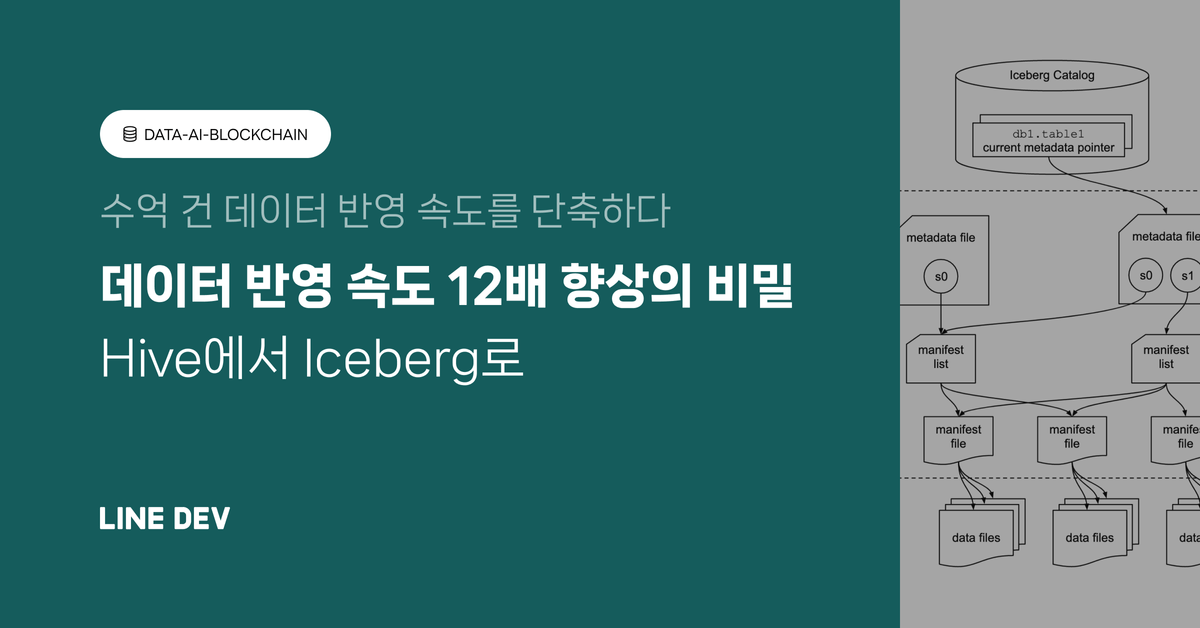
Hive 기반 전체 재작성 ETL의 한계를 Iceberg와 Flink로 개선한 사례를 소개했습니다. 체크포인트, 2PC, 파티셔닝 최적화로 데이터 반영 속도를 12배 높였습니다.
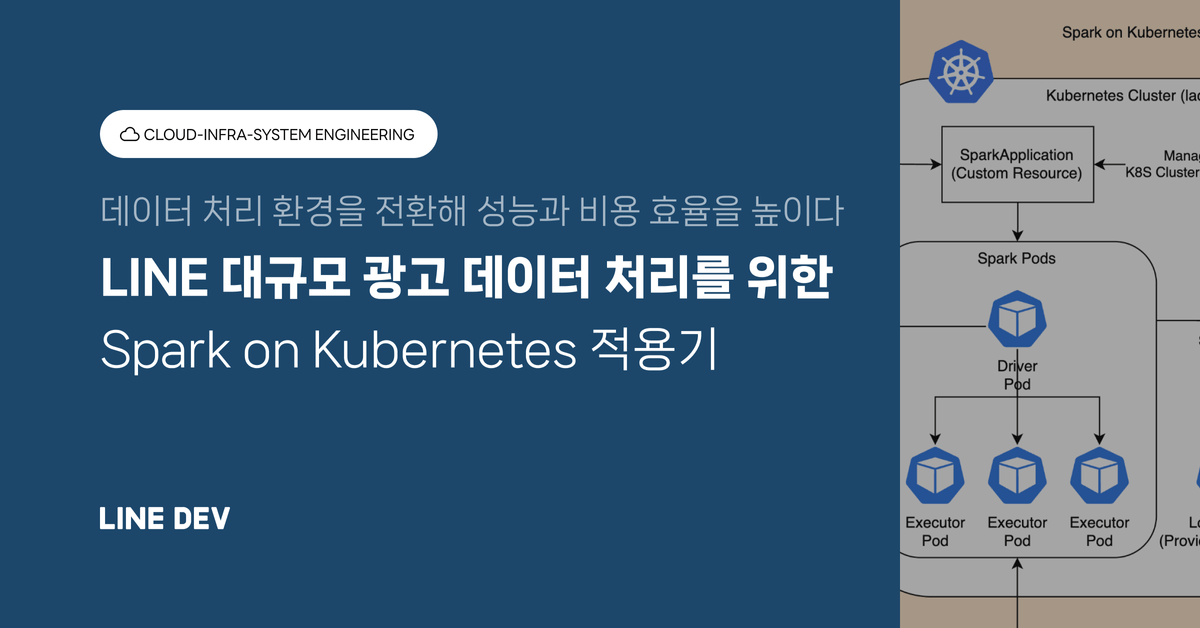
LINE Ads의 대규모 광고 데이터를 처리하기 위해 Spark on Kubernetes를 도입한 사례입니다. 성능 향상, 비용 절감, 버전 유연성을 함께 확보했습니다.
전수 적재의 지연과 정합성 문제를 해결하기 위해 CDC 기반 증분 복제 파이프라인을 설계했습니다. 전체 로우 해시와 사후 검증으로 멱등성과 신뢰도를 높이고, 시간 단위 배치로 최신성을 개선했습니다.
DynamoDB+S3 이중 저장을 Iceberg 단일 테이블로 통합해 비용을 약 91.5% 절감했습니다. 조회 성능과 서빙 안정성도 함께 개선하고, 컴팩션과 조회의 균형 중요성을 정리했습니다.
SparkListener와 Spark History MCP, n8n AI Agent를 연결해 Spark 장애 분석을 자동화했습니다.\n실시간 에러 감지와 히스토리 조회로 원인과 해결책을 Slack으로 전달했습니다.
Redshift 단일 클러스터의 적재 지연과 리소스 경합 문제를 해결하기 위해 Iceberg 기반 데이터레이크를 구축했습니다.\nGCS, BigLake Metastore, Spark, BigQuery를 분리해 멀티 엔진 운영과 벤더 종속 완화를 노렸습니다.
Karrot가 MongoDB 적재 방식의 한계를 해결하기 위해 CDC를 도입한 과정을 공유했습니다. 변경 로그 기반으로 BigQuery 적재를 구성하되, 초기 스냅샷은 별도 도구 활용을 검토했습니다.
MongoDB 덤프의 DB 부하와 SLO 문제를 해결하기 위해 CDC를 도입했습니다. Flink CDC와 Spark, 이중 테이블 구조로 적재와 스키마 변경, 정합성 검증을 묶었습니다.
Karrot 데이터팀이 BigQuery SQL 로그를 파싱해 컬럼 단위 데이터 계보를 구축한 과정을 소개했습니다. 테이블 단위 한계를 보완하고 영향 분석과 PII 추적을 정교하게 만든 사례입니다.
사용자 세그먼트 기반으로 A/B 테스트 그룹을 나누는 동적 분할 시스템을 소개했습니다. 타겟팅·할당·로그 수집 흐름과 실제 활용 사례도 함께 정리했습니다.
BigQuery 쿼리 로그를 SQL 파싱해 컬럼 레벨 리니지를 구축한 사례를 소개했습니다. 테이블·컬럼 의존 관계를 빠르게 추적해 데이터 신뢰성과 운영 효율을 높였습니다.
실시간 거래 리포트를 빠르게 조회하기 위한 저지연 설계와 최신성 확보 과정을 다뤘습니다. Spark, Iceberg, StarRocks 조합의 운영 사례와 성능 결과도 공유했습니다.
Zeppelin의 익숙한 사용성을 유지하면서 JupyterHub에 기능과 운영 체계를 단계적으로 구현한 내용을 정리했습니다. 대용량 SQL 안정화, GitHub 자동화, 무중단 운영과 추적성 확보가 핵심이었습니다.