세 번 그리던 화면을 한 번에: CLAYDesign이 디자인시스템으로 화면을 생성하는 방법
CLAYDesign은 디자인시스템 기반 화면 JSON을 생성·검사해 Figma와 플랫폼별 코드로 내보냅니다. 템플릿, 영역별 레퍼런스 검색, 타입 기반 카탈로그로 배민 디자인 규격을 유지합니다.
#LLM#Figma#React
1000
세 번 그리던 화면을 한 번에: CLAYDesign이 디자인시스템으로 화면을 생성하는 방법
LLM 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 55개 · 많이 쓴 회사 데보션·AWS·네이버 D2
20개 표시
CLAYDesign은 디자인시스템 기반 화면 JSON을 생성·검사해 Figma와 플랫폼별 코드로 내보냅니다. 템플릿, 영역별 레퍼런스 검색, 타입 기반 카탈로그로 배민 디자인 규격을 유지합니다.
분산된 금융 상품 데이터와 문서를 온톨로지·지식그래프로 연결한 AI 검색 서비스를 소개했습니다. P-E-W Agent와 근거 기반 답변 체계로 정확도와 응답 시간을 함께 개선했습니다.

LLM 외부에서 입력과 출력을 검증하는 다섯 가지 AI 가드레일 설계를 소개합니다. 비용·정책 관리·모델 교체에 유연한 안전 운영 계층을 설명합니다.
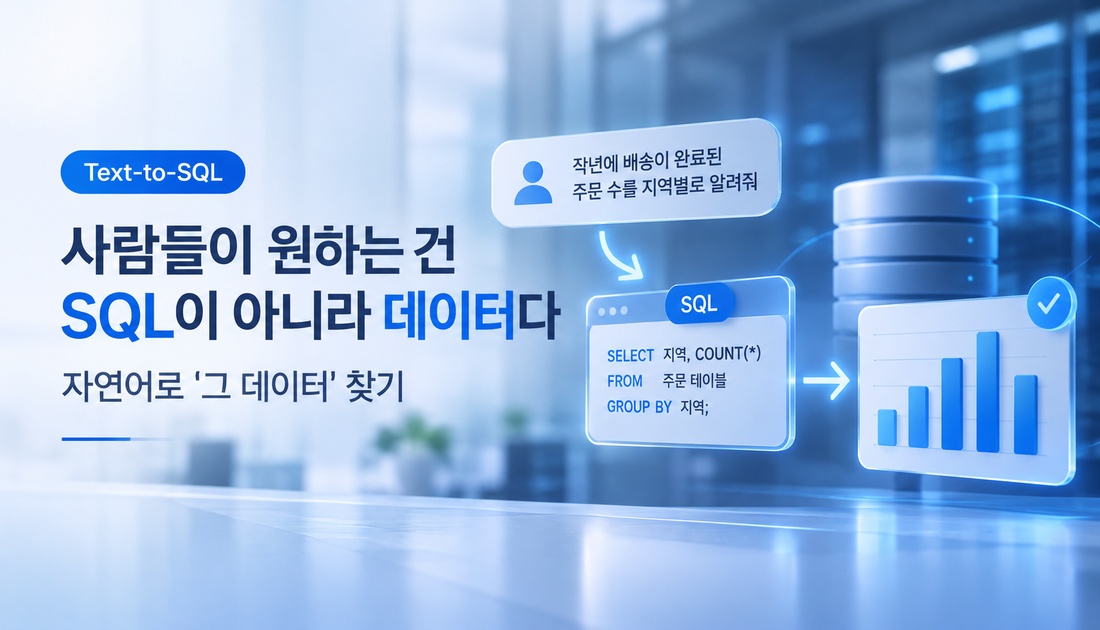
Text-to-SQL의 핵심 난제가 SQL 문법이 아닌 스키마 링킹임을 설명했습니다. 데이터 사전·관계 정보·예시 쿼리 정비와 안전한 운영 방안을 제안합니다.
Managing frontier AI risk: From training to deployment
OpenAI가 프런티어 모델의 학습부터 외부 배포까지 위험 관리 체계를 설명했습니다. 샌드박싱·모니터링·정렬 평가를 단계별로 강화했습니다.
Claude 업무 활용을 위한 구조화된 지시, XML 태그, 예시, 역할 설정 방식을 정리했습니다. 성공 기준과 테스트 세트 기반 평가로 프롬프트를 개선하는 방법을 제안합니다.
TV 소프트웨어 자동 테스트에서 쌓이는 대량의 실패 로그를 LLM으로 분석하는 파이프라인을 소개했습니다. 실제 이슈 선별과 담당자 지정을 자동화해 사람 검토 건수를 줄였습니다.
Introducing GPT-6.2 Astra and Sol
OpenAI가 전문 작업용 GPT‑6.2 Astra와 일상 업무용 GPT‑6.2 Sol을 공개했습니다. Astra는 코드·문서·컴퓨터 사용을 강화하고 API 가격도 낮췄습니다.

Amazon Bedrock과 LiteLLM 기반 AI Hub로 전사 Claude 이용을 단일 게이트웨이에서 관리했습니다. 인증·예산·감사 로그와 MCP 업무 도구 권한을 분리해 통제를 강화했습니다.

프로모션 검색과 상세 질의를 분리해 혜택·기간·제외 조건의 근거를 함께 확인하는 흐름을 설계했습니다. 문서 개정, 권한, 기간, 품질 지표를 검증해 상담 오안내를 줄이는 방법을 설명합니다.
업무 질문 기반 골든셋으로 검색 근거의 충족도와 순서 품질을 분리 평가하는 방법을 설명합니다. 실패·누락·핵심 예외 문항을 함께 기록해 변경 전후를 비교합니다.
공유 변수 중심 레거시의 숨은 데이터 흐름을 I/O 매트릭스와 코드 그래프로 추출하는 방법을 설명합니다. 이를 AI-DLC 요구사항·API 계약·검증 테스트에 연결해 DTO 분리 결함을 차단합니다.

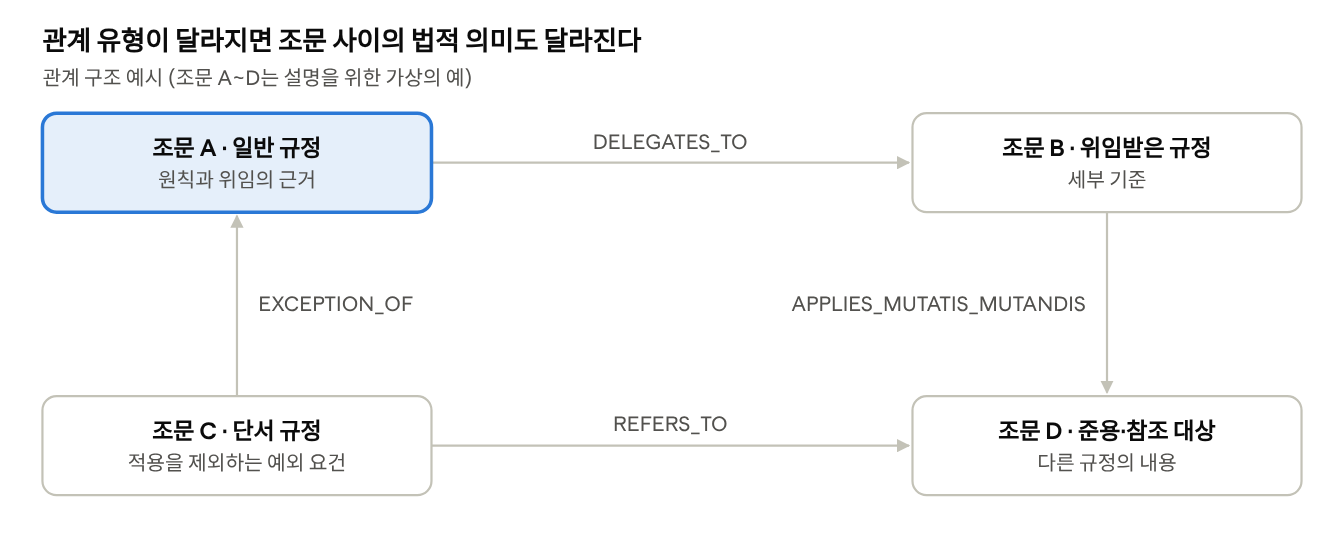
법규정의 위임·예외·준용 관계를 지식그래프로 구조화한 GraphRAG 상담서비스 설계를 설명했습니다. 질문 유형에 따라 검색 전략을 나누고 근거·관계 품질을 검증하는 방안을 제시합니다.
SGLang과 Qwen3-VL-8B로 다국어·이미지 판단을 수행하는 Decision Model 구성을 소개합니다. Confidence 보정과 Hybrid Escalation을 통해 Agent 지연시간과 비용을 줄이는 방법을 설명합니다.
Claude의 비용은 프롬프트 길이보다 매 턴 재전송되는 컨텍스트 크기에 크게 좌우됨을 설명했습니다. 캐싱, 도구 정리, 세션 분리와 측정 기반 모델 선택으로 토큰을 절감하는 방법을 정리했습니다.
Laya를 SageMaker에서 학습·배포해 한국어 개인정보를 확률 기반으로 판정하는 구성을 설명했습니다. 데이터 설계, 운영 규칙, 성능 비교와 재학습 시 유의점을 함께 정리했습니다.
MoE Gemma 4 26B의 전문가 절반을 가지치기해 노트북 내장 GPU에서 카페 주문 처리를 검증했습니다. 일반 지식은 감소했지만 64e는 실전 성능을 유지했으며, 과도한 가지치기는 사람 평가에서 드러났습니다.
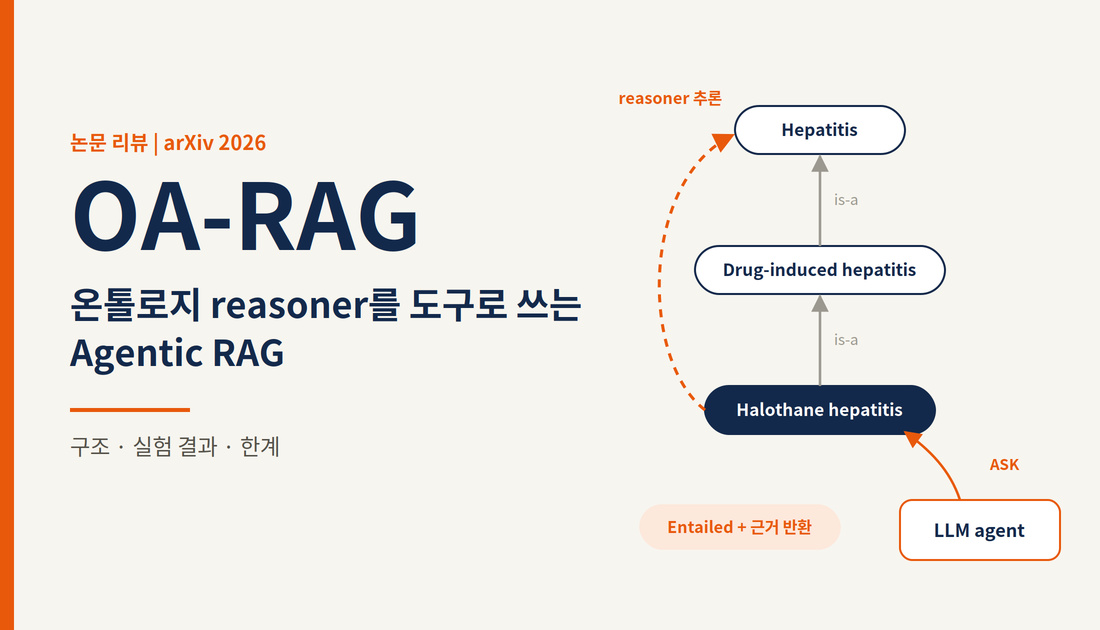
OA-RAG의 온톨로지 reasoner·LLM 결합 구조와 실험 결과를 분석했습니다. 의료 QA의 효율성과 평가 편향, grounding 신뢰도 한계를 함께 짚었습니다.
Arm AI Model Optimizer로 엣지 NPU와 클라우드 CPU용 모델 최적화 핸즈온을 소개했습니다. 양자화와 그래프 최적화로 지연 시간·모델 크기를 줄이고 정확도를 유지한 결과를 공유했습니다.
DEF CON CTF 본선에서 AI와 자동화 도구를 연결한 공격·방어 운영 경험을 공유했습니다. FUSE 취약점 체인과 PCAP 재현 기반 패치 검증 방식을 설명합니다.