로그가 서비스를 죽였다
동기 stdout 로깅이 커넥션 풀 고갈과 요청 실패로 이어진 원인을 분석했습니다. caller에서 추적 ID를 캡처해 비동기 로깅과 관측성을 함께 유지했습니다.
#logging#OpenTelemetry#분산 추적
5800
로그가 서비스를 죽였다
logging 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
20개 표시
동기 stdout 로깅이 커넥션 풀 고갈과 요청 실패로 이어진 원인을 분석했습니다. caller에서 추적 ID를 캡처해 비동기 로깅과 관측성을 함께 유지했습니다.
옵저버빌리티는 예상하지 못한 장애 원인까지 나중에 추적할 수 있게 만드는 기반입니다.\n메트릭, 로그, 트레이스를 연결해 마이크로서비스 환경의 문제를 요청 단위로 복원해야 했습니다.
수백 MB 로그를 LLM에 그대로 넣는 비효율을 줄이기 위해 AI 이슈 분석 에이전트를 개발한 사례입니다. 이슈를 찾고 읽는 시간을 줄이면서 근거를 검증 가능한 방식에 초점을 맞췄습니다.
EC2에서 EKS로 옮긴 뒤 컨테이너 메모리가 주기적으로 급증하는 현상을 추적했습니다. 원인은 로그 gzip 압축과 페이지 캐시였습니다.
2026 NAVER AI CHALLENGE 인턴십 모집을 안내하는 글입니다.\nAI 프로젝트를 현업 엔지니어와 함께 수행하며 과제형 실무 경험을 쌓을 수 있습니다.
AWS CloudWatch Agent는 실제 실행 시 .toml을 사용하고, .json은 입력용 설정 파일로 변환됩니다. 설정이 안 반영되거나 파일이 사라진 듯 보이면 원본 보관과 fetch-config 절차를 다시 확인해야 합니다.

네이버 통합검색 클릭 로그를 히트맵과 히스토그램으로 시각화하는 방법을 소개했습니다. 실시간으로 변하는 검색 서비스에 대응하며 얻은 시행착오와 노하우도 공유했습니다.
AWS Network Firewall로 아웃바운드 도메인 허용 목록을 자동화하는 방법을 소개했습니다. 로그 분석과 규칙 생성을 결합해 방화벽 운영을 단순화하는 내용입니다.
실시간 채팅 중심 고객센터를 게시판 기반 케이스 운영으로 전환해 응답과 해결 시간을 줄였습니다. 자동 정보 주입과 통합 어드민으로 품질과 운영 효율도 함께 높였습니다.

기존 모니터링의 한계를 짚고 옵저버빌리티의 필요성을 설명했습니다. 메트릭·로그·트레이스를 연결해 원인 분석과 장애 대응을 더 정확하게 만드는 방향을 제시했습니다.

서버 로깅 포맷을 통일해 유저·요청 단위 추적과 호출 위치 확인이 쉬워지도록 개선했습니다. 메타데이터와 트레이스를 더해 디버깅과 모니터링 효율을 높였습니다.

토스가 사용자의 기능 탐색 경험을 수치화하는 리서치 툴 TNS를 만든 과정을 소개했습니다. 라이브 앱 로그 분리와 커스텀 UI로 실제 내비게이션 경로를 측정하고 개선에 연결했습니다.

데이터 파이프라인 운영에서 노이즈 알림과 반복 대응으로 인한 피로를 줄이기 위해 AI 활용 방안을 소개했습니다. 로그 전처리, 노이즈 분류, AI Assistant 적용 사례를 중심으로 장애 대응 자동화를 다뤘습니다.
Datadog을 POS 환경에 적용해 전국 3,500대 장비의 로그와 장애를 실시간으로 모니터링하도록 구축했습니다. 장애 탐지 시간은 4분 30초에서 59초로 줄어들고, 사전 대응 체계도 마련했습니다.
AWS Network Firewall의 로그 수집과 분석 방법을 정리했습니다. Alert/Flow 로그 해석, Athena 쿼리, CloudWatch 필터링과 운영 시 주의점을 함께 설명했습니다.

Iceberg 테이블로 DB 로그와 서버 로그를 적재·운영하며 얻은 경험을 정리한 글입니다. 로그 유형별 운영 전략과 실무 교훈을 중심으로 다뤘습니다.
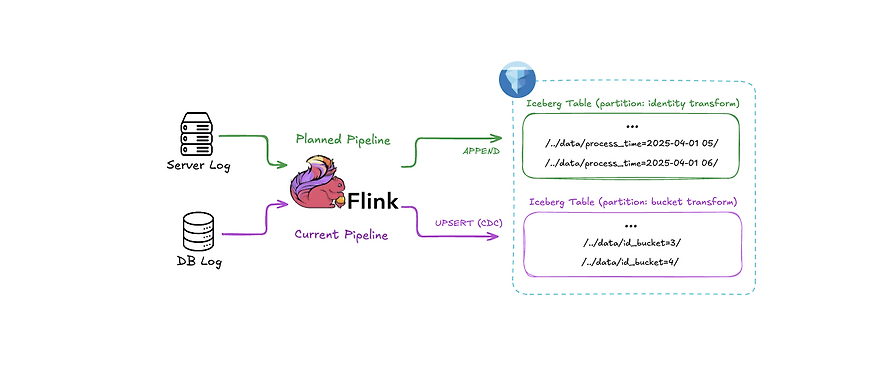
주니어 개발자의 에러 대응 역량을 높이기 위한 10주 디버깅 스터디 과정을 소개했습니다. 단서 수집과 가설 검증으로 근본 원인을 찾는 방법을 공유합니다.

Kotlin과 Java에서 SLF4J 로깅 시 불필요한 문자열 연산을 줄이는 방법을 다뤘습니다. 성능과 가독성을 비교해 Parameterized Logging과 kotlin-logging의 선택 기준을 제시했습니다.

로그 레벨을 ERROR와 WARN으로 재정의하고, 상황별 임계치 기반 알람을 구성했습니다.\n알람 피로를 줄이면서 운영 문제를 빠르게 인지하도록 로그를 지속 관리했습니다.

운영 로그의 기준을 다시 정리해 실제 장애와 가짜 에러를 구분하는 방법을 다뤘습니다. 알람 노이즈를 줄이고 빠른 인지를 위해 로그 레벨과 임계치를 팀 기준으로 조정했습니다.