
[AI Agent] 검색부터 상담 기록까지 이어지는 서비스 구조 설계
FastAPI 기반 상담 지원 서비스의 검색·답변·기록 흐름을 책임과 자원 수명 기준으로 분리했습니다. 컨테이너, 권한 검증, 부분 실패, 관측과 테스트의 운영 원칙을 설명합니다.
#FastAPI#RAG#PostgreSQL
2200
[AI Agent] 검색부터 상담 기록까지 이어지는 서비스 구조 설계
PostgreSQL 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 3개 · 많이 쓴 회사 AWS·채널톡·넥스트리
20개 표시
FastAPI 기반 상담 지원 서비스의 검색·답변·기록 흐름을 책임과 자원 수명 기준으로 분리했습니다. 컨테이너, 권한 검증, 부분 실패, 관측과 테스트의 운영 원칙을 설명합니다.
AI 상담 이력을 미들웨어와 관리 계층으로 분리해 저장·조회하는 구조를 설명했습니다. 세션 소유권, 중복 요청, 맥락 제한, 스트리밍·저장 실패 정책을 함께 다뤘습니다.
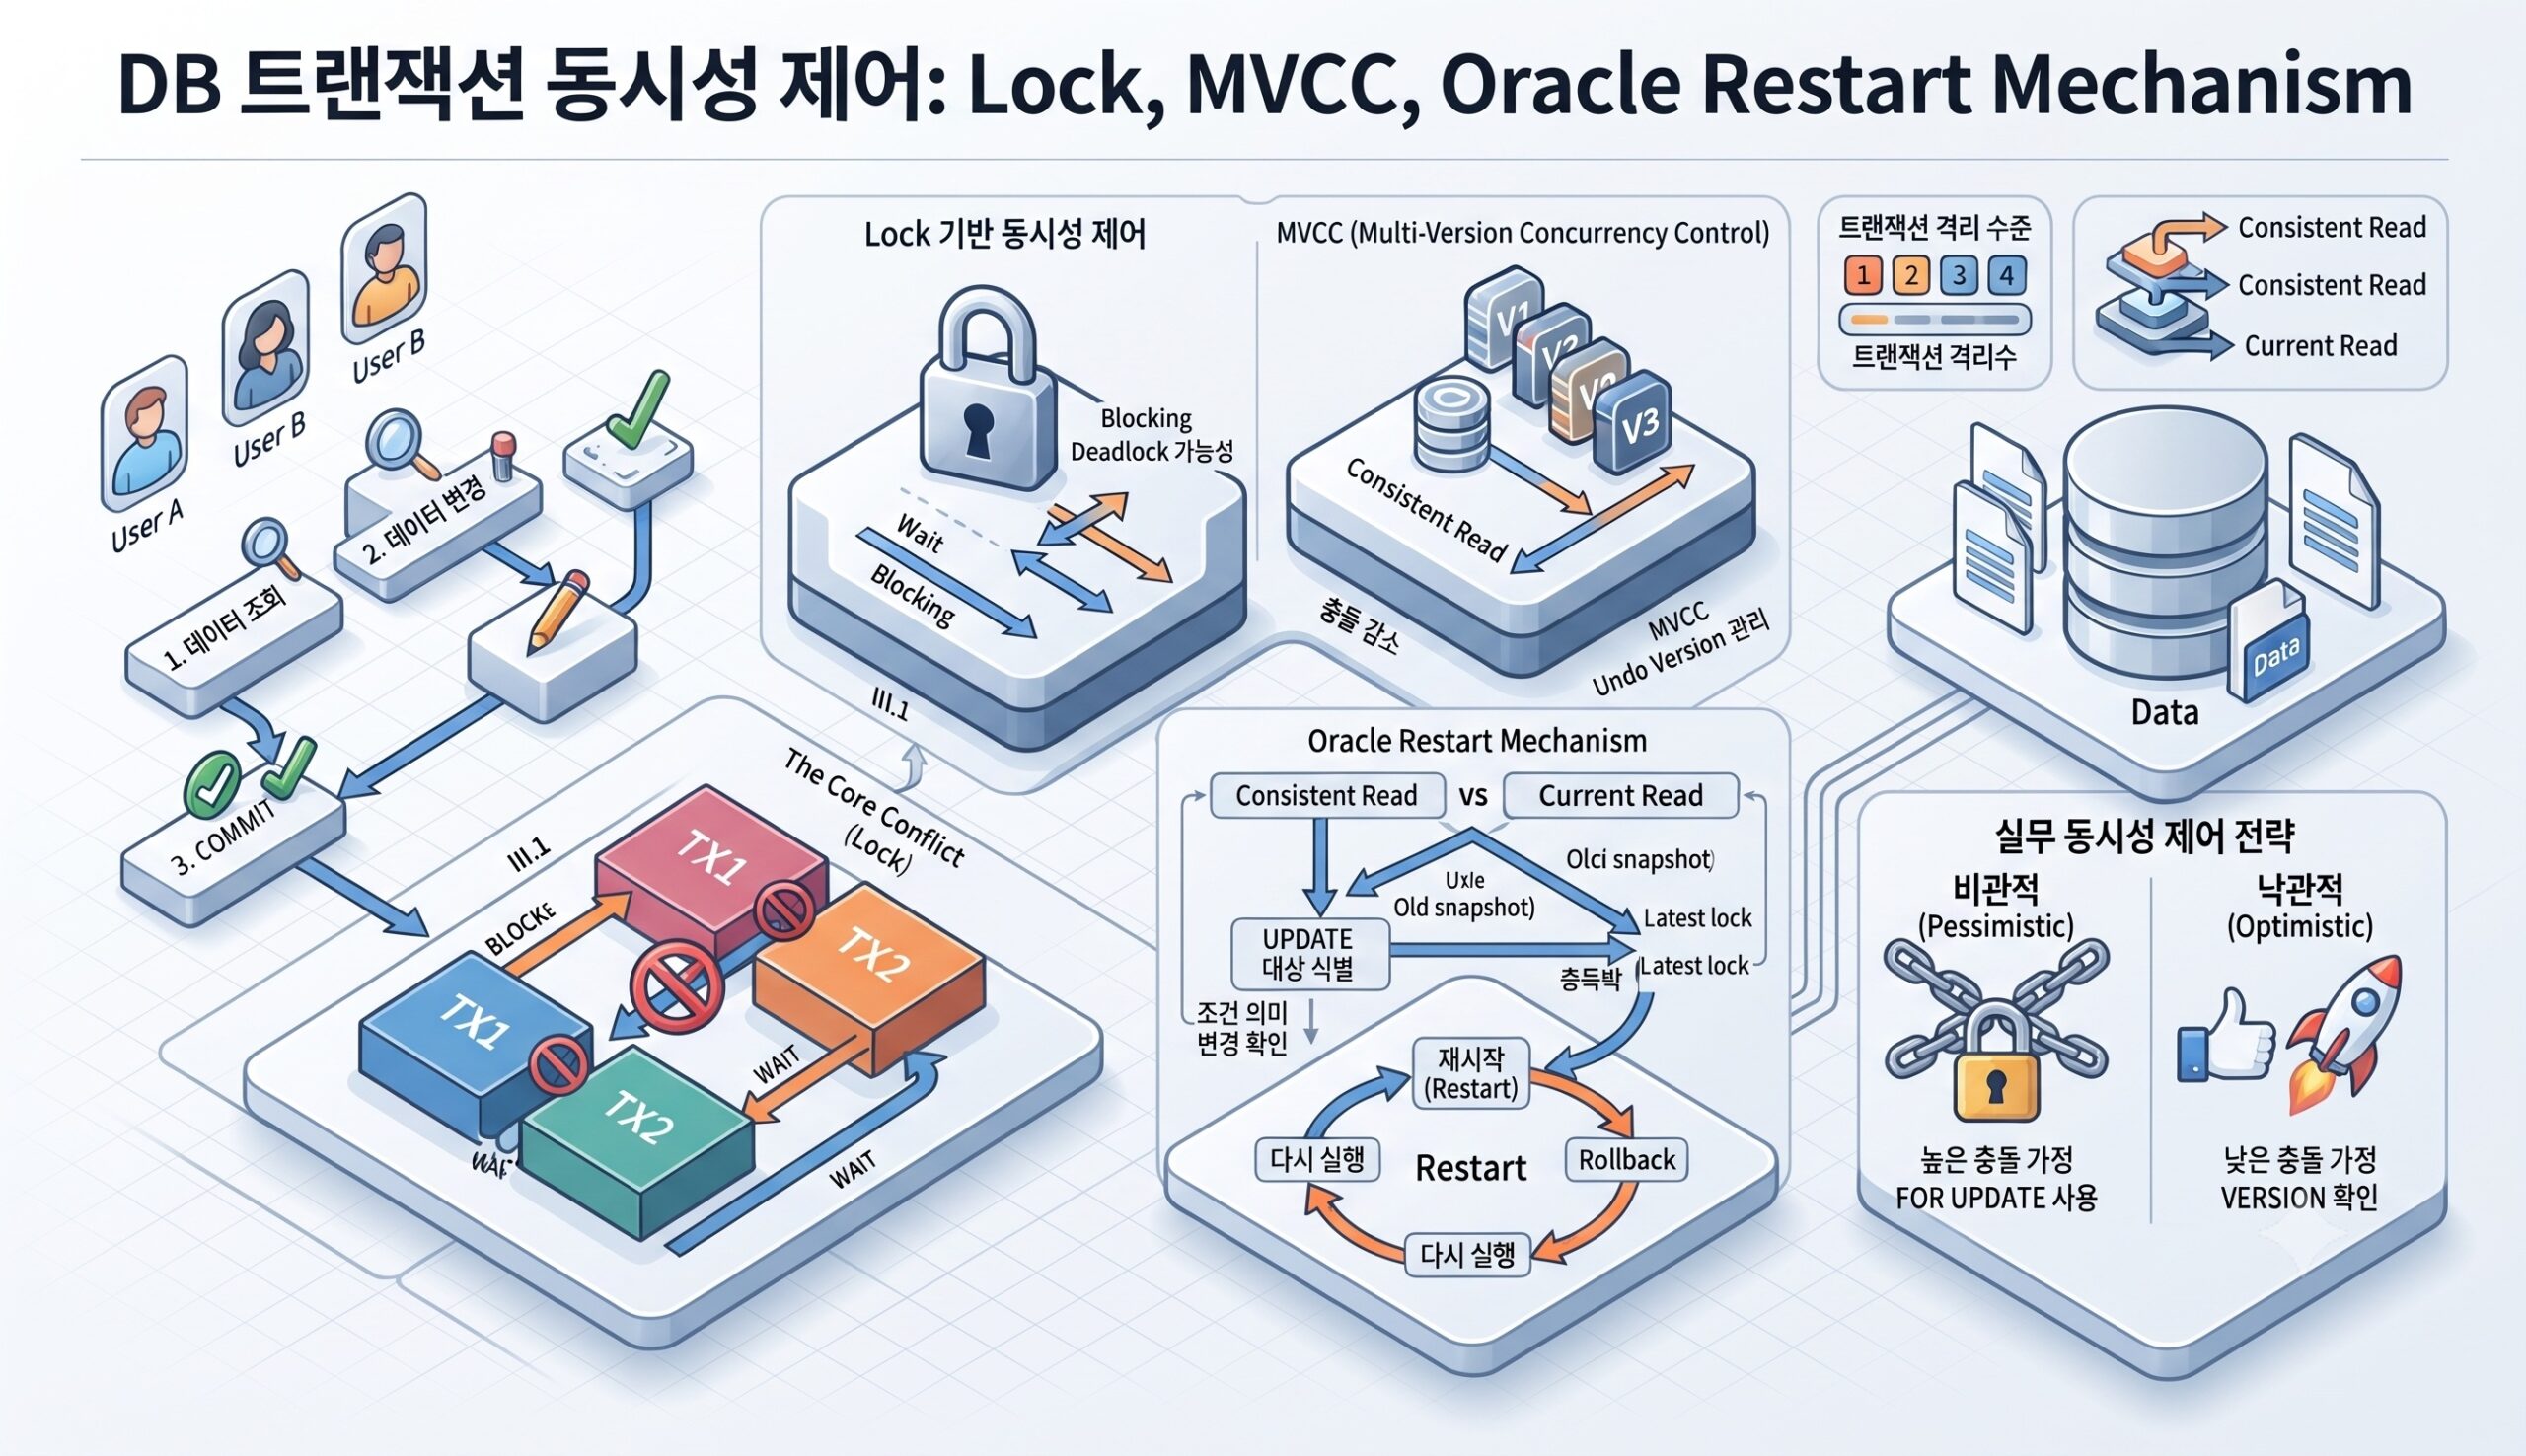
Lock, MVCC, 격리 수준을 바탕으로 DB 트랜잭션 동시성 제어를 설명했습니다. Oracle Restart Mechanism과 비관적·낙관적 제어의 선택 기준을 정리했습니다.
Hibernate 멀티테넌시로 행·스키마·DB 분리와 테넌트별 조회 흐름을 설명했습니다. 세션 경계, 네이티브 SQL, 커넥션 풀 운영 시 주의점을 정리했습니다.
FDE가 고객 요구를 PoC로 빠르게 검증하고 제품화 근거로 전환한 과정을 소개했습니다. 콜 캠페인에서 중복 발신 방지와 회선 용량 제어를 우선해 운영했습니다.
Naver Cloud에서 Managed NKS와 PostgreSQL 중심의 IaC 운영 플랫폼 구축 경험을 정리했습니다. Terraform·Ansible·GitOps의 책임 분리와 복구 검증 원칙을 설명합니다.
레거시 연동 수신 구간을 Inbox 패턴으로 바꾸고 Kafka 비동기 처리로 분리한 사례를 정리했습니다. 응답 시간 단축, 중복 방지, 장애 복구 자동화까지 실측으로 검증했습니다.
Aurora PostgreSQL에서 pgvector를 프로덕션 RAG에 운영하는 방법을 정리했습니다. HNSW 선택, 거리 함수, 메모리 계획, 관측성까지 실무 기준으로 설명했습니다.

Oracle에서 PostgreSQL로의 마이그레이션에서 가장 큰 병목인 저장 프로시저 변환을 멀티 에이전트 GAMMA로 자동화하는 내용을 다뤘습니다. 의존성 분석, 코드 생성, 검증, 지식 축적을 결합해 수동 작업을 줄이고 정확도를 높이는 방법을 소개했습니다.

운영 중 PostgreSQL에서 wraparound 방지 autovacuum이 CPU 100%를 유발한 사례를 정리했습니다. xid_age 누적, lock 경합, 긴급 대응과 사전 모니터링 포인트를 함께 설명했습니다.
오프라인 행사 운영을 웹앱으로 전환하며 1인 개발과 Claude 협업 방식을 정리했습니다. 설계, 디버깅, 리팩토링에서 AI를 파트너처럼 활용한 실무 인사이트를 공유했습니다.
Java 21 기반 게시판 프로젝트를 Java 25 환경으로 옮기는 과정을 다뤘습니다. 호환성 3요소와 Gradle, ByteBuddy, Hibernate 체크 포인트를 함께 살펴봤습니다.

Amazon Aurora와 RDS의 PostgreSQL 18에서 보안, 모니터링, 복제, 개발자 기능 개선을 정리했습니다. MD5 인증 중단, uuidv7(), COPY 및 RETURNING 개선, 복제 슬롯 보호 방법을 함께 소개했습니다.

Amazon Bedrock 기반 Claude 운영을 위한 Claude Apps Gateway의 구조와 구성 요건을 정리했습니다. IdP 연동, 권한 제어, 텔레메트리 중앙화까지 AWS 환경에서의 활용 방법을 소개했습니다.

PostgreSQL 18의 주요 성능 향상 기능을 Amazon Aurora 및 Amazon RDS 기준으로 정리했습니다. 복합 인덱스 활용, EXPLAIN 가시성, autovacuum 제어 개선을 함께 소개했습니다.

Databricks Summit 2026 키노트를 바탕으로 Agentic AI 시대의 데이터 플랫폼 전략을 정리했습니다. 실시간 데이터, 비즈니스 컨텍스트, 거버넌스의 중요성을 강조했습니다.

Databricks Data + AI Summit 2026 키노트에서 Agentic AI 시대의 데이터 플랫폼 방향을 정리했습니다. 실시간 데이터 기반과 비즈니스 컨텍스트, 중앙 거버넌스가 핵심으로 제시됐습니다.

자연어를 SQL로 바꾸는 과정에서 LLM이 만든 쿼리를 그대로 믿지 않고 여러 단계로 검증하는 구조를 소개했습니다. 도메인 지식은 DB에 담고, 실행 전후 게이트와 회귀 평가로 안전성과 품질을 지켰습니다.
LangGraph와 Amazon Bedrock, OpenSearch를 결합해 빅데이터 클러스터 장애 대응을 자동화했습니다. 병렬 RCA와 반증 검증으로 진단 품질을 높이고 MTTA를 줄였습니다.

Sentry 대신 필요한 기능만 남긴 작은 에러 트래커를 직접 만들어 운영한 사례를 정리했습니다.재배포 없이 기준을 조정하고 반복 에러만 선별하는 방식의 장단점을 공유했습니다.