
AWS Elemental MediaConvert와 Amazon Bedrock으로 VOD 자동 챕터 생성하기
MediaConvert의 샷 전환 후보와 Transcribe 스크립트를 Bedrock에 제공해 VOD 챕터를 자동 생성했습니다. AI 결과는 코드로 검증하고 썸네일 타일을 활용해 자연스러운 탐색 경험을 구성합니다.
#AWS Elemental MediaConvert#Amazon Bedrock#Amazon Transcribe
100


MediaConvert의 샷 전환 후보와 Transcribe 스크립트를 Bedrock에 제공해 VOD 챕터를 자동 생성했습니다. AI 결과는 코드로 검증하고 썸네일 타일을 활용해 자연스러운 탐색 경험을 구성합니다.
생성형 AI로 파트너사의 제안서 작성부터 담당 부서 연결까지 지원하는 AI 비즈센터를 구축했습니다. 다단계 검색과 사용자 확인 절차로 부서 매칭 정확도를 83.72%까지 개선했습니다.

AWS에서 Teamcenter Simulation을 운영해 PLM·시뮬레이션 데이터를 연결하는 방안을 소개했습니다. 확장성, 보안, 고가용성, GPU 스트리밍 기반의 운영 이점을 설명합니다.

Teamcenter Simulation과 AWS ParallelCluster를 결합한 클라우드 HPC 시뮬레이션 구조를 소개했습니다. 공유 스토리지와 Slurm으로 데이터 추적성, 탄력적 확장, 비용 최적화를 지원합니다.

분산된 VoC 지식과 코드 조사를 자동화하는 AI 에이전트 ‘민붕이’의 설계·운영 사례를 소개했습니다. MCP 기반 단일 서버 구조에 보안·검증·비용 통제를 적용해 실무 투입 가능성을 높였습니다.

한화오션은 조선소 소음과 전문 용어 문제를 해결하기 위해 AWS 기반 AI 통번역 앱 OTalk을 도입했습니다. 현장 데이터 학습과 Bedrock 보정, 격리된 인프라로 번역 품질과 활용 범위를 높였습니다.
AWS HPC 인스턴스에서 WRF 실행 시간과 총비용을 비교해 최적 구성을 검증했습니다. hpc7g 10노드가 가장 경제적이었고, hpc8a는 hpc6a 대체 가능성을 보였습니다.
AWS PCS는 Slurm 컨트롤러 운영을 AWS에 맡겨 HPC 클러스터의 패치·장애 대응 부담을 줄입니다. 추가 관리 요금은 가동률, 커스터마이징 요구, 중단 손실을 포함한 TCO로 판단해야 합니다.

상품명 분석을 세밀하게 조정하기 위해 MeCab-Ko와 Lucene Nori 기반 커스텀 플러그인을 빌드했습니다. Amazon OpenSearch Service에 연결해 기본 Nori와 토큰화·검색 결과를 비교했습니다.

게임 개발 조직에 Kiro를 도입하며 실무 챔피언과 Steering 파일 중심의 확산 전략을 적용했습니다. Spec·MCP 연동으로 활용 범위를 넓히고, 리뷰와 테스트 체계의 중요성도 확인했습니다.

Amazon Bedrock AgentCore로 사내 데이터 연결·에이전트 실행·공유를 통합한 AX 플랫폼을 구축했습니다. MCP, 승인 워크플로, 사용량 관측으로 보안과 재사용성을 강화했습니다.
GS에너지는 SMUS와 Bedrock AgentCore를 결합해 프로젝트 구독 기반 데이터·에이전트 플랫폼을 구축했습니다. JWT·IAM·MCP의 권한 경계를 분리해 사용자 권한 내 데이터 조회를 구현했습니다.

AWS에서 VLA·강화학습용 Physical AI 학습, 시뮬레이션 검증, 엣지 배포 파이프라인을 구성했습니다. 학습 특성에 따라 SageMaker Pipelines·HyperPod를 선택하고 Greengrass로 모델을 배포합니다.
무븐트는 AWS 이벤트 기반 파이프라인으로 댄스 영상을 구조화된 학습 데이터로 변환했습니다. GPU 추론과 API를 분리한 다중 계층 서빙으로 성능과 확장성을 개선했습니다.
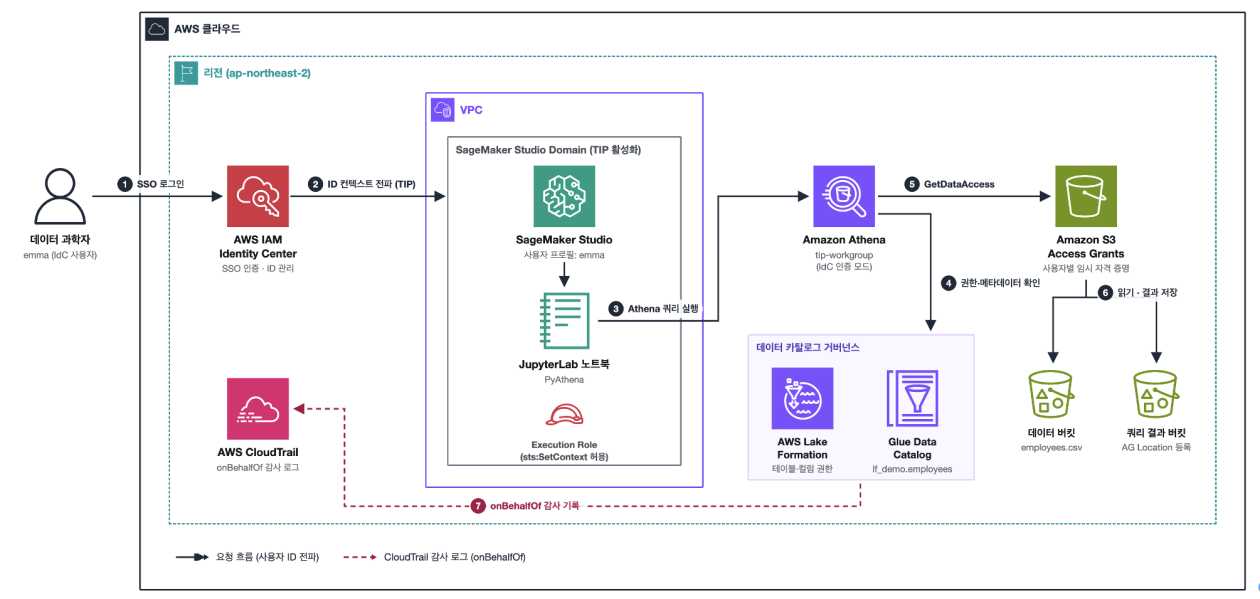
SageMaker Studio의 TIP로 사용자 ID를 Athena·S3·Lake Formation까지 전파하는 구성을 안내했습니다. S3 Access Grants와 CloudTrail을 통해 사용자별 권한 제어 및 감사 추적을 구현했습니다.
AWS Elastic Disaster Recovery로 온프레미스 21대 서버의 DR 환경을 구축한 사례를 정리했습니다. 복제, 부팅, 서비스 단계의 이슈와 서버별 복구 목표 설정 과정을 공유했습니다.

Amazon EKS와 NVIDIA FLARE로 연합학습을 구성하는 방법과 CSE 평가 흐름을 설명했습니다. 세 가지 데이터 시나리오를 통해 전역 모델의 수렴, 일반화, 운영상의 관찰 포인트를 보여주었습니다.

Strands Agents와 Bedrock AgentCore로 발전설비 진단 보조 에이전트를 구성한 사례를 소개했습니다. 판단 절차와 데이터 조회를 분리하고 검색·응답을 따로 평가한 점이 핵심입니다.
