
[Databricks] 문서를 신뢰할 수 있는 검색 근거로 준비하는 과정
Databricks 기반으로 문서를 수집·정리·게시하고 AI Search에 반영하는 흐름을 설명했습니다. 최신성, 문맥, 출처, 상태를 분리해 신뢰 가능한 검색 근거를 운영하는 방법을 다뤘습니다.
#Databricks#AI Search#Auto Loader
800
[Databricks] 문서를 신뢰할 수 있는 검색 근거로 준비하는 과정
임베딩 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 3개 · 많이 쓴 회사 노타·데보션·당근마켓
20개 표시
Databricks 기반으로 문서를 수집·정리·게시하고 AI Search에 반영하는 흐름을 설명했습니다. 최신성, 문맥, 출처, 상태를 분리해 신뢰 가능한 검색 근거를 운영하는 방법을 다뤘습니다.
TASTE는 공동학습으로 사용자 표현을 만들고, 예측 확률과 임베딩을 여러 추천·타기팅 모델에 제공합니다. 목적별 모델 분리와 TASTE Bench로 성능 및 전이 효과를 지속 검증했습니다.

크림의 추천 후보 생성에 통합 임베딩과 범용 리트리벌을 적용한 사례를 소개합니다. v2에서 MRL과 Roaring Bitmap으로 지연 시간과 메모리 사용량을 개선했습니다.
벡터 검색 한계를 보완하기 위해 LightRAG와 Neo4j 기반 Navigator를 결합했습니다. 프롬프트·청킹·적재 방식을 개선해 검색 정확도와 대규모 운영 효율을 높였습니다.
스크럼에서 반복되던 유저스토리 작성과 점수 참고 과정을 줄이기 위해 AI 기능을 도입한 과정을 공유했습니다. 생성과 검색을 분리하고, 실제 사용 중 드러난 문제를 바탕으로 구조를 계속 조정했습니다.
벡터DB를 걷어낸 뒤 MySQL과 배치로 유사글 추천을 다시 구현했습니다. Gemini 임베딩과 운영 사고 대응까지 포함해 비용과 안정성을 함께 개선했습니다.

RTZR STT API 전사 결과의 시간 정보와 문단 임베딩으로 자동 챕터를 생성했습니다. C99 기반 경계 탐색과 키워드 기반 대표 발화 선택 과정을 소개합니다.
LLM Wiki 검색을 색인, 본문 임베딩, 요약 임베딩과 FTS5 혼합 방식으로 개선했습니다. 의미 검색과 약어·식별자 정확 검색을 분리해 비용과 검색 품질 문제를 다뤘습니다.

RAG에서 임베딩과 벡터 인덱싱의 원리, 모델 선정 기준, 최적화 기법을 정리했습니다. 특히 한국어 환경에서는 다국어 적합성과 메모리 비용을 함께 검증해야 한다고 설명했습니다.

다국어·다도메인 검색을 위해 BGE-M3를 도메인 파인튜닝하고 128차원 벡터 검색을 적용했습니다. LLM 기반 학습 루프와 임베딩 최적화로 검색 관련성과 CTR을 높였습니다.

한국어 텍스트와 이미지를 함께 처리하는 멀티모달 임베딩 모델 개발기를 소개했습니다. 자연어 기반 사진 검색과 유사 상품 추천 사례를 중심으로 설명했습니다.
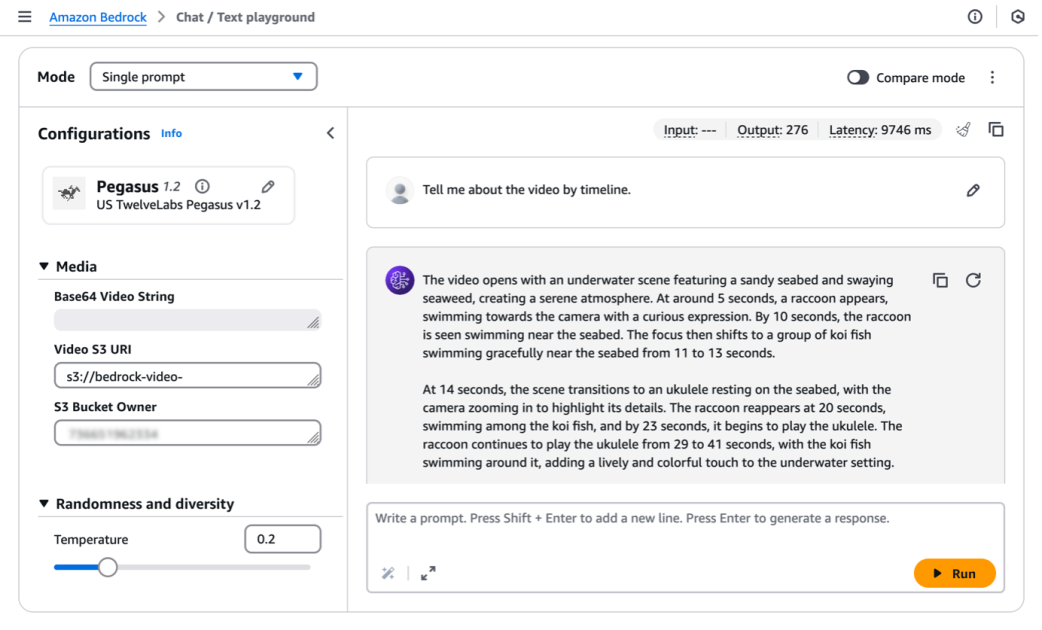
Amazon Bedrock에서 TwelveLabs의 비디오 이해 모델 사용법과 주요 기능을 소개했습니다. 자연어 기반 검색과 요약, 임베딩 생성으로 비디오 분석 애플리케이션을 구축할 수 있습니다.
당근이 AI 실험을 통해 새로운 사용자 경험을 만드는 과정을 소개했습니다. 호기심을 행동으로 바꾸는 설계와 반복 개선의 중요성을 강조했습니다.
LLM으로 중고 스마트폰 게시글에서 시세 산정용 정보를 추출하고 후처리하는 서비스를 구축했습니다. BigQuery, MySQL, 벡터 DB를 조합해 시세 조회와 유사 게시글 추천을 구현했습니다.

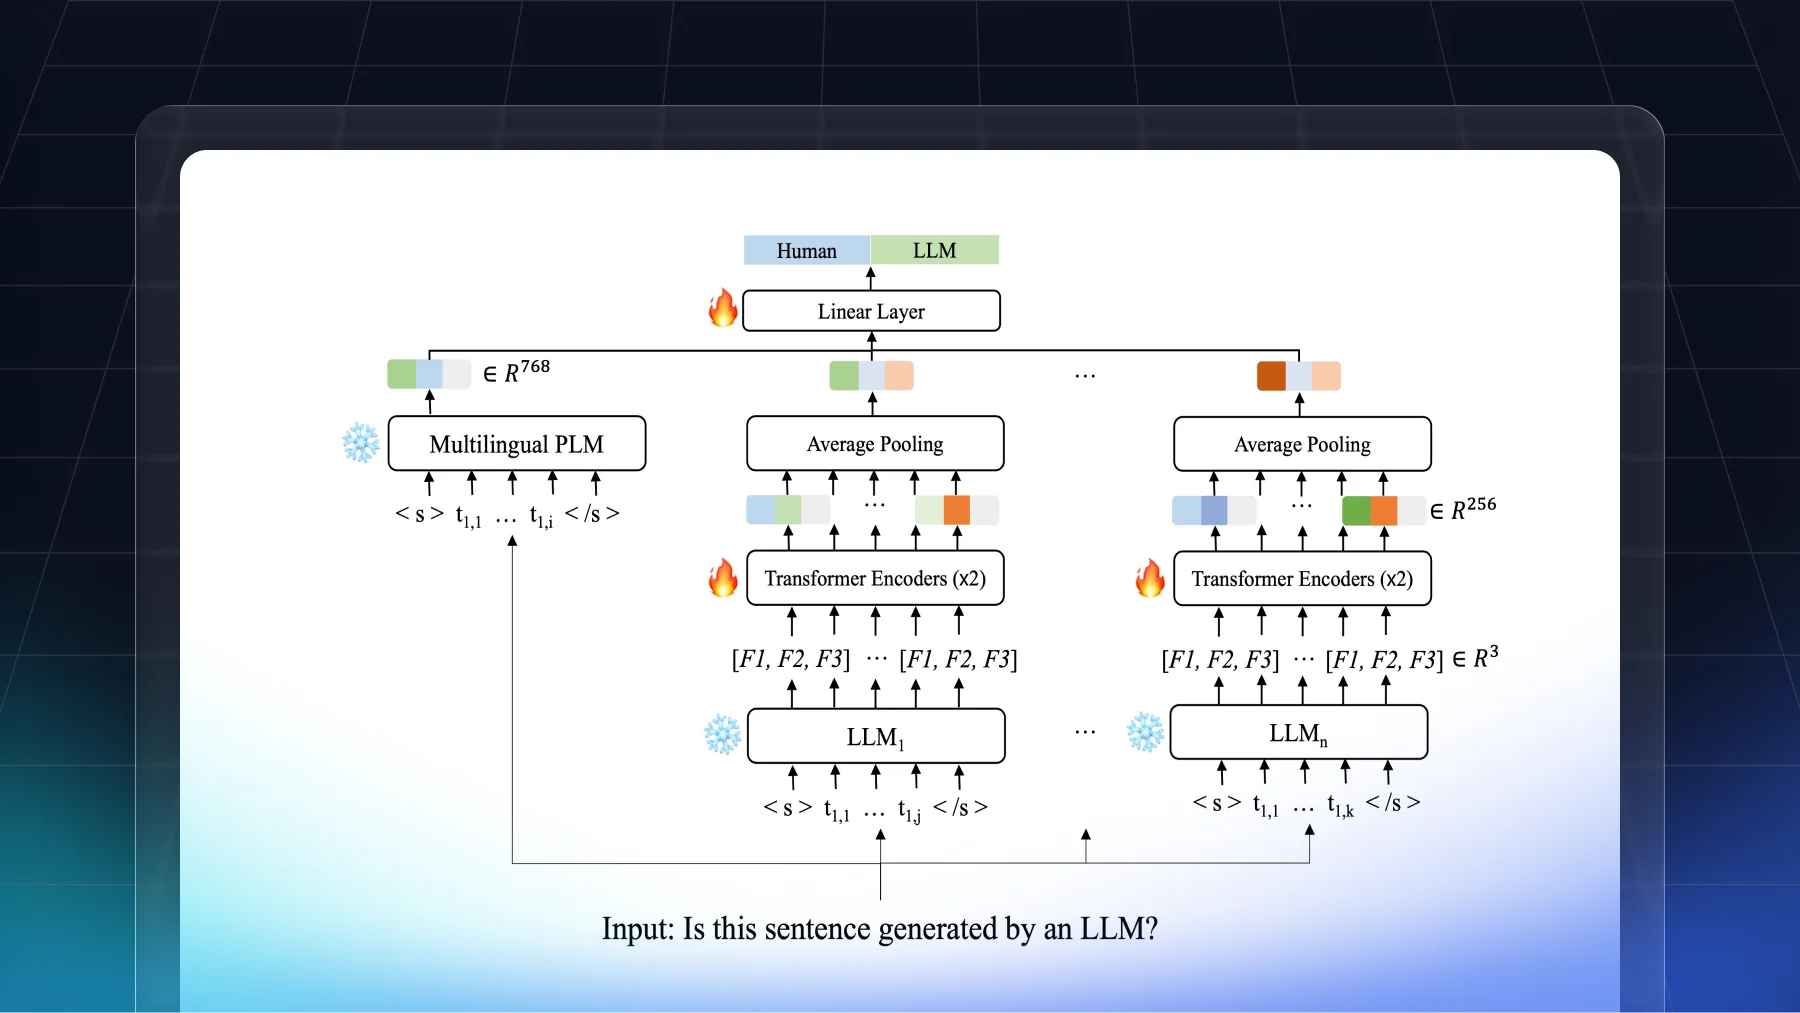
미학습 언어에서 성능이 떨어지는 다국어 LLM 생성 텍스트 탐지 문제를 다뤘습니다. 토큰 확률 분포와 의미 임베딩을 결합해 경진대회 3위를 기록했습니다.
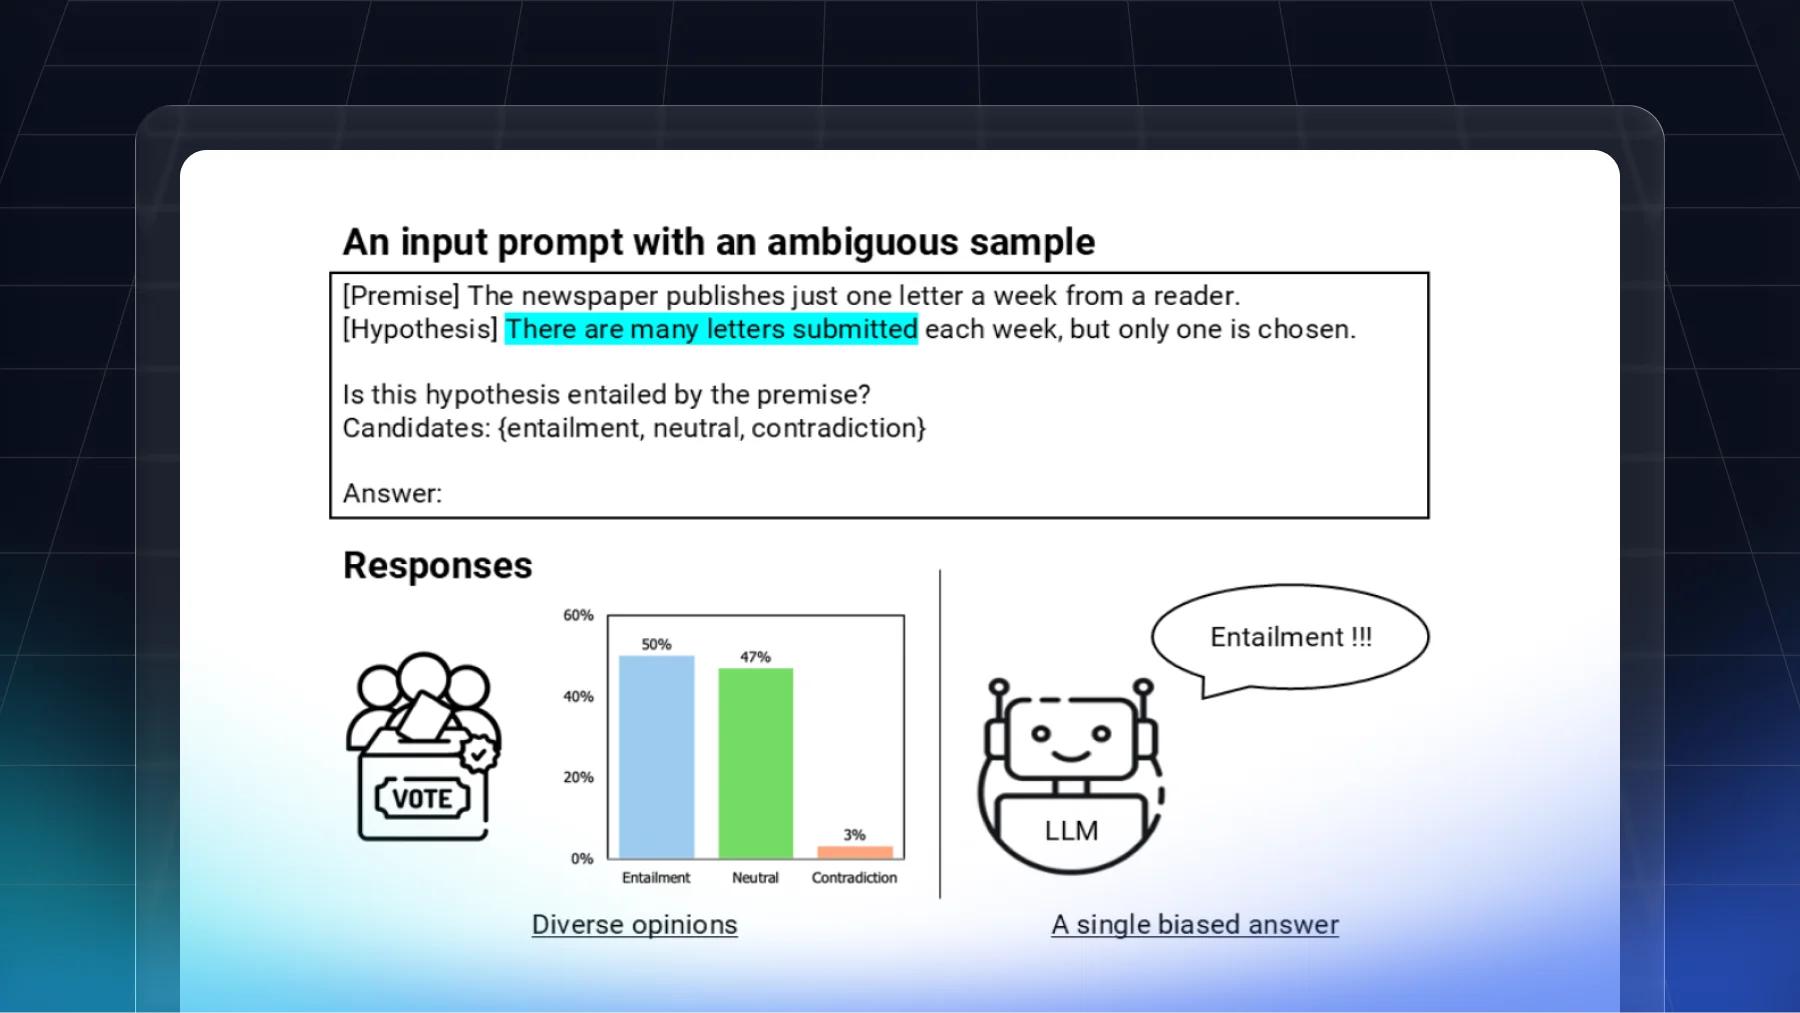
LLM 중간 레이어의 은닉 벡터로 NLU 입력의 애매성을 탐지하는 분류기를 제안했습니다. 최종 레이어보다 높은 탐지 성능을 확인하고, 라벨 부족 대응 학습법을 제시했습니다.
텍스트를 숫자와 벡터로 표현하는 여러 방법과 문장 임베딩 기반 의미 검색을 정리했습니다. 또한 BERT, FAISS, 하이브리드 검색의 구조와 활용 방향을 소개했습니다.

실시간 행동 이력과 위치 정보를 반영하는 추천 시스템의 요구사항을 기술 문제로 풀어냈습니다. 벡터 검색 도입 과정에서 pre filter와 ANN의 한계를 검토하고 후보군 실험을 진행했습니다.

대용량 실시간 임베딩 서버에서 TPS와 응답 속도, 비용 절감을 동시에 맞춘 사례를 소개했습니다. Redis Cluster, 압축, JVM·쿠버네티스 최적화와 성능 테스트 전략이 핵심이었습니다.
실시간 입술 발색 제품 검색을 위해 Vertex AI Matching Engine 기반 벡터 검색 API를 구축했습니다. 인덱스 생성·배포·업데이트 과정과 VPC 연동 시 주의점을 설명합니다.
