AI
다국어 대형 언어 모델 생성 텍스트 탐지 연구
두줄요약
미학습 언어에서 성능이 떨어지는 다국어 LLM 생성 텍스트 탐지 문제를 다뤘습니다. 토큰 확률 분포와 의미 임베딩을 결합해 경진대회 3위를 기록했습니다.
문제 상황
- 미세 조정된 다국어 언어 모델의 학습 언어 내 높은 탐지 성능과 미학습 언어에서의 급격한 성능 저하
- 다국어 환경의 LLM 생성 텍스트와 사람 작성 텍스트 구분 필요성
구조와 흐름
- 입력 언어 판별 후 학습 언어에는 multilingual-e5-large 기반 지도 미세 조정 모델 적용
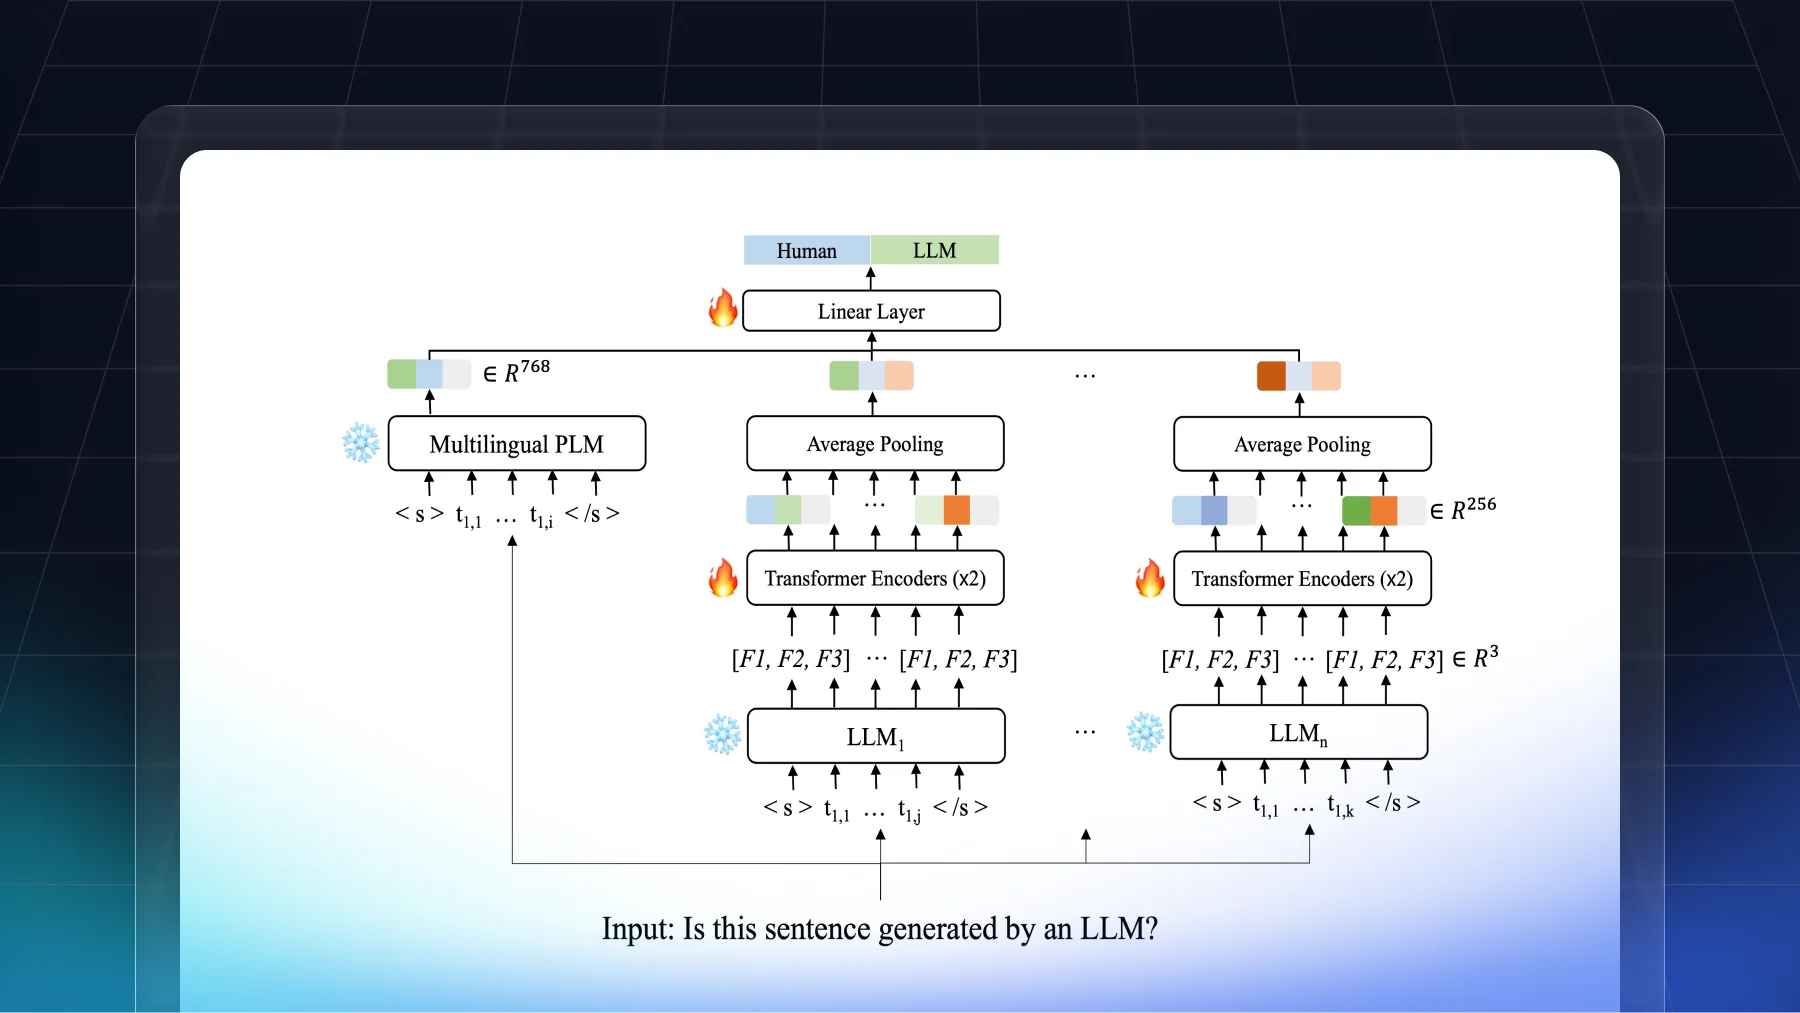
- 미학습 언어에는 Llama, Qwen, Phi 모델의 토큰 예측 로그 확률·엔트로피와 XLM-RoBERTa 의미 임베딩 결합
- 모델별 토크나이저 기반 특징 추출과 단일 특징 벡터 변환 후 분류 모델 입력
성능/운영 포인트
- 의미 임베딩 추가에 따른 개발 데이터셋 F1 점수 0.7114에서 0.7370으로 향상
- DAIGenC Shared Task 1 Subtask B에서 매크로 F1 0.7532, 25개 팀 중 3위
주의할 점
- 입력 언어 오분류에 따른 탐지 오류 가능성
- LLM 특징 추출 과정의 높은 연산 비용과 기준 모델 대비 제한적인 성능 차이