

Scrum AI
스크럼에서 반복되던 유저스토리 작성과 점수 참고 과정을 줄이기 위해 AI 기능을 도입한 과정을 공유했습니다. 생성과 검색을 분리하고, 실제 사용 중 드러난 문제를 바탕으로 구조를 계속 조정했습니다.
#Claude#LLM
3300
새로운 기술 블로그가 추가되었어요
스크럼에서 반복되던 유저스토리 작성과 점수 참고 과정을 줄이기 위해 AI 기능을 도입한 과정을 공유했습니다. 생성과 검색을 분리하고, 실제 사용 중 드러난 문제를 바탕으로 구조를 계속 조정했습니다.


벡터DB를 걷어낸 뒤 MySQL과 배치로 유사글 추천을 다시 구현했습니다. Gemini 임베딩과 운영 사고 대응까지 포함해 비용과 안정성을 함께 개선했습니다.


LLM Wiki 검색을 색인, 본문 임베딩, 요약 임베딩과 FTS5 혼합 방식으로 개선했습니다. 의미 검색과 약어·식별자 정확 검색을 분리해 비용과 검색 품질 문제를 다뤘습니다.


RAG에서 임베딩과 벡터 인덱싱의 원리, 모델 선정 기준, 최적화 기법을 정리했습니다. 특히 한국어 환경에서는 다국어 적합성과 메모리 비용을 함께 검증해야 한다고 설명했습니다.
한국어 텍스트와 이미지를 함께 처리하는 멀티모달 임베딩 모델 개발기를 소개했습니다. 자연어 기반 사진 검색과 유사 상품 추천 사례를 중심으로 설명했습니다.
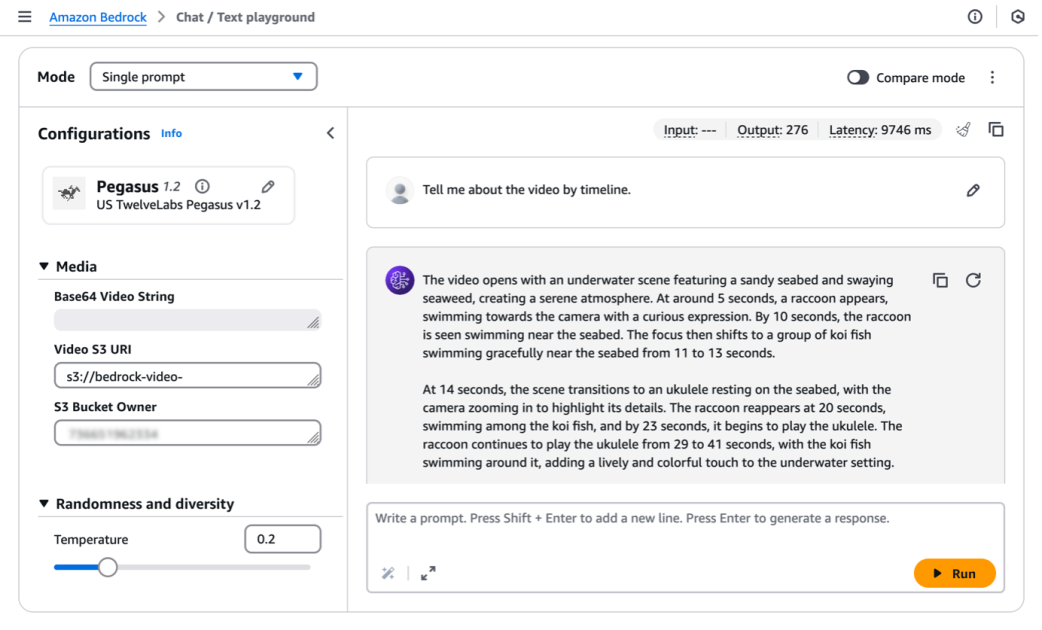

Amazon Bedrock에서 TwelveLabs의 비디오 이해 모델 사용법과 주요 기능을 소개했습니다. 자연어 기반 검색과 요약, 임베딩 생성으로 비디오 분석 애플리케이션을 구축할 수 있습니다.
당근이 AI 실험을 통해 새로운 사용자 경험을 만드는 과정을 소개했습니다. 호기심을 행동으로 바꾸는 설계와 반복 개선의 중요성을 강조했습니다.

LLM으로 중고 스마트폰 게시글에서 시세 산정용 정보를 추출하고 후처리하는 서비스를 구축했습니다. BigQuery, MySQL, 벡터 DB를 조합해 시세 조회와 유사 게시글 추천을 구현했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

텍스트를 숫자와 벡터로 표현하는 여러 방법과 문장 임베딩 기반 의미 검색을 정리했습니다. 또한 BERT, FAISS, 하이브리드 검색의 구조와 활용 방향을 소개했습니다.

실시간 행동 이력과 위치 정보를 반영하는 추천 시스템의 요구사항을 기술 문제로 풀어냈습니다. 벡터 검색 도입 과정에서 pre filter와 ANN의 한계를 검토하고 후보군 실험을 진행했습니다.
대용량 실시간 임베딩 서버에서 TPS와 응답 속도, 비용 절감을 동시에 맞춘 사례를 소개했습니다. Redis Cluster, 압축, JVM·쿠버네티스 최적화와 성능 테스트 전략이 핵심이었습니다.


실시간 입술 발색 제품 검색을 위해 Vertex AI Matching Engine 기반 벡터 검색 API를 구축했습니다. 인덱스 생성·배포·업데이트 과정과 VPC 연동 시 주의점을 설명합니다.


사용자 임베딩과 Mini Batch K-Means로 관심사별 스타일 묶음을 추천했습니다. A/B 테스트에서 클릭과 콘텐츠 전환율 상승을 확인해 전체 릴리즈했습니다.

게임 행동 로그를 Transformer-Autoencoder로 임베딩해 긴 시퀀스 처리와 GPU 학습 효율을 개선했습니다. 부정사용자 탐지에서 LSTM 기반 임베딩보다 높은 F1 Score를 확인했습니다.