AI
대형 언어 모델은 데이터의 애매성을 어디에서 식별할까?
두줄요약
LLM 중간 레이어의 은닉 벡터로 NLU 입력의 애매성을 탐지하는 분류기를 제안했습니다. 최종 레이어보다 높은 탐지 성능을 확인하고, 라벨 부족 대응 학습법을 제시했습니다.
문제 상황
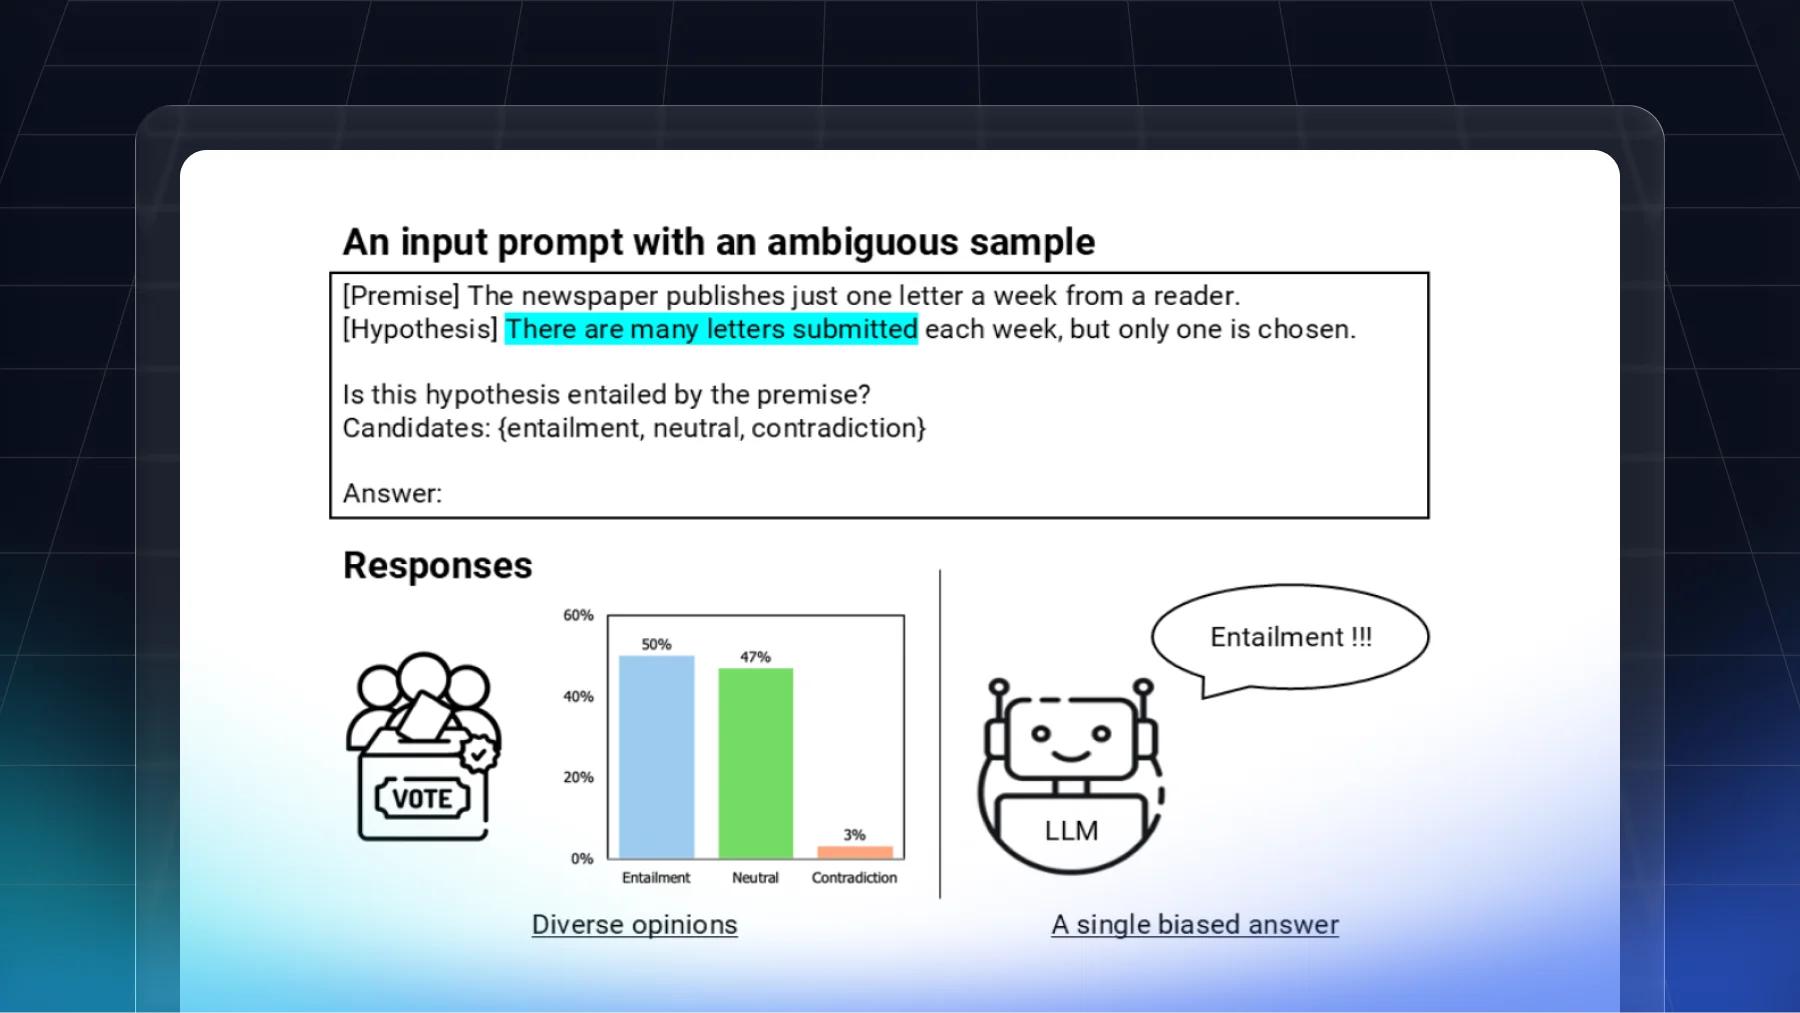
- 다중 정답이나 해석이 가능한 NLU 입력에도 단일하고 편향된 답변을 내놓는 LLM의 신뢰성 문제
- 애매성 여부 라벨이 부족하고, 입력 프롬프트 애매성 탐지 연구의 실용성 한계
구조와 흐름
- GoEmotions, SNLI, MNLI, ChaosNLI의 다중 레이블·주석 분포를 기반으로 애매성 주석 데이터셋 자동 구축
- LLM의 입력 마지막 토큰에 대한 중간 레이어 은닉 벡터를 특징으로 활용한 애매성 이진 분류기 학습
- 학습·평가 프롬프트 템플릿을 다르게 구성한 명령어 기반 LLM 사용 환경 시뮬레이션
성능/운영 포인트
- OPT-IML-1.3B, LLaMA 2-7B, LLaMA 2-13B 실험에서 중간 레이어 표현의 최종 레이어 대비 높은 애매성 탐지 성능
- 감정 분석의 높은 탐지 난이도와 작업·모델별 최적 중간 레이어 차이 확인
- 애매성 라벨 부족 대응을 위한 Training Dynamics 기반 손실 함수 제안
적용해볼 점
- 응답 생성 전 입력 애매성을 평가하고 다중 라벨 분류나 전문가 판단을 안내하는 신뢰성 보완
- 작업별 최적 중간 레이어 자동 선택과 애매성 라벨 자동 생성 연구 필요