MoE란? AI 모델 구조 MoE(전문가 혼합)의 개념·원리·장단점 쉽게 이해하기
MoE의 토큰별 라우팅, 총·활성 파라미터, 밀집 구조 대비 계산 효율을 설명했습니다. 메모리 요구량과 양자화 난점, 이를 줄이는 NMQ 접근도 소개했습니다.
#MoE#LLM#양자화
000
MoE의 토큰별 라우팅, 총·활성 파라미터, 밀집 구조 대비 계산 효율을 설명했습니다. 메모리 요구량과 양자화 난점, 이를 줄이는 NMQ 접근도 소개했습니다.
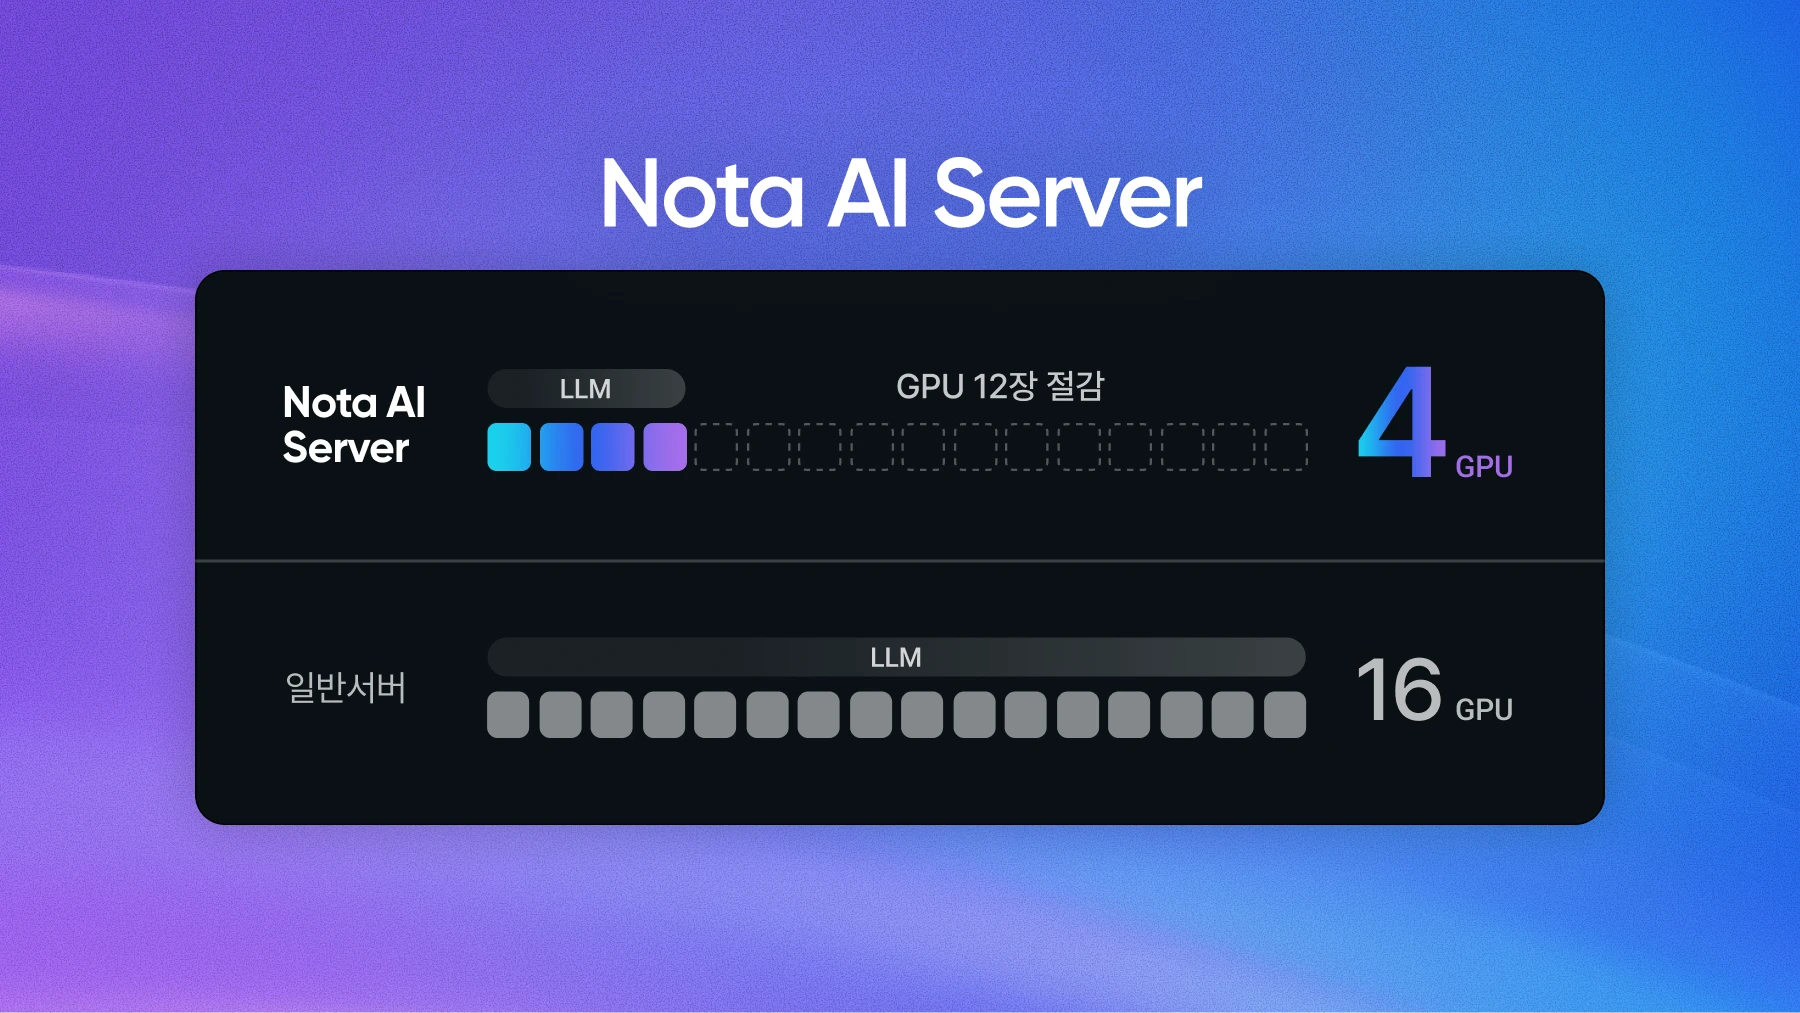
온프레미스 LLM의 GPU 수는 모델 크기뿐 아니라 양자화·가지치기와 KV 캐시 조건을 함께 고려해야 합니다. Nota AI Server는 최적화와 서빙 구성을 사전 검증해 GPU 절감 구성을 제공합니다.
AI 모델 양자화의 비트 축소 원리와 INT8·FP8·NVFP4 포맷 차이를 설명합니다. 메모리 절감 효과와 정확도·하드웨어·캘리브레이션의 고려 사항을 다룹니다.
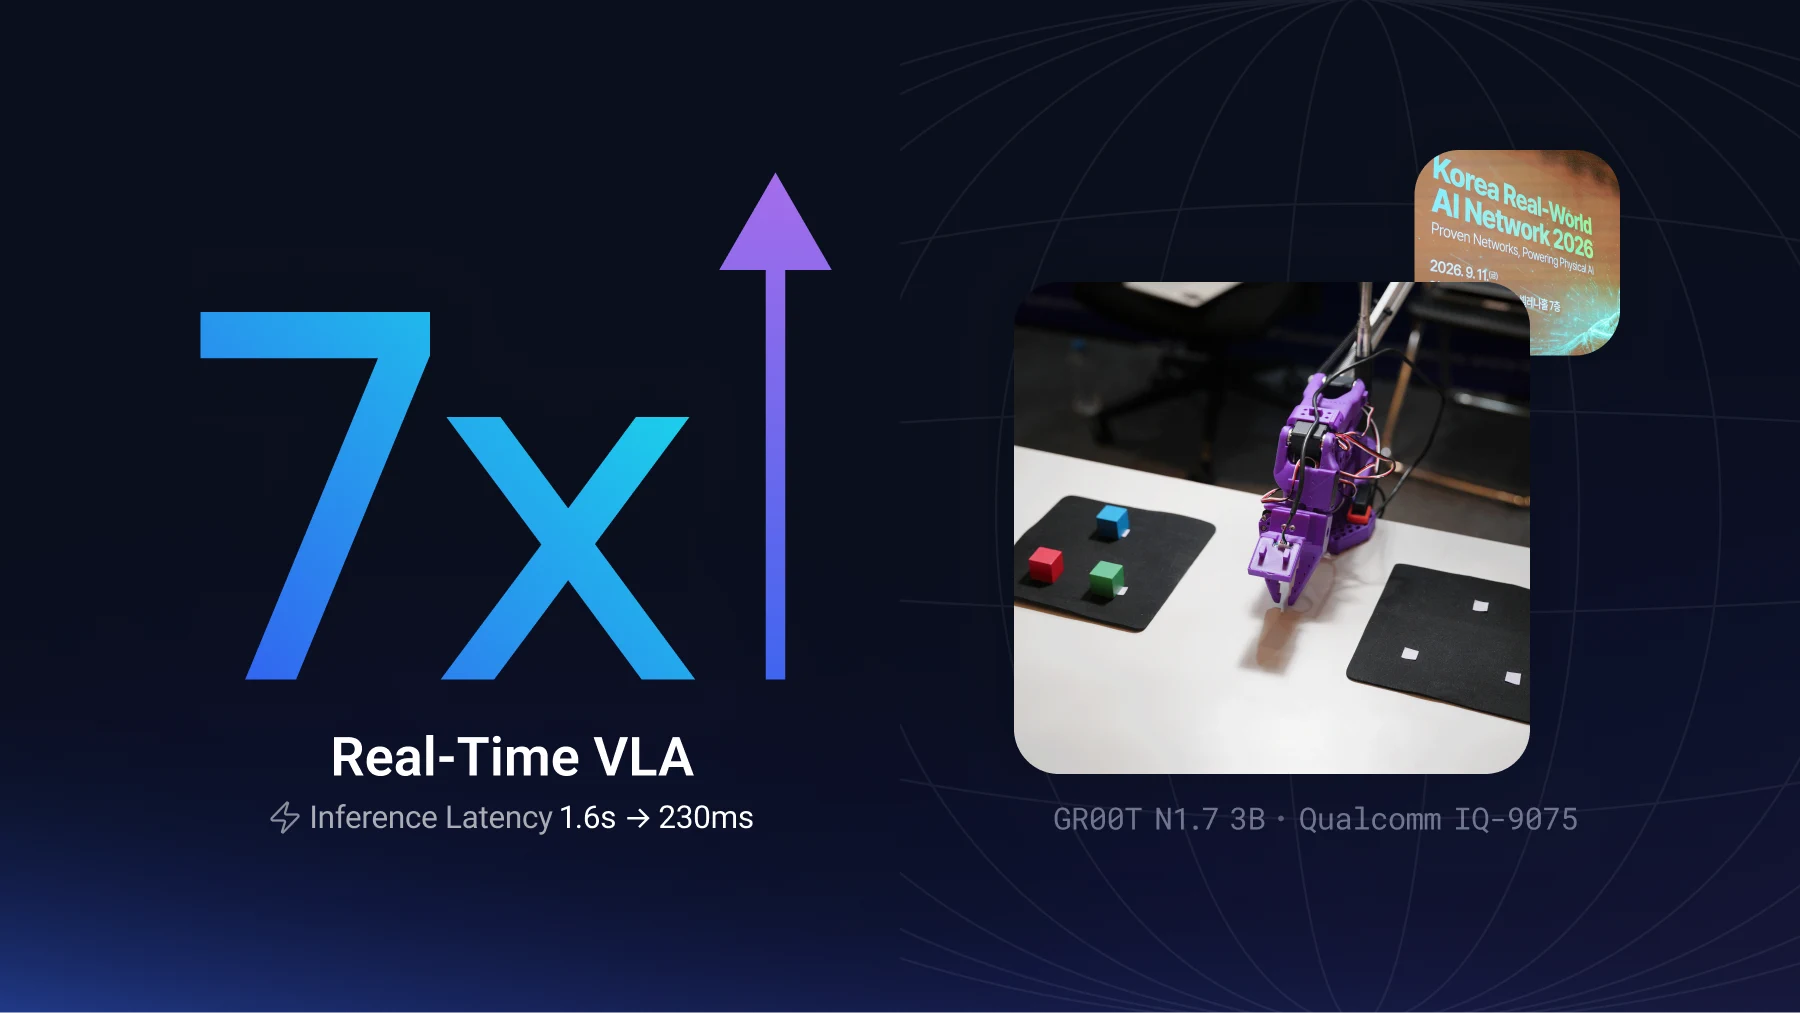
퀄컴 NPU에서 VLA를 실시간 구동하기 위해 백본·런타임·제어 루프를 함께 최적화했습니다. GR00T N1.7을 약 230ms까지 줄이고 RTC로 로봇팔의 연속 동작을 검증했습니다.
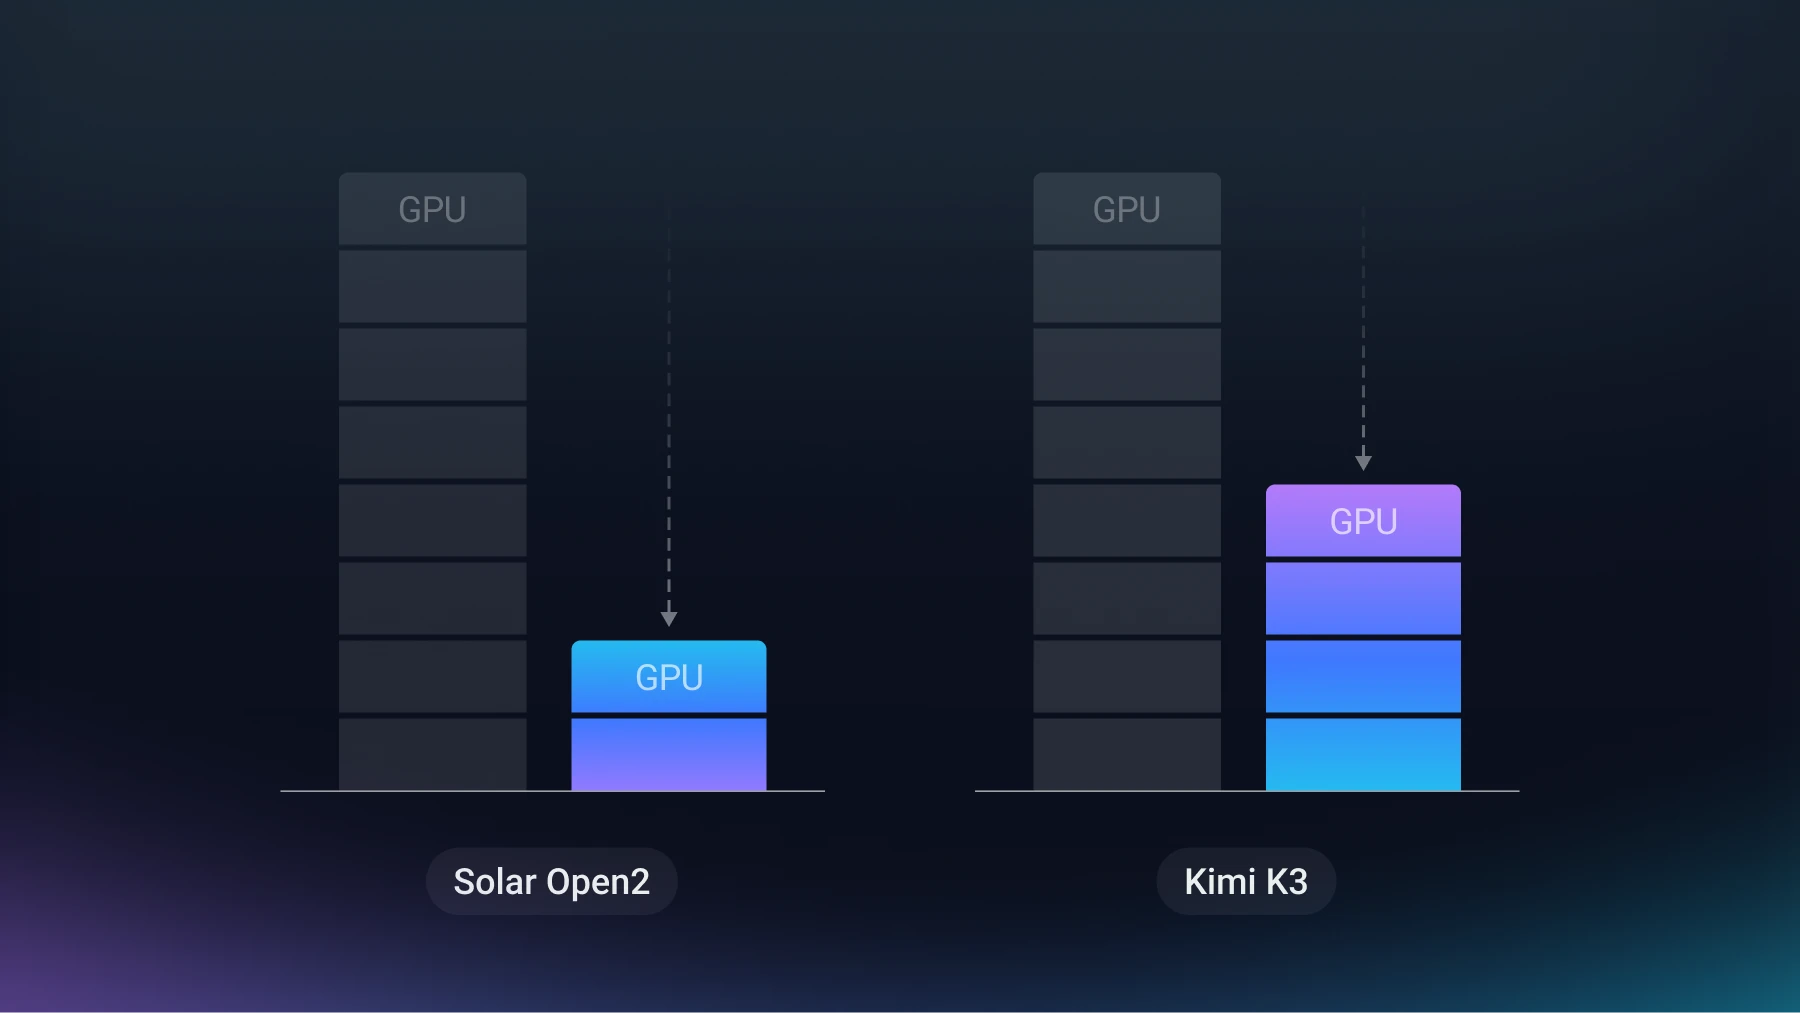
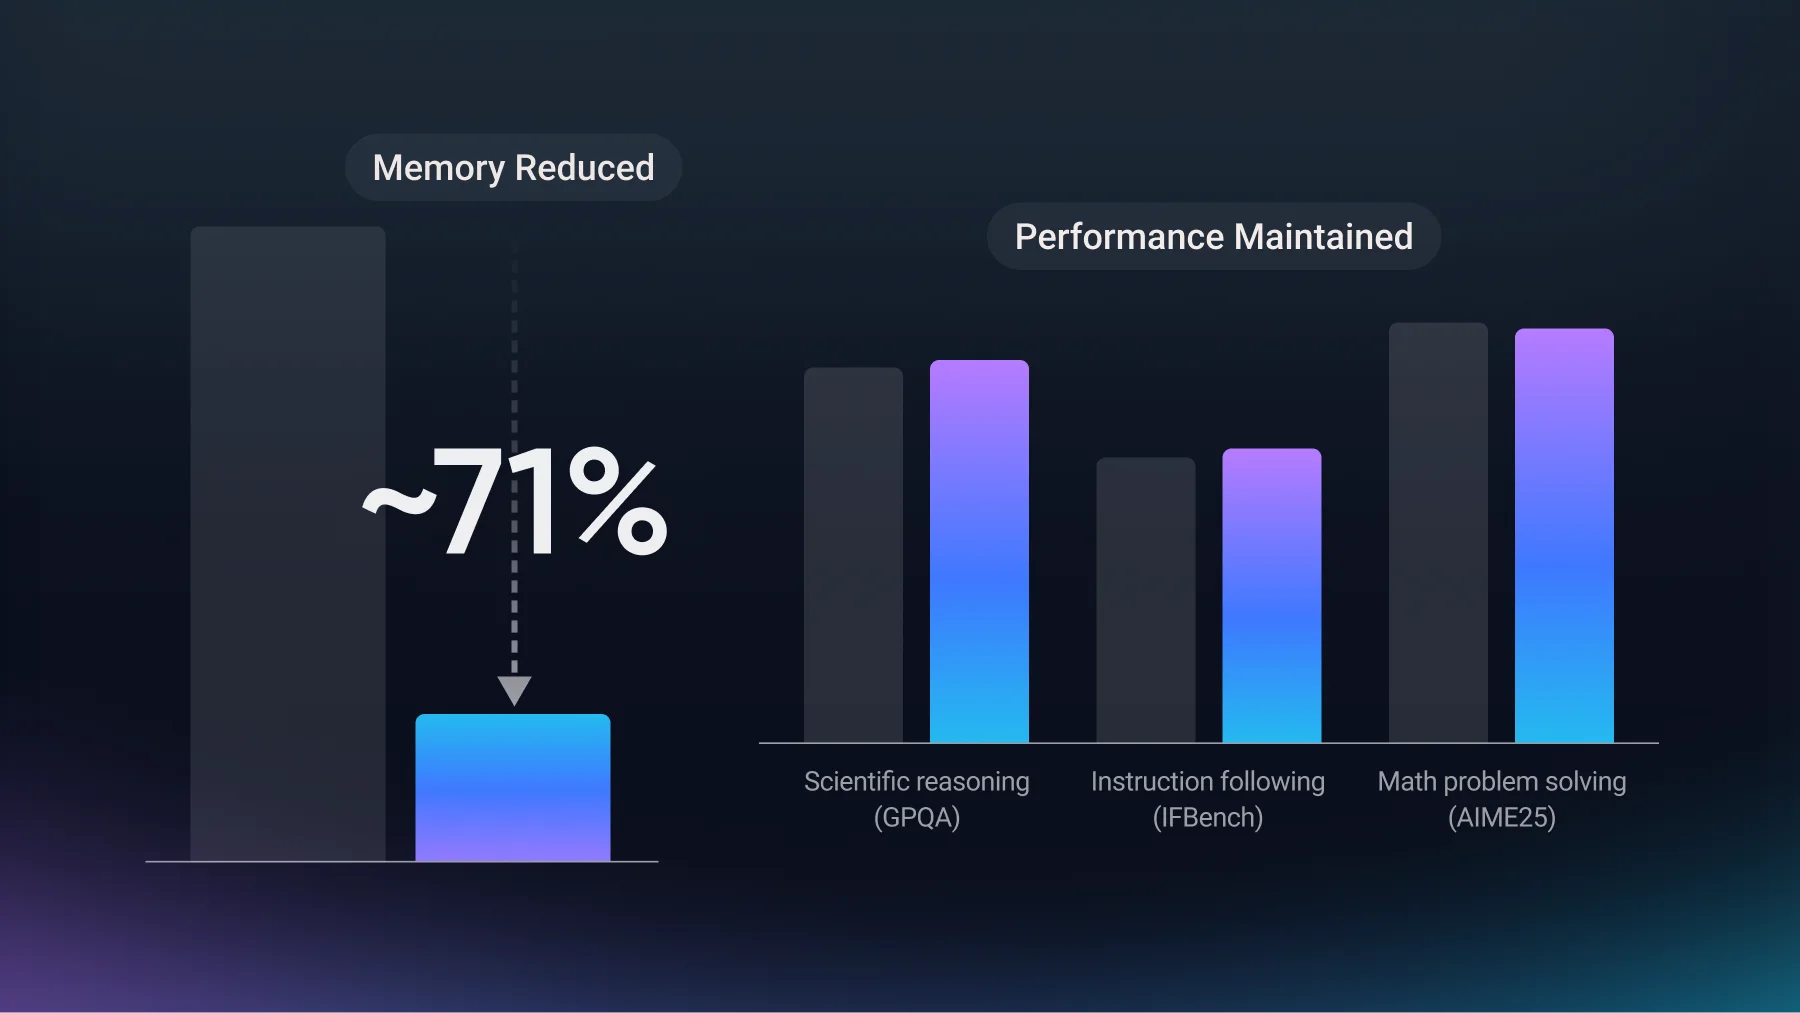
MoE 양자화와 비균일 전역 프루닝으로 LLM 가중치 메모리를 줄이는 사례를 소개했습니다. Solar Open2와 Kimi K3의 GPU 구성 축소 및 벤치마크 결과를 비교했습니다.
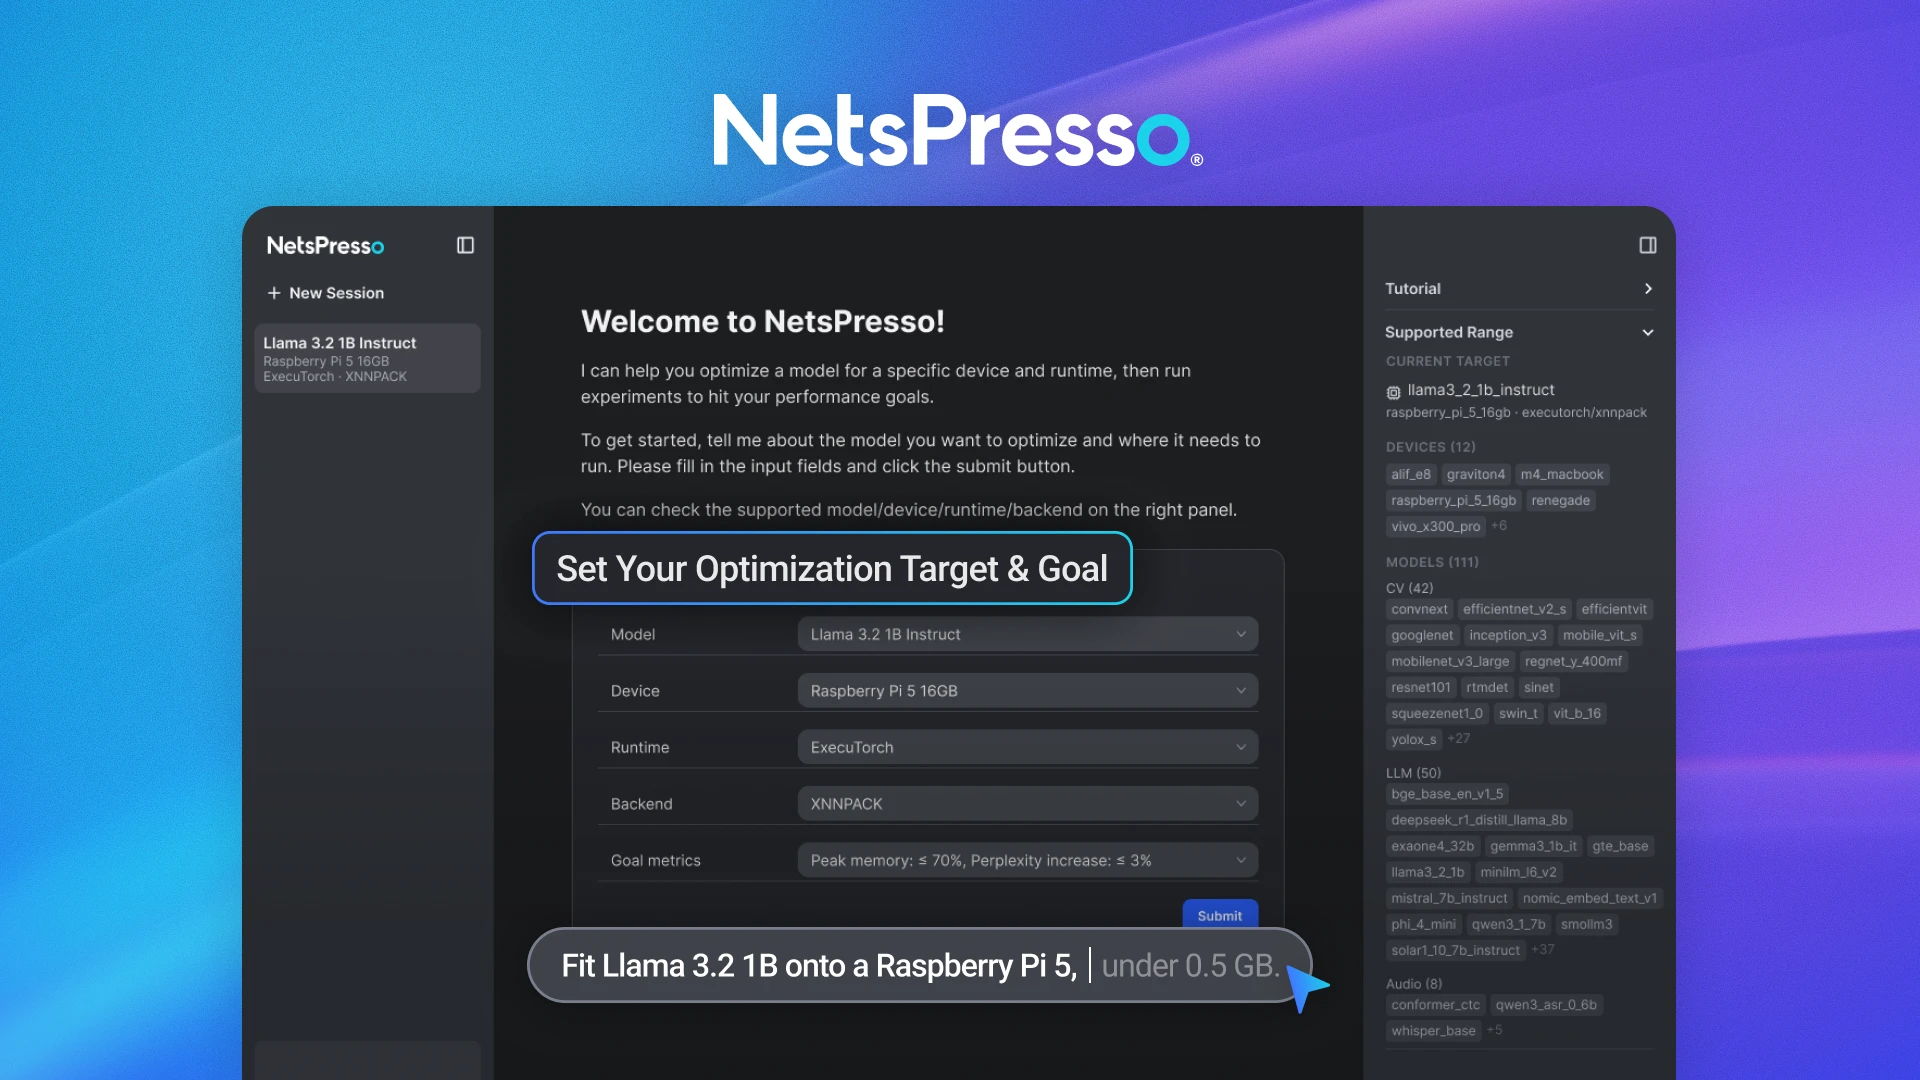
넷츠프레소 에이전트는 자연어 목표를 해석하고 HPO로 모델 최적화 조합을 탐색합니다. 가드레일과 검증으로 재현성을 확보하며 전문가 수준의 결과를 비교했습니다.
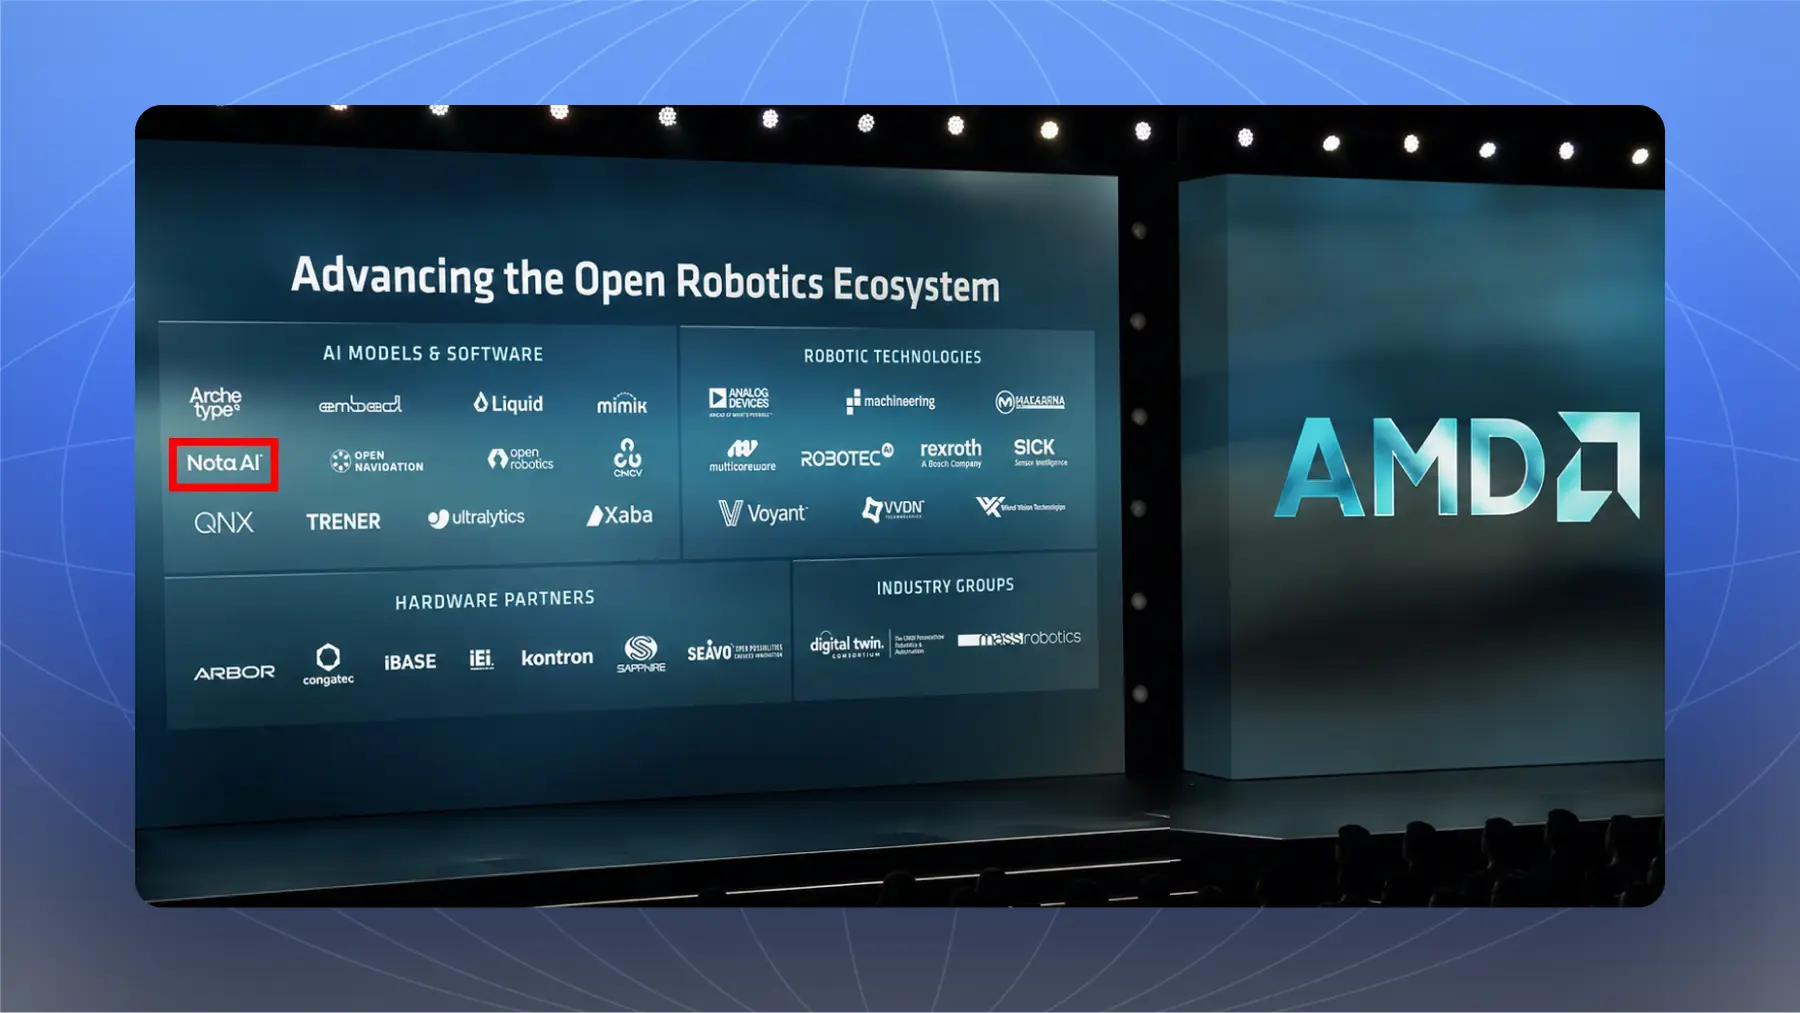
AMD 로보틱스 파트너 네트워크에서 노타의 AI 모델 최적화 역할을 설명했습니다. 로봇용 VLA의 지연 시간을 줄인 온디바이스 추론 사례를 소개했습니다.
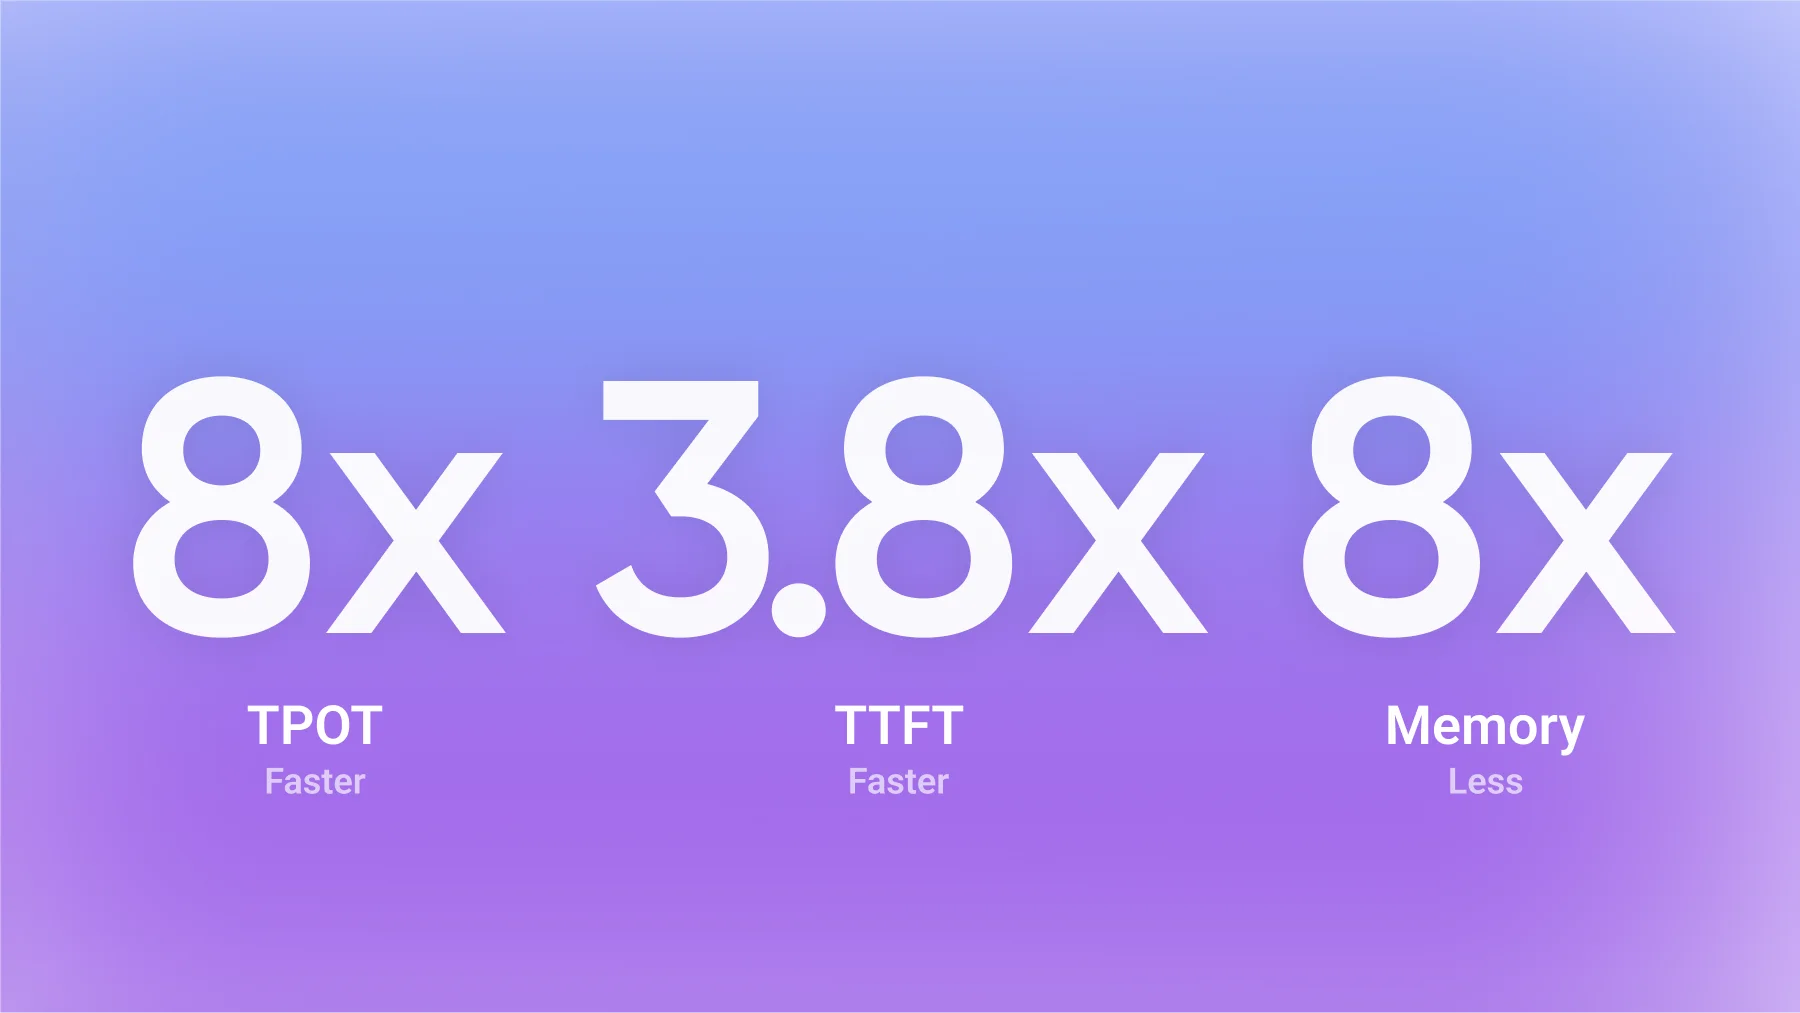
온디바이스 LLM 최적화 경진대회에서 통합 파이프라인 활용 사례를 소개했습니다. 라즈베리파이에서 품질을 유지하며 속도와 메모리를 8배 이상 개선했습니다.
K-EXAONE-236B MoE의 집중 이상치를 오프라인 변환으로 제어해 NVFP4로 양자화했습니다. 추가 커널 없이 vLLM에서 서빙하며 BF16 수준 정확도와 약 3.5배 압축을 제시했습니다.
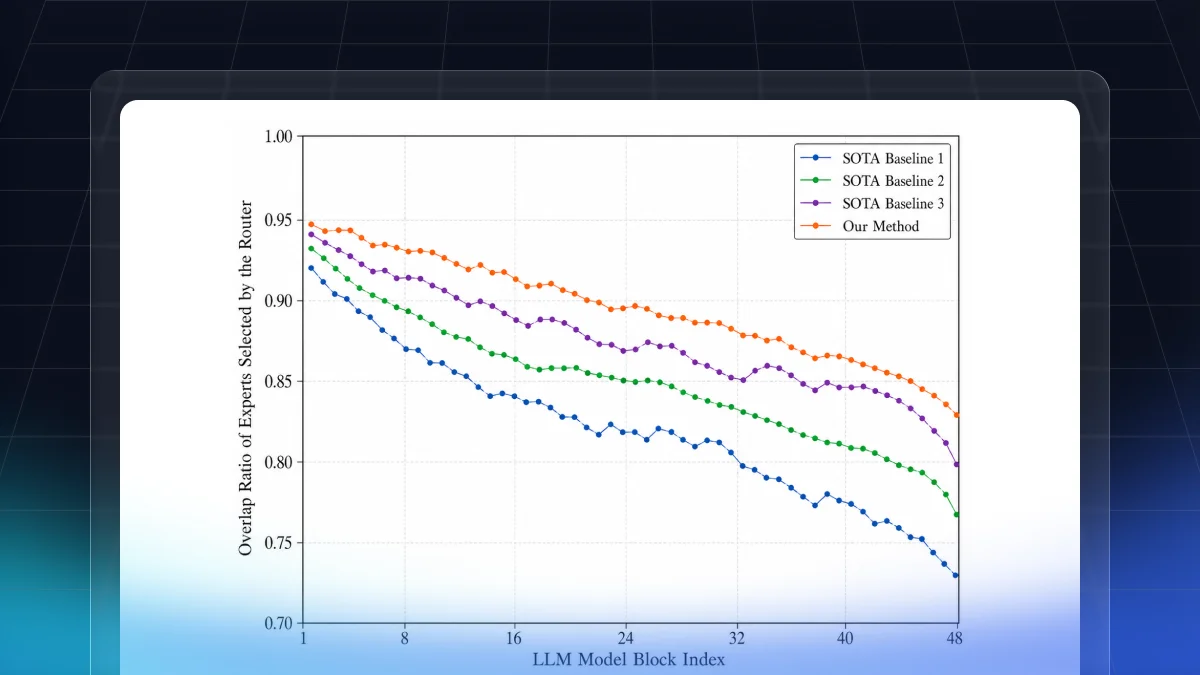
MoE LLM 양자화에서 전문가 선택 경로를 보존하는 두 PTQ 기법을 소개했습니다. 라우팅 마진과 출력 민감 토큰을 활용해 저비트 성능을 개선했습니다.
STK 2026에서 VLA·VLM·온디바이스 LLM의 엣지 최적화 데모를 소개합니다.\n양자화와 추론 효율화로 제한된 하드웨어의 실시간 AI 구동을 다룹니다.
피지컬 AI의 현장 적용을 위해 클라우드 대신 엣지 AI가 필요한 이유를 설명했습니다. 하드웨어 맞춤형 모델 최적화로 VLA 추론 지연을 줄인 사례를 소개했습니다.
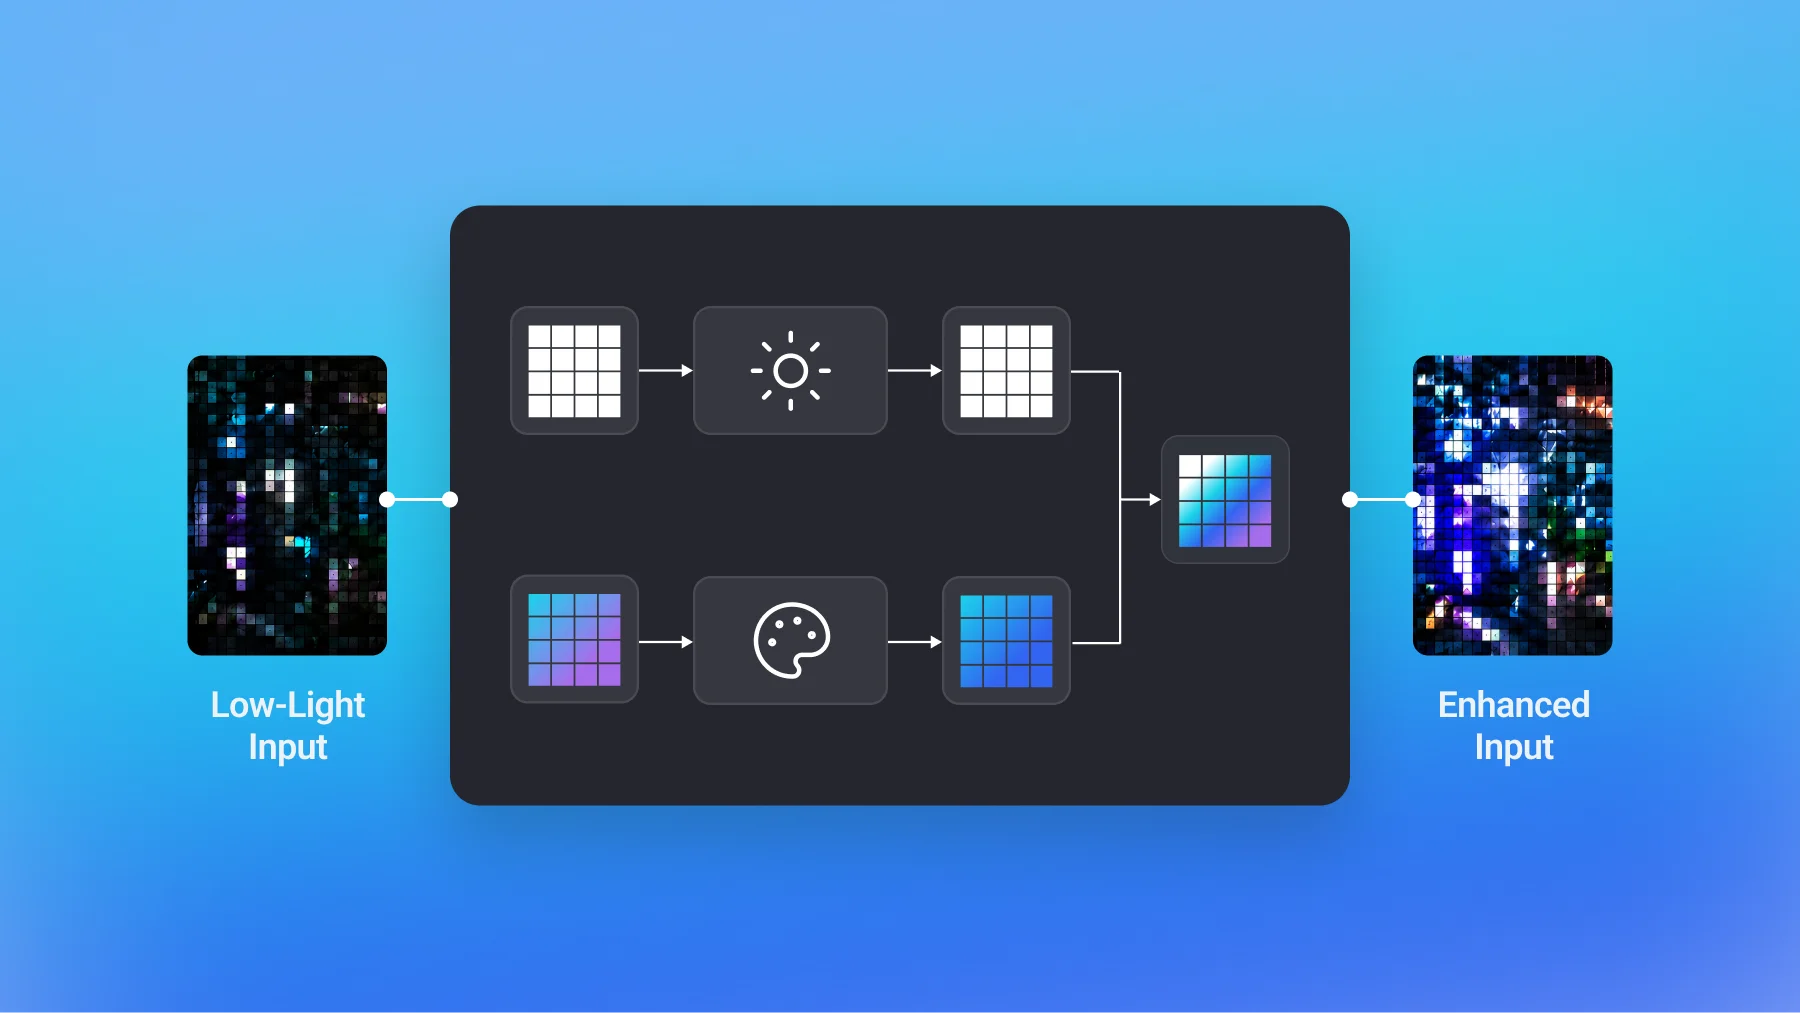
YUV 분리와 경량 DeltaViT 설계로 Jetson Orin NX의 저조도 복원 지연 시간을 400ms에서 28ms 미만으로 단축했습니다. 비참조 화질 지표와 다채널 처리 요구를 함께 검증했습니다.
AI 에이전트 단독 양자화의 비용·검증·디바이스 호환성 문제를 분석했습니다. 넷츠프레소 파이프라인으로 재현 가능한 모델 최적화와 배포를 제안합니다.
Nemotron 해커톤에서 MoE 전문가 활성화와 양자화 민감도를 고려한 합성 데이터 파이프라인을 구현했습니다. 정량 평가와 데모를 바탕으로 Track C 및 종합 1위를 기록했습니다.
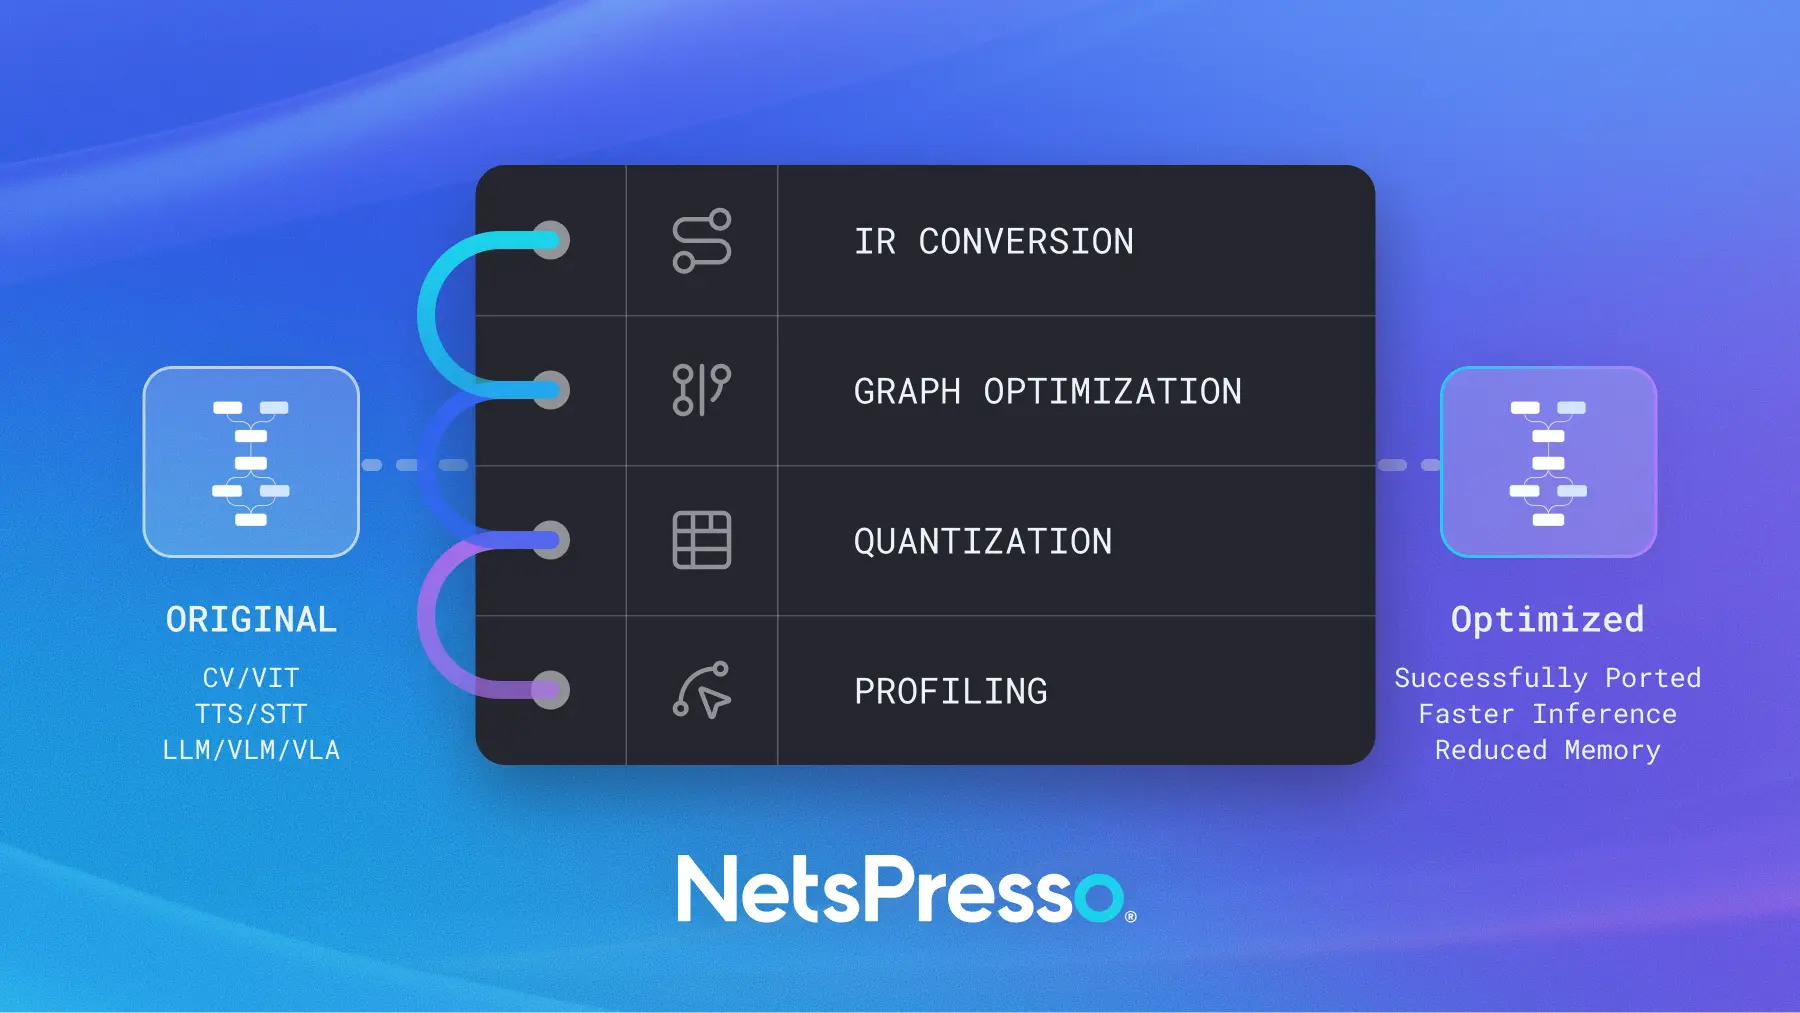
넷츠프레소의 AQ·GO·GQ 기반 모델 배포 파이프라인 구조를 설명했습니다. 양자화부터 그래프 최적화·온디바이스 검증까지의 흐름을 다뤘습니다.
넷츠프레소의 CLI 기반 AI 모델 최적화·배포 파이프라인을 소개했습니다. 양자화 탐색과 시각화로 정확도·지연시간·메모리의 균형을 검증합니다.
TurboQuant의 KV 캐시 양자화가 AI 메모리·전력 효율 경쟁의 핵심 신호임을 분석했습니다. 연구 단계인 만큼 실제 서빙 환경에서의 검증 필요성도 짚었습니다.
GTC 2026의 핵심 흐름을 추론 효율, 에이전틱 AI, 피지컬 AI 관점에서 정리했습니다. 데이터센터와 엣지 환경의 조건별 AI 최적화 과제를 짚었습니다.
생성형 AI의 엣지 실행을 어렵게 하는 동적 모델 구조와 이기종 하드웨어 문제를 설명했습니다. NPIR과 Cross UI로 모델 최적화 실험·측정·분석 과정을 통합하는 방향을 소개합니다.