[넷츠프레소 톺아보기] 모델 최적화부터 타깃 배포까지 한 번에 끝내는 플랫폼
넷츠프레소의 CLI 기반 AI 모델 최적화·배포 파이프라인을 소개했습니다. 양자화 탐색과 시각화로 정확도·지연시간·메모리의 균형을 검증합니다.
#NetsPresso#LLM#양자화
000
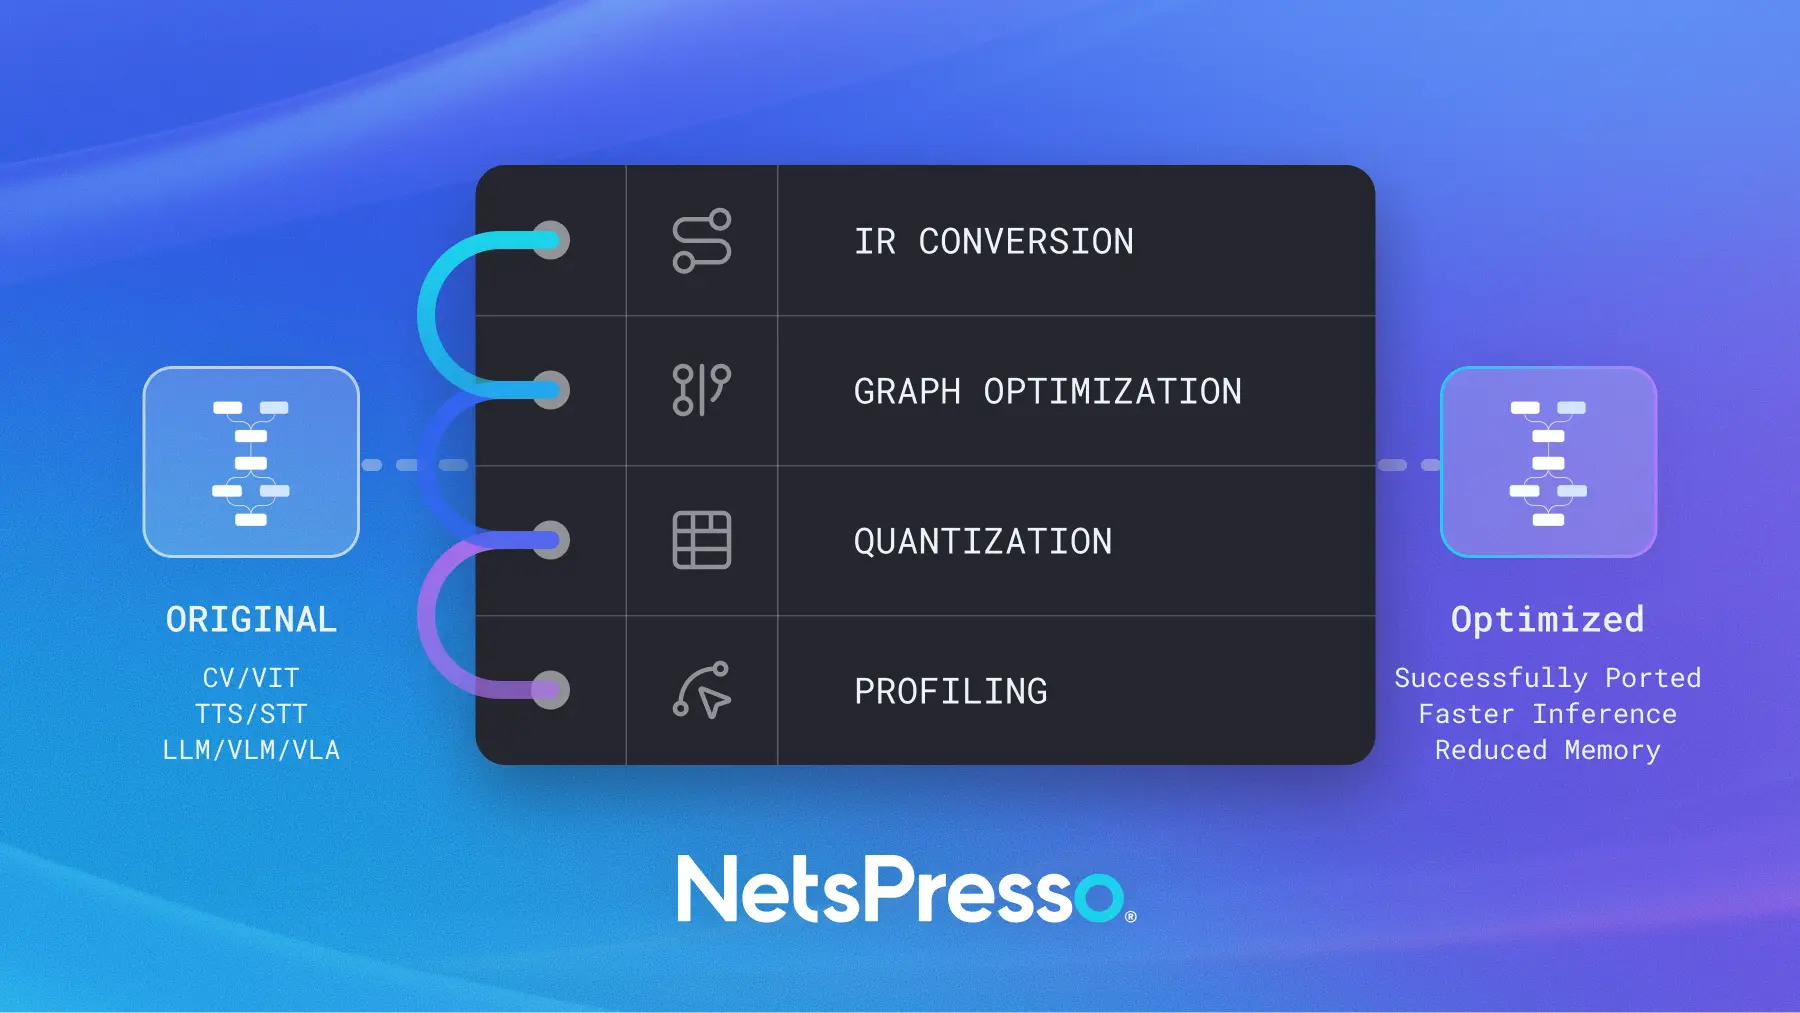
넷츠프레소의 CLI 기반 AI 모델 최적화·배포 파이프라인을 소개했습니다. 양자화 탐색과 시각화로 정확도·지연시간·메모리의 균형을 검증합니다.
TurboQuant의 KV 캐시 양자화가 AI 메모리·전력 효율 경쟁의 핵심 신호임을 분석했습니다. 연구 단계인 만큼 실제 서빙 환경에서의 검증 필요성도 짚었습니다.
GTC 2026의 핵심 흐름을 추론 효율, 에이전틱 AI, 피지컬 AI 관점에서 정리했습니다. 데이터센터와 엣지 환경의 조건별 AI 최적화 과제를 짚었습니다.
생성형 AI의 엣지 실행을 어렵게 하는 동적 모델 구조와 이기종 하드웨어 문제를 설명했습니다. NPIR과 Cross UI로 모델 최적화 실험·측정·분석 과정을 통합하는 방향을 소개합니다.
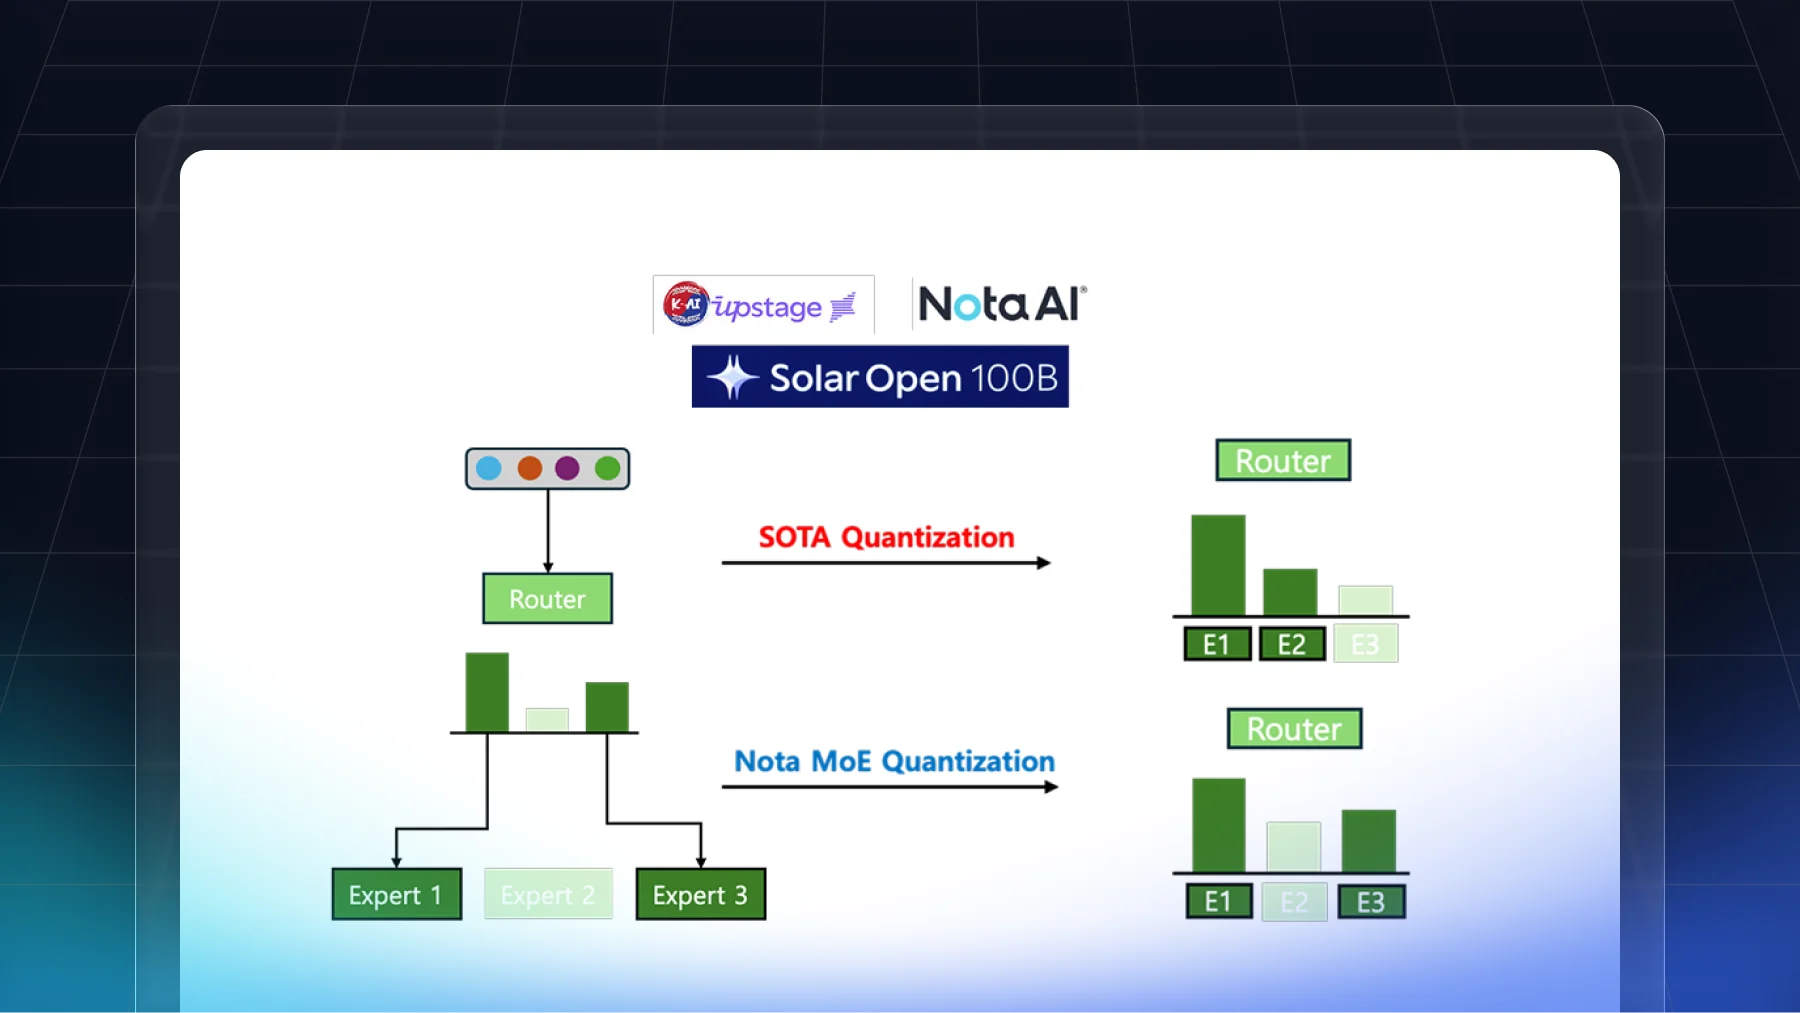
MoE 양자화의 재라우팅 문제를 줄이기 위한 NMQ 손실 함수를 소개했습니다. Solar-Open-100B에서 성능과 라우팅 일치도 개선을 확인했습니다.
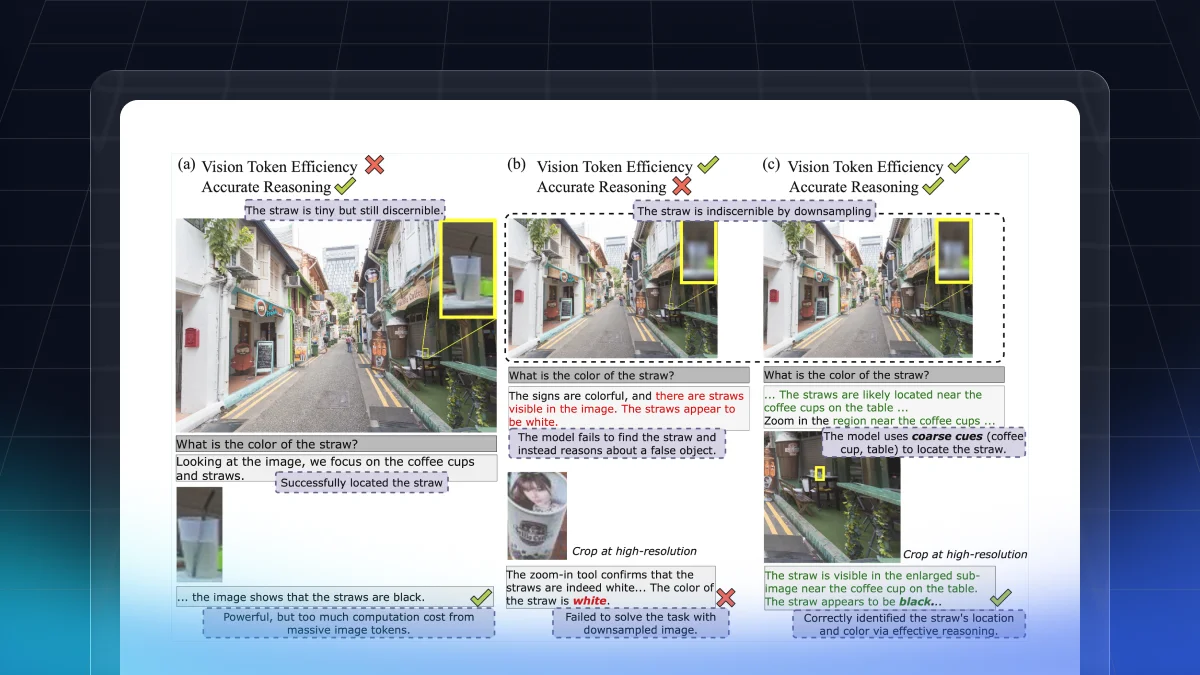
ERGO는 질의와 장면 문맥으로 중요한 영역을 먼저 찾는 2단계 비전-언어 추론을 제안했습니다. 강화학습 보상 설계로 비전 토큰을 줄이면서 정확도와 실제 지연 시간을 개선했습니다.
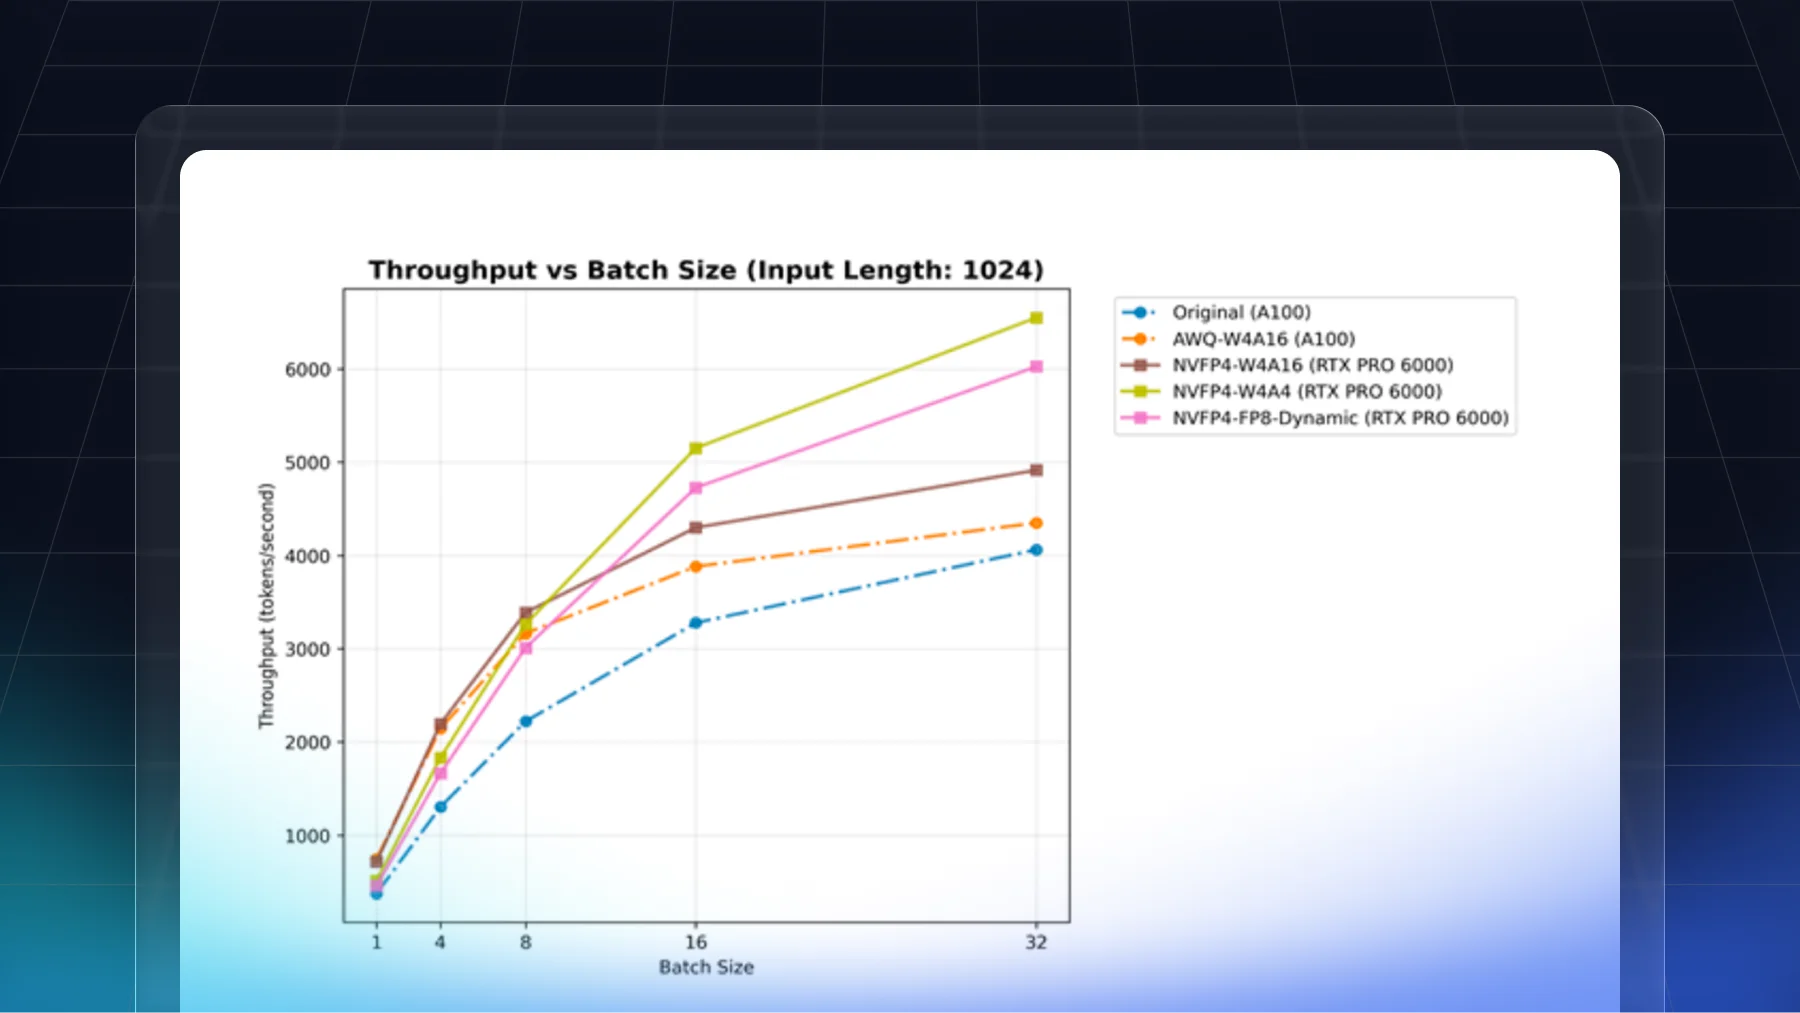
Blackwell용 NVFP4의 2단계 스케일링 구조와 LLM 추론 실측 결과를 분석했습니다. RTX PRO 6000에서 A100 대비 최대 2배 처리량과 미미한 정확도 차이를 확인했습니다.
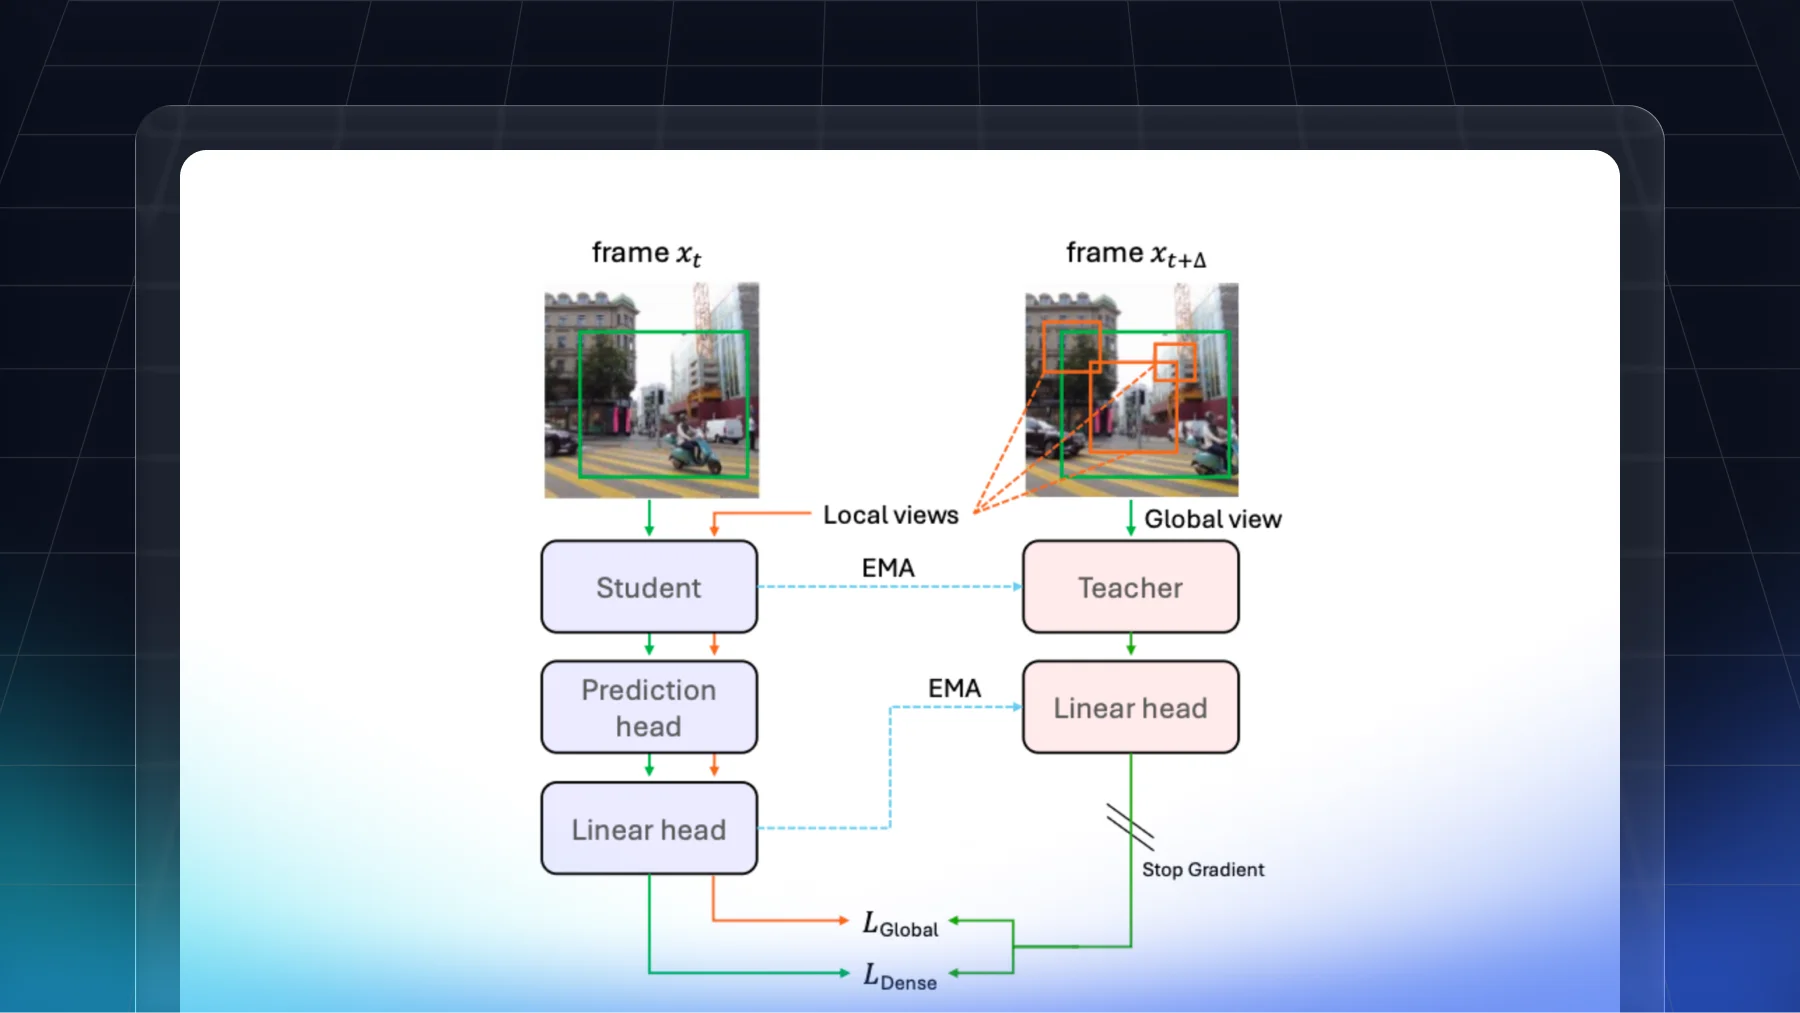
다음 프레임 예측과 EMA 교사를 결합한 비디오 자기지도학습 프레임워크를 제안했습니다. 광류·객체 추적 없이 ADE20K 분할과 COCO 검출 성능을 높였습니다.
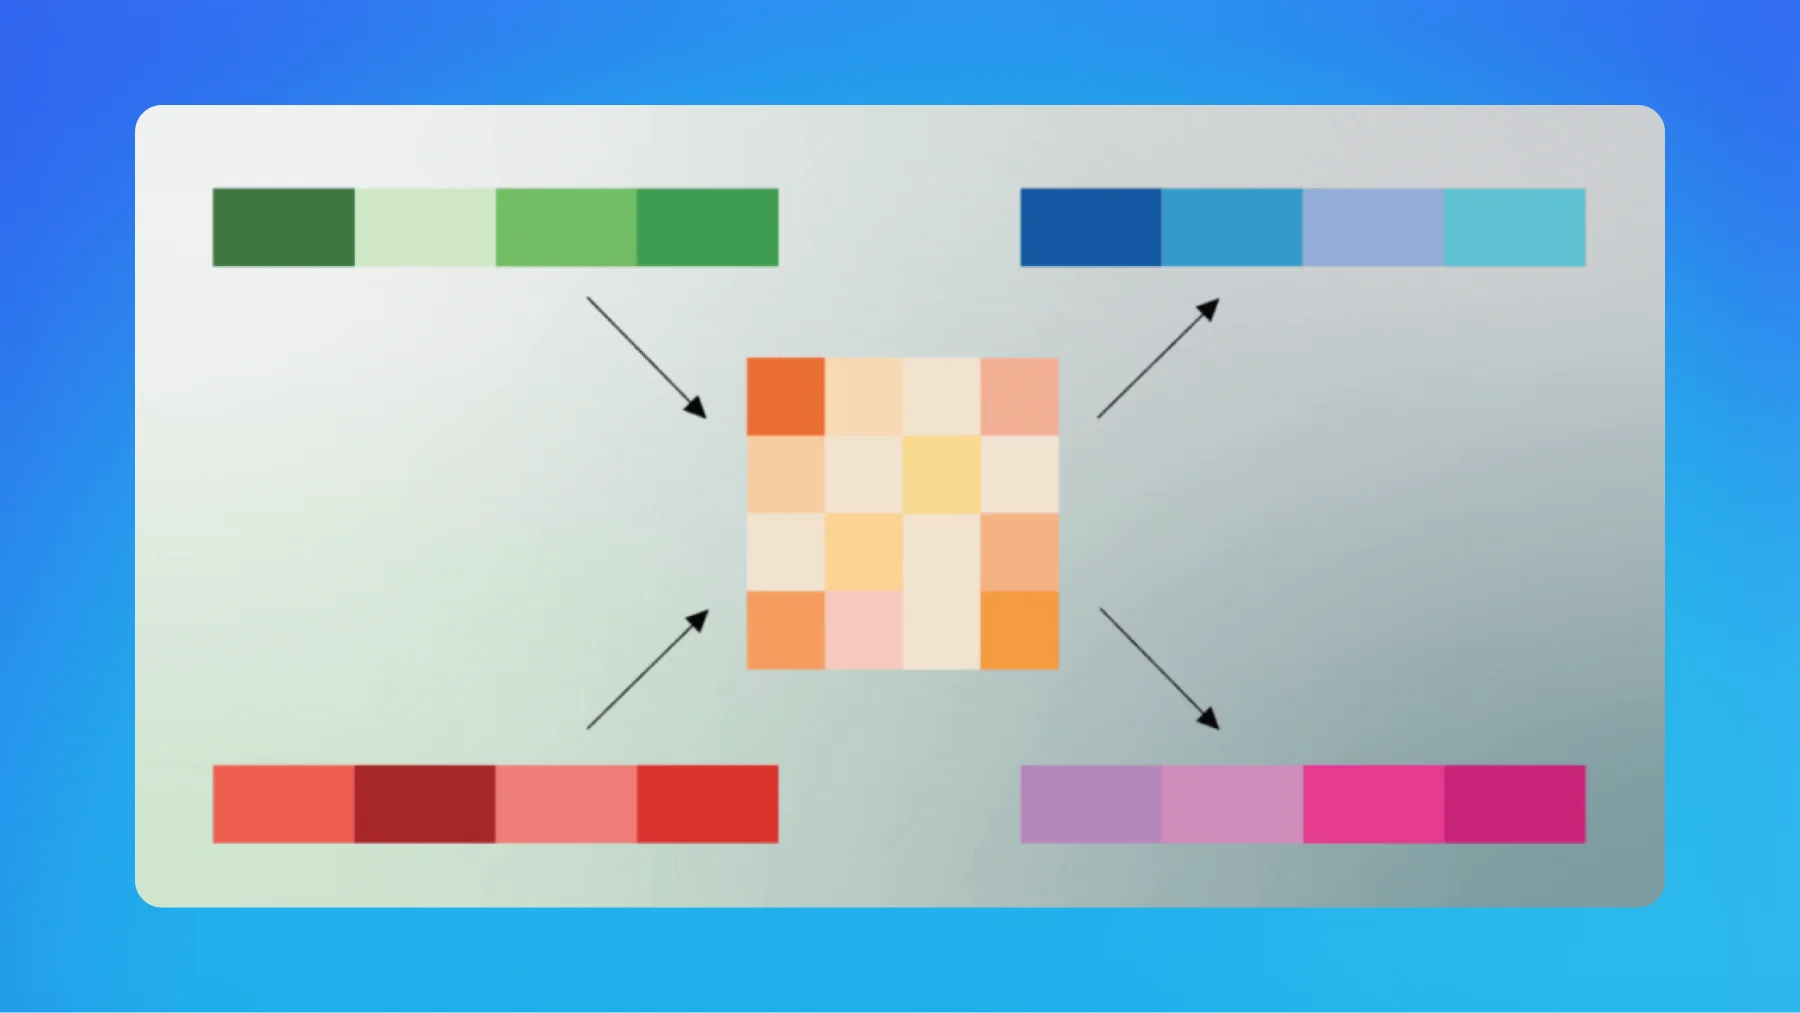
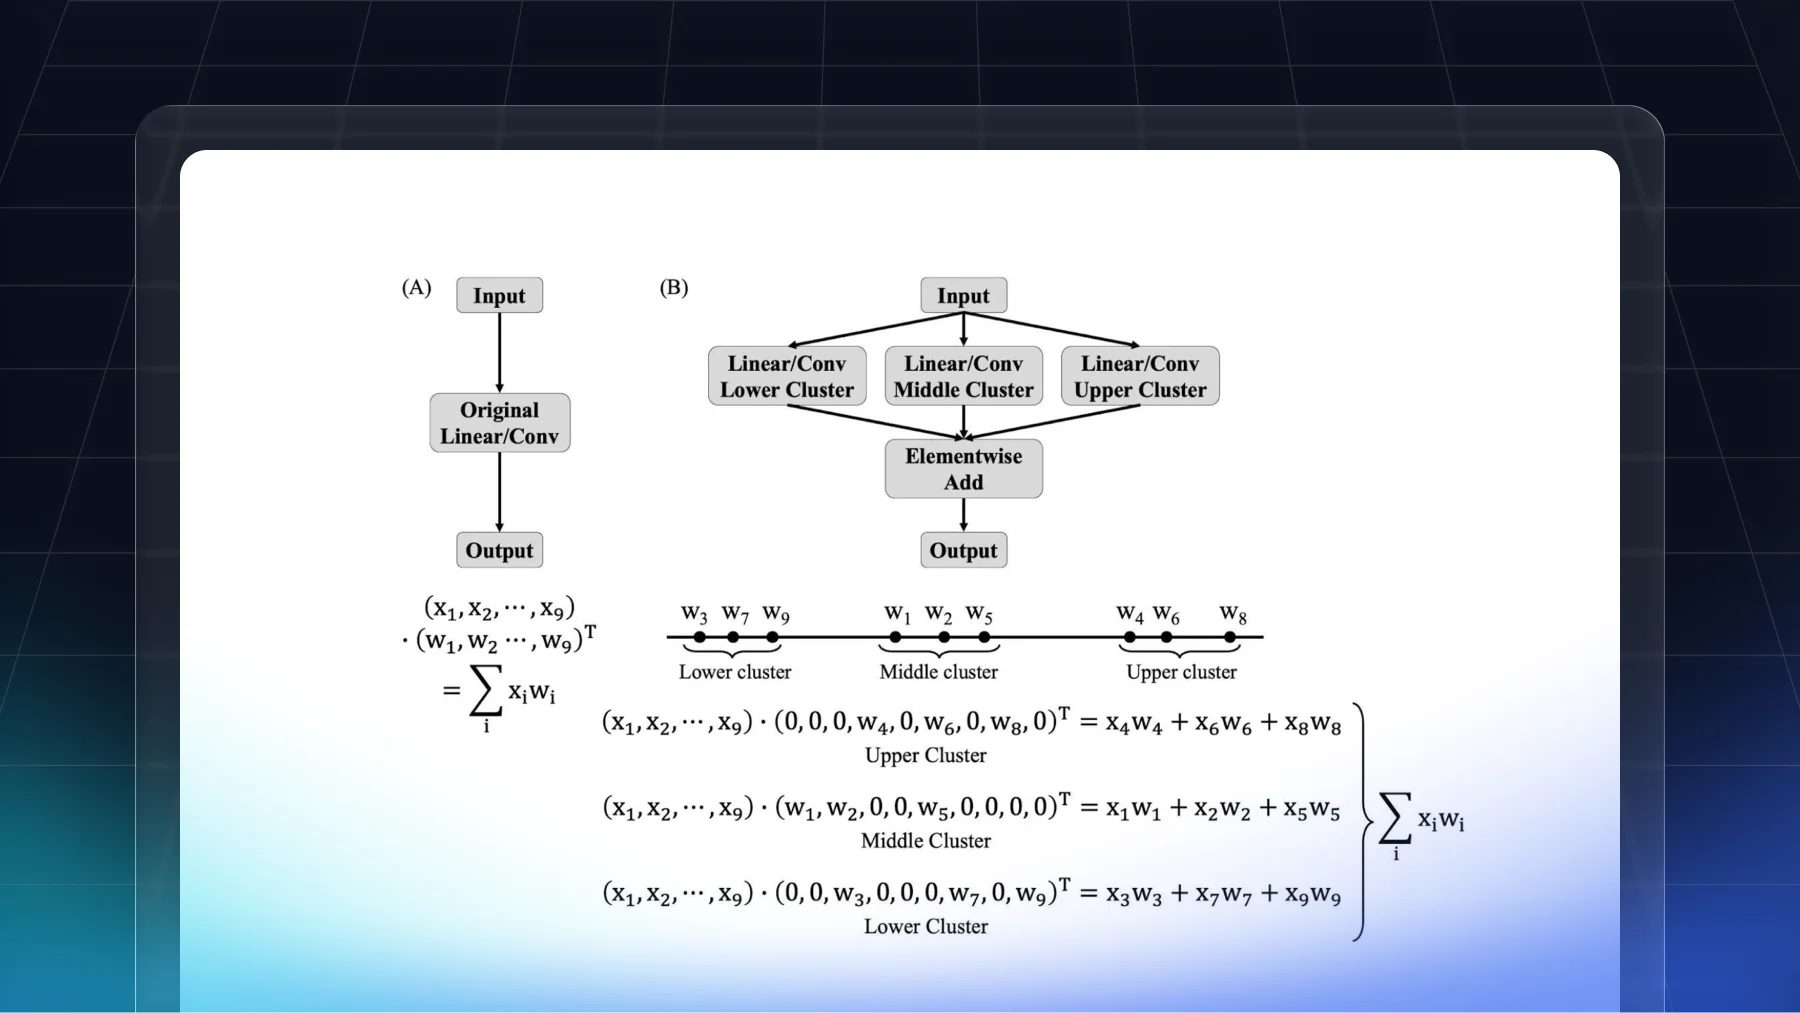
SplitQuant는 레이어를 클러스터 기반으로 분할해 저비트 양자화의 이상치 영향을 줄였습니다. BERT-Tiny 실험에서 INT2 정확도를 FP32 수준에 가깝게 향상했습니다.
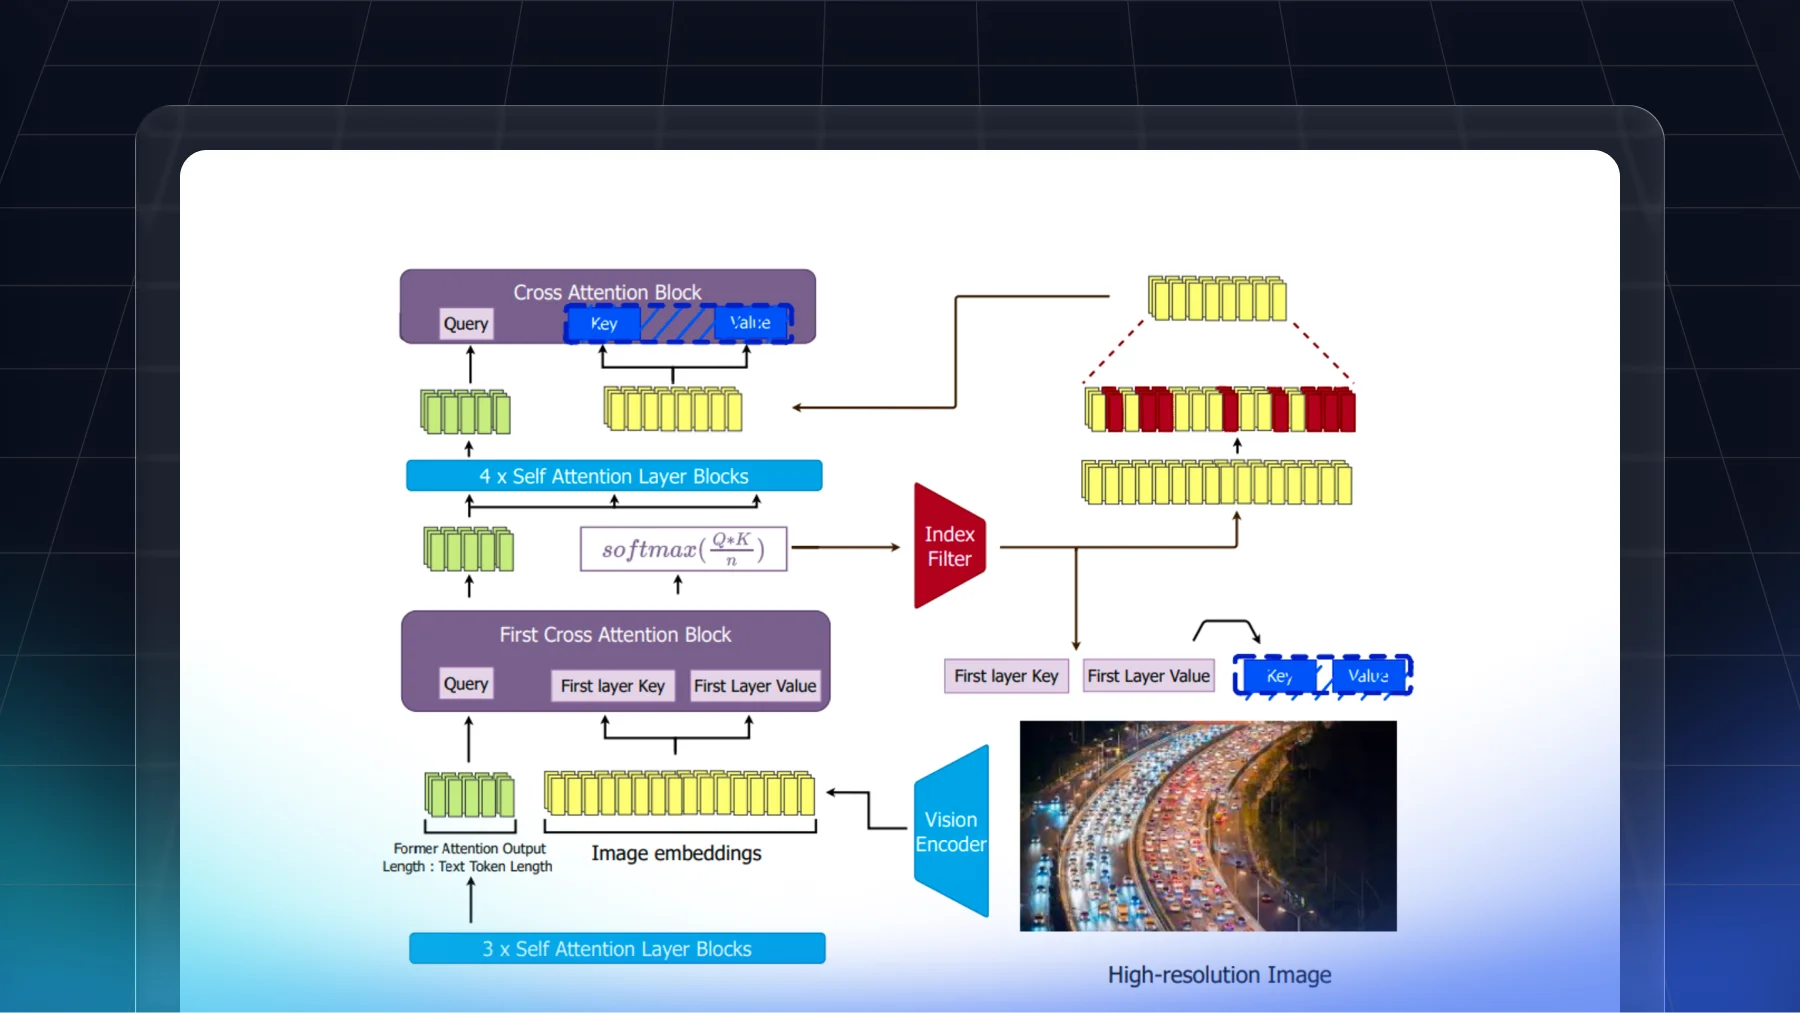
크로스 어텐션의 희소성을 활용해 LLaMA-3.2-Vision의 불필요한 시각 토큰을 제거했습니다. 성능을 유지하며 KV 캐시, 메모리 사용량, 추론 지연을 줄였습니다.
UniForm은 공유 어텐션 행렬로 다중 헤드 어텐션의 중복 계산과 메모리 사용량을 줄였습니다. 엣지 환경에서 정확도와 빠른 추론 속도를 함께 달성한 결과를 소개합니다.
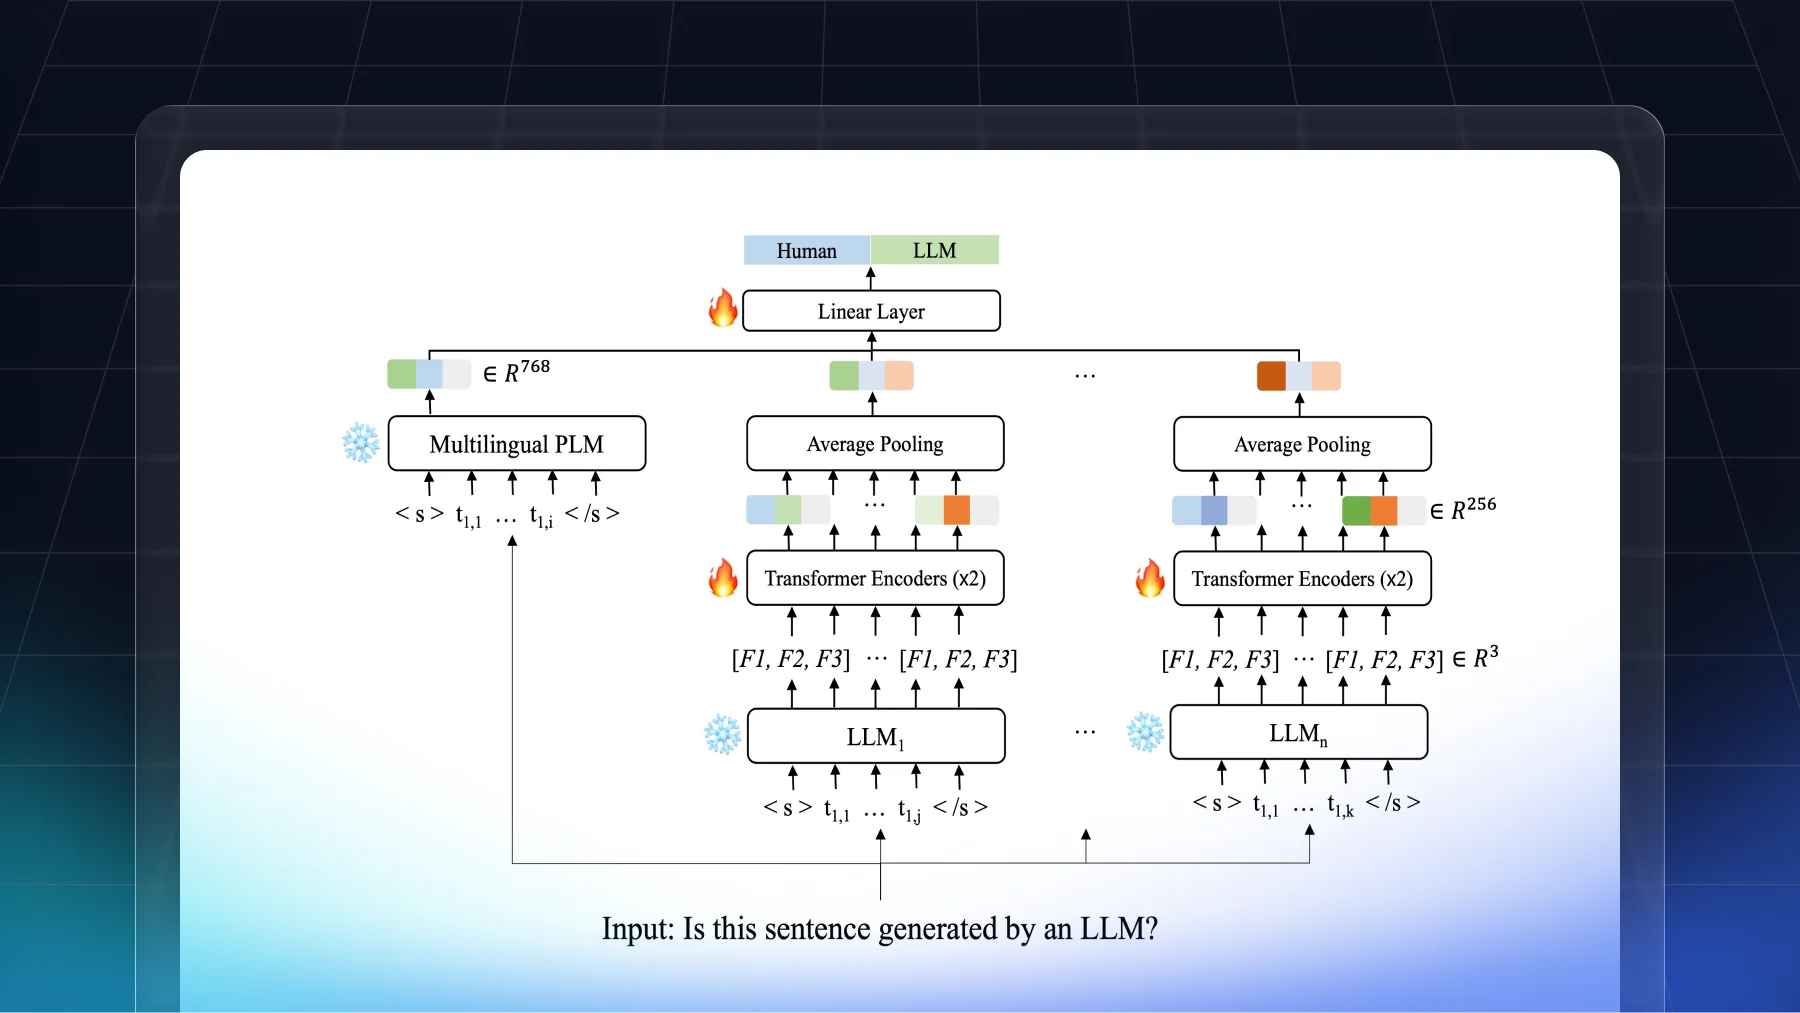
미학습 언어에서 성능이 떨어지는 다국어 LLM 생성 텍스트 탐지 문제를 다뤘습니다. 토큰 확률 분포와 의미 임베딩을 결합해 경진대회 3위를 기록했습니다.
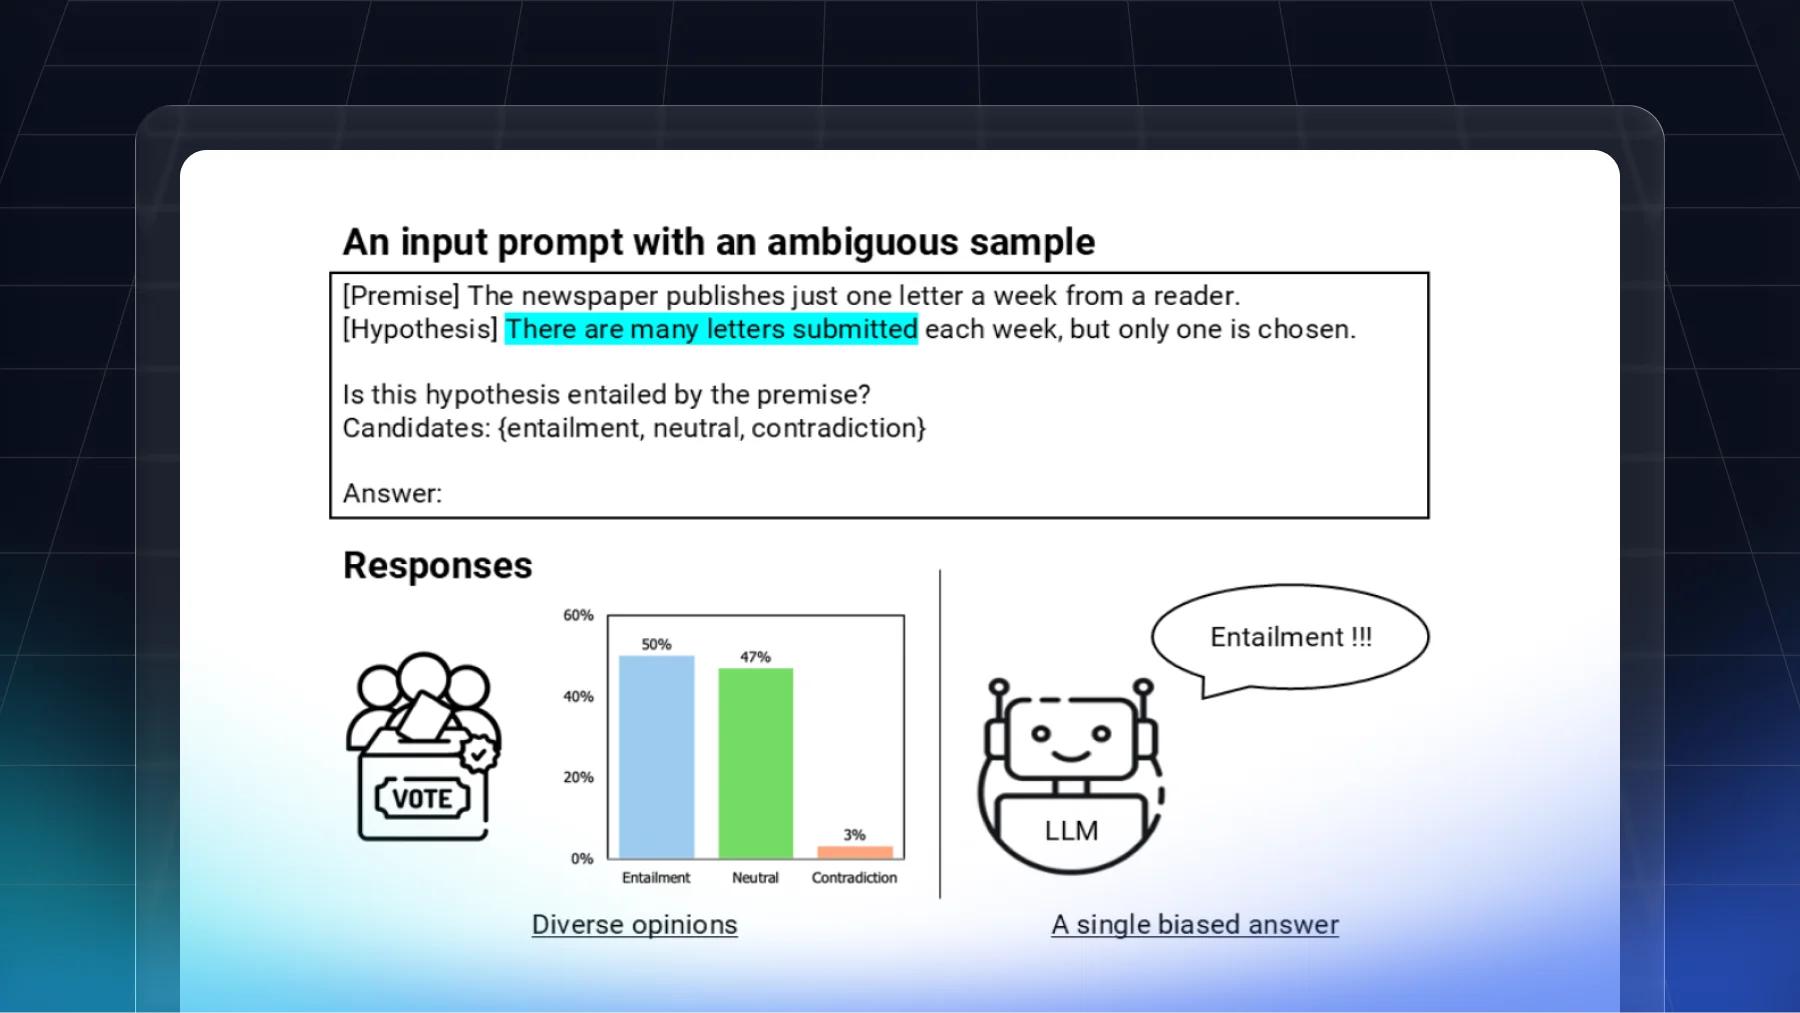
LLM 중간 레이어의 은닉 벡터로 NLU 입력의 애매성을 탐지하는 분류기를 제안했습니다. 최종 레이어보다 높은 탐지 성능을 확인하고, 라벨 부족 대응 학습법을 제시했습니다.
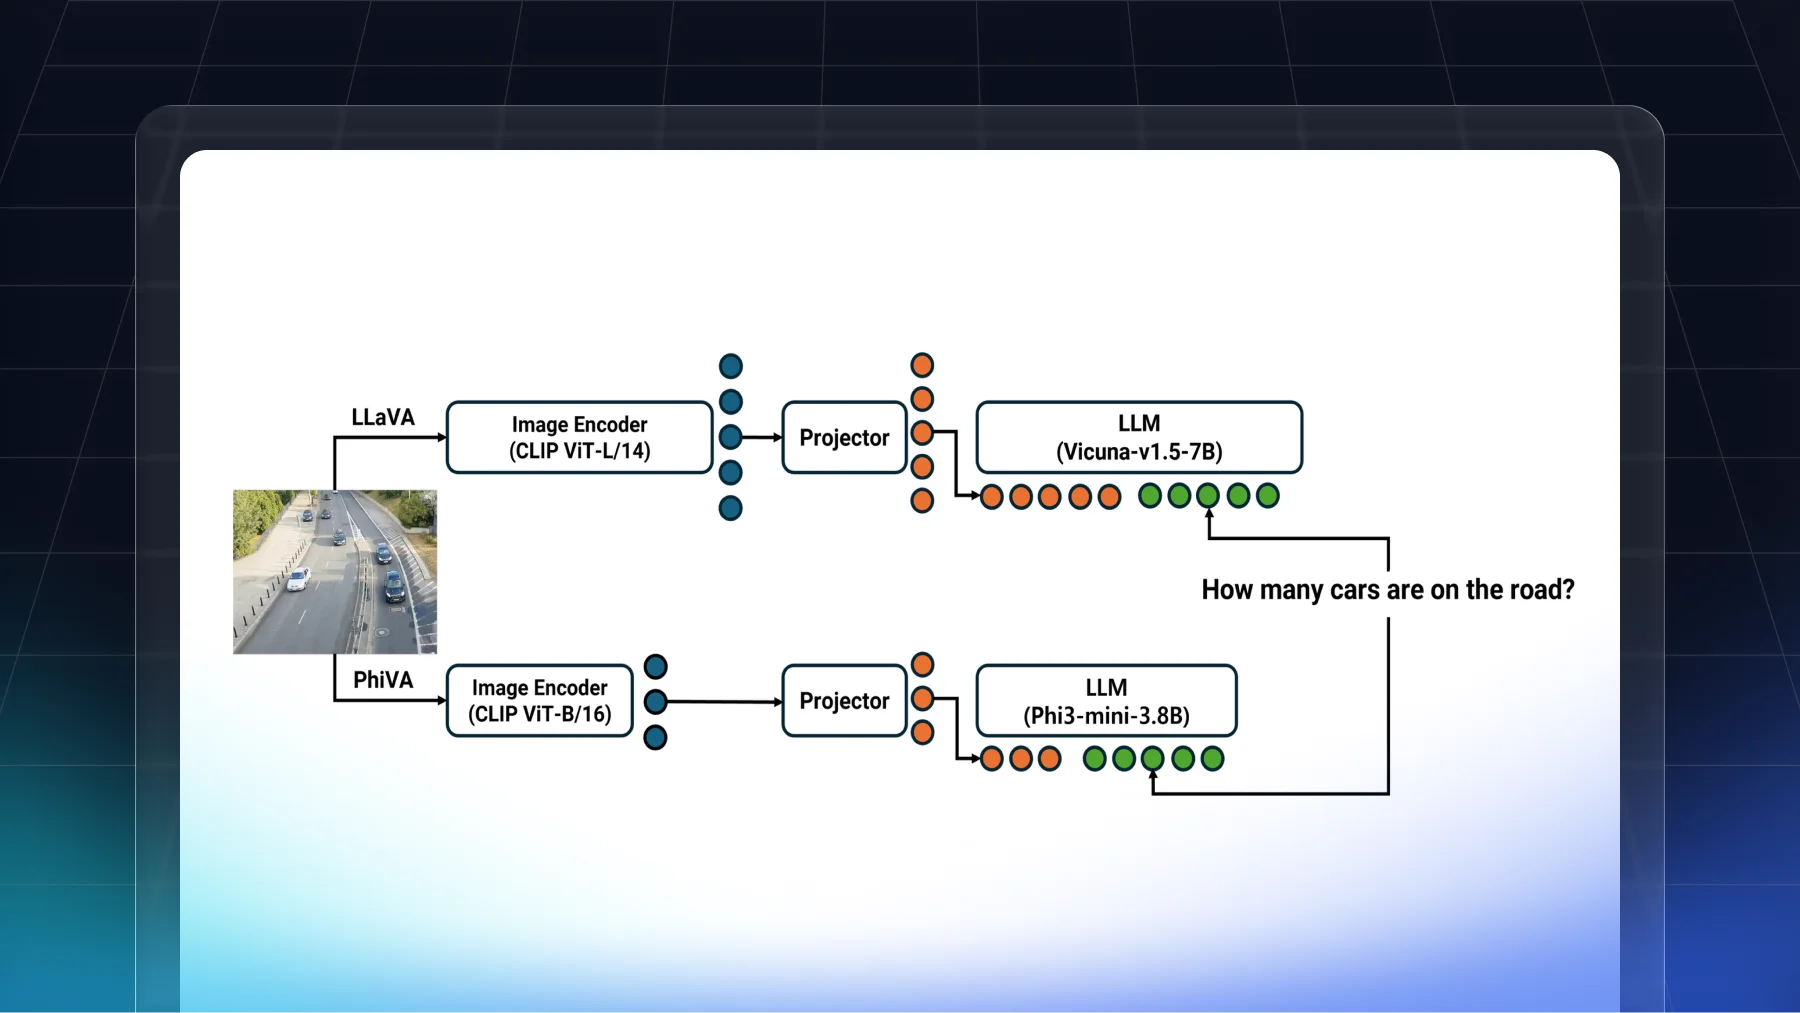
LLaVA를 Phi-3-mini와 CLIP ViT-B/16 기반 PhiVA로 경량화해 모바일 배포 과정을 설명했습니다. Galaxy 24 Ultra에서 이미지 인코딩 지연 시간을 37초에서 6초로 줄이고 디코딩 속도를 높였습니다.
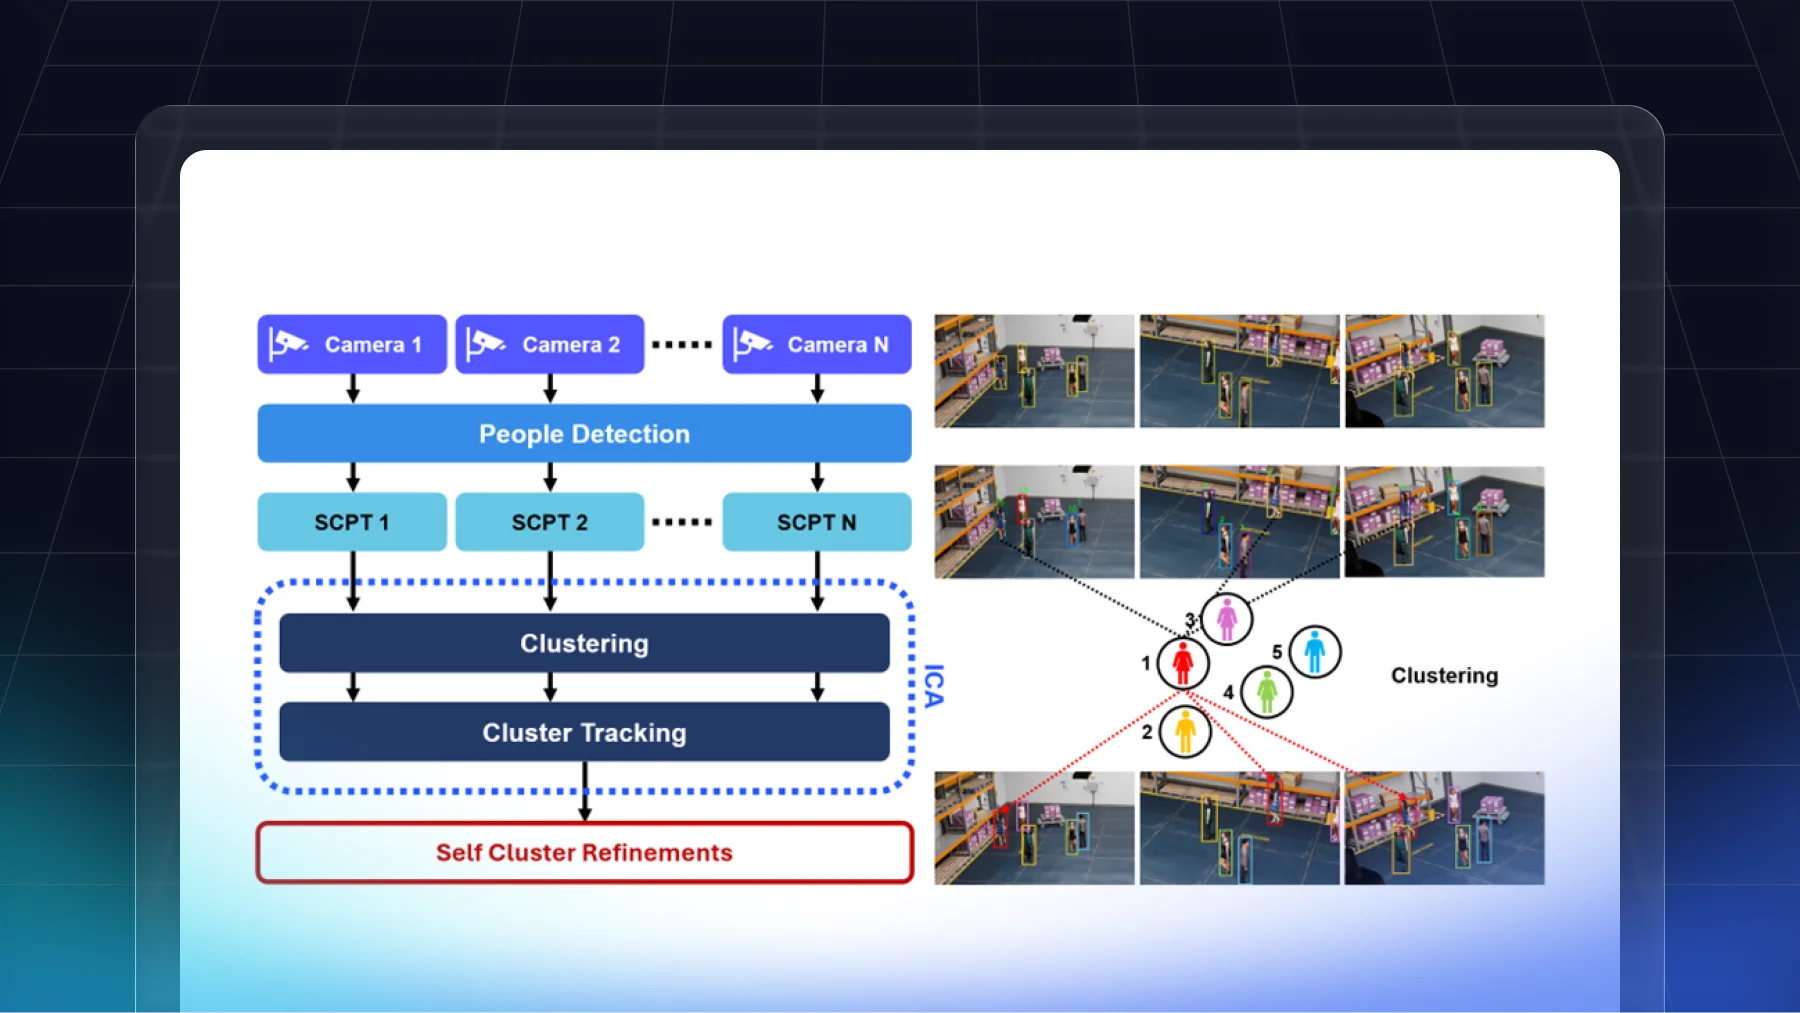
온라인 다중 카메라 인물 추적의 ID 오류를 줄이기 위해 Cluster Self-Refinement를 제안했습니다. 포즈 추정 기반 위치 보정까지 적용해 AI City Challenge 3위를 기록했습니다.
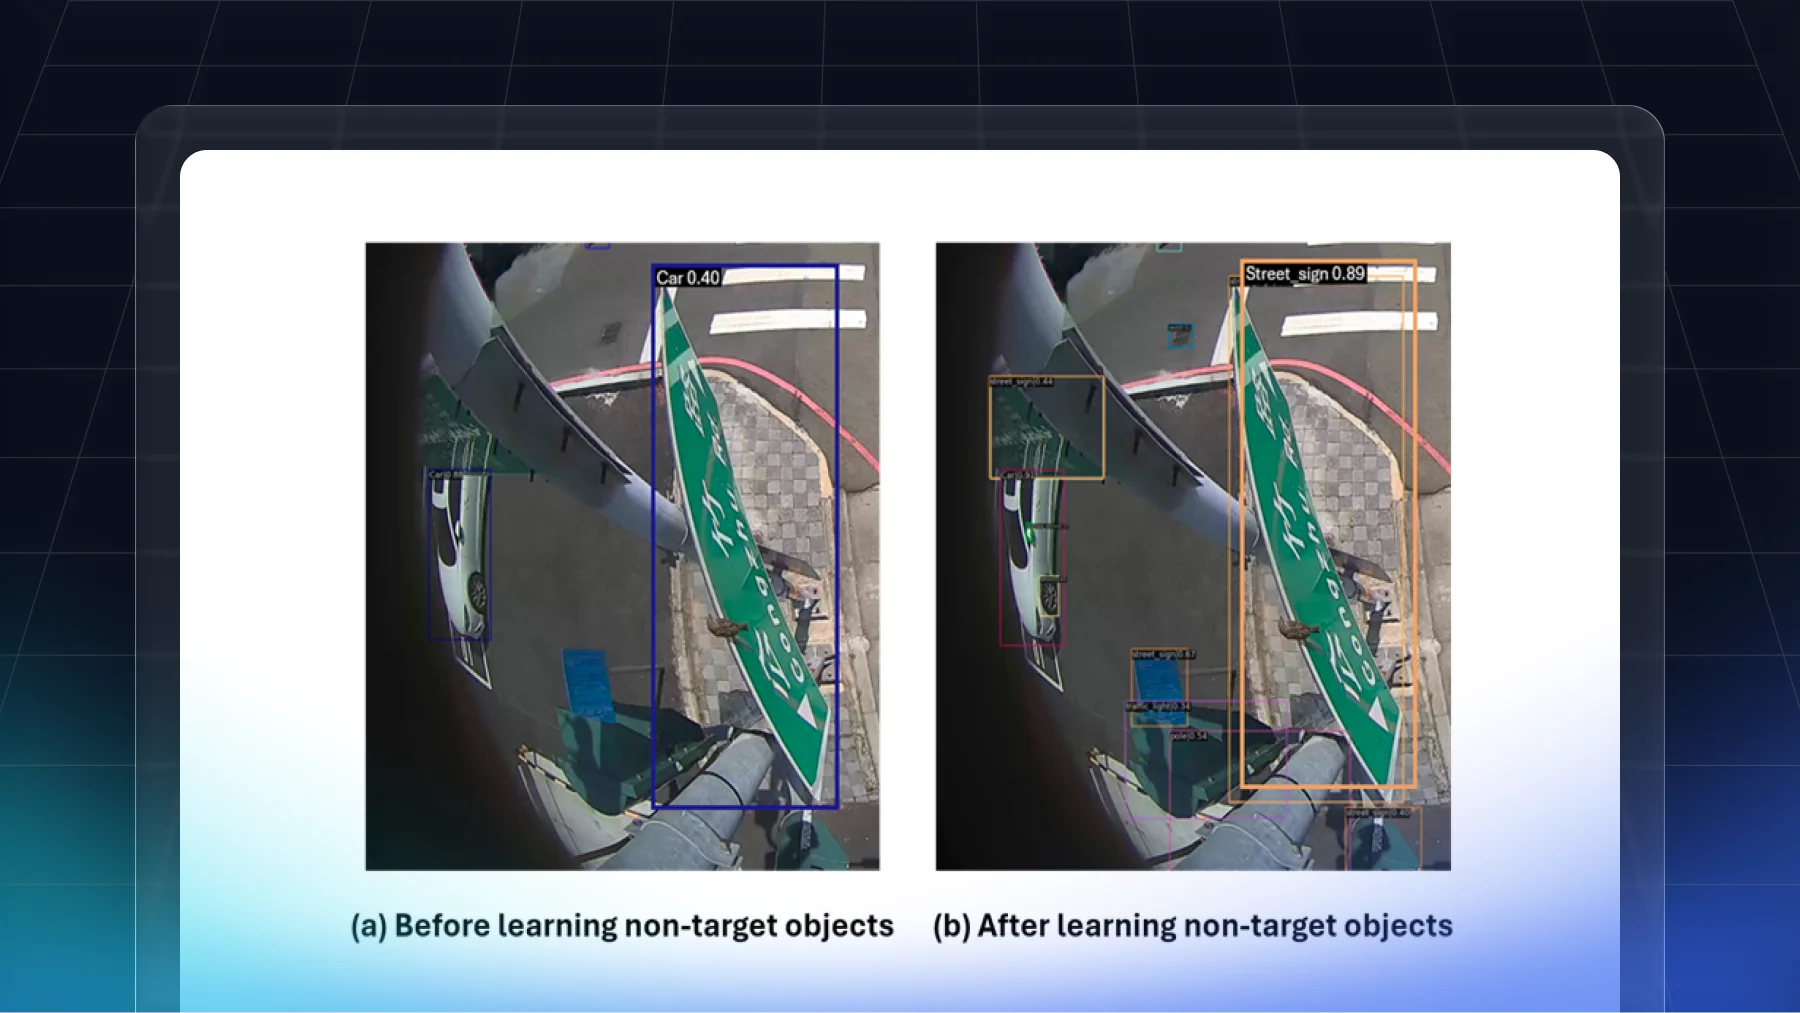
어안 이미지 가장자리의 작은 객체와 왜곡된 비목표 객체 문제를 SAHI·가짜 레이블 학습으로 보완했습니다. 증강·평활화·WBF 결합으로 F1 0.6196을 달성했지만 추론 비용이 큰 한계도 분석했습니다.
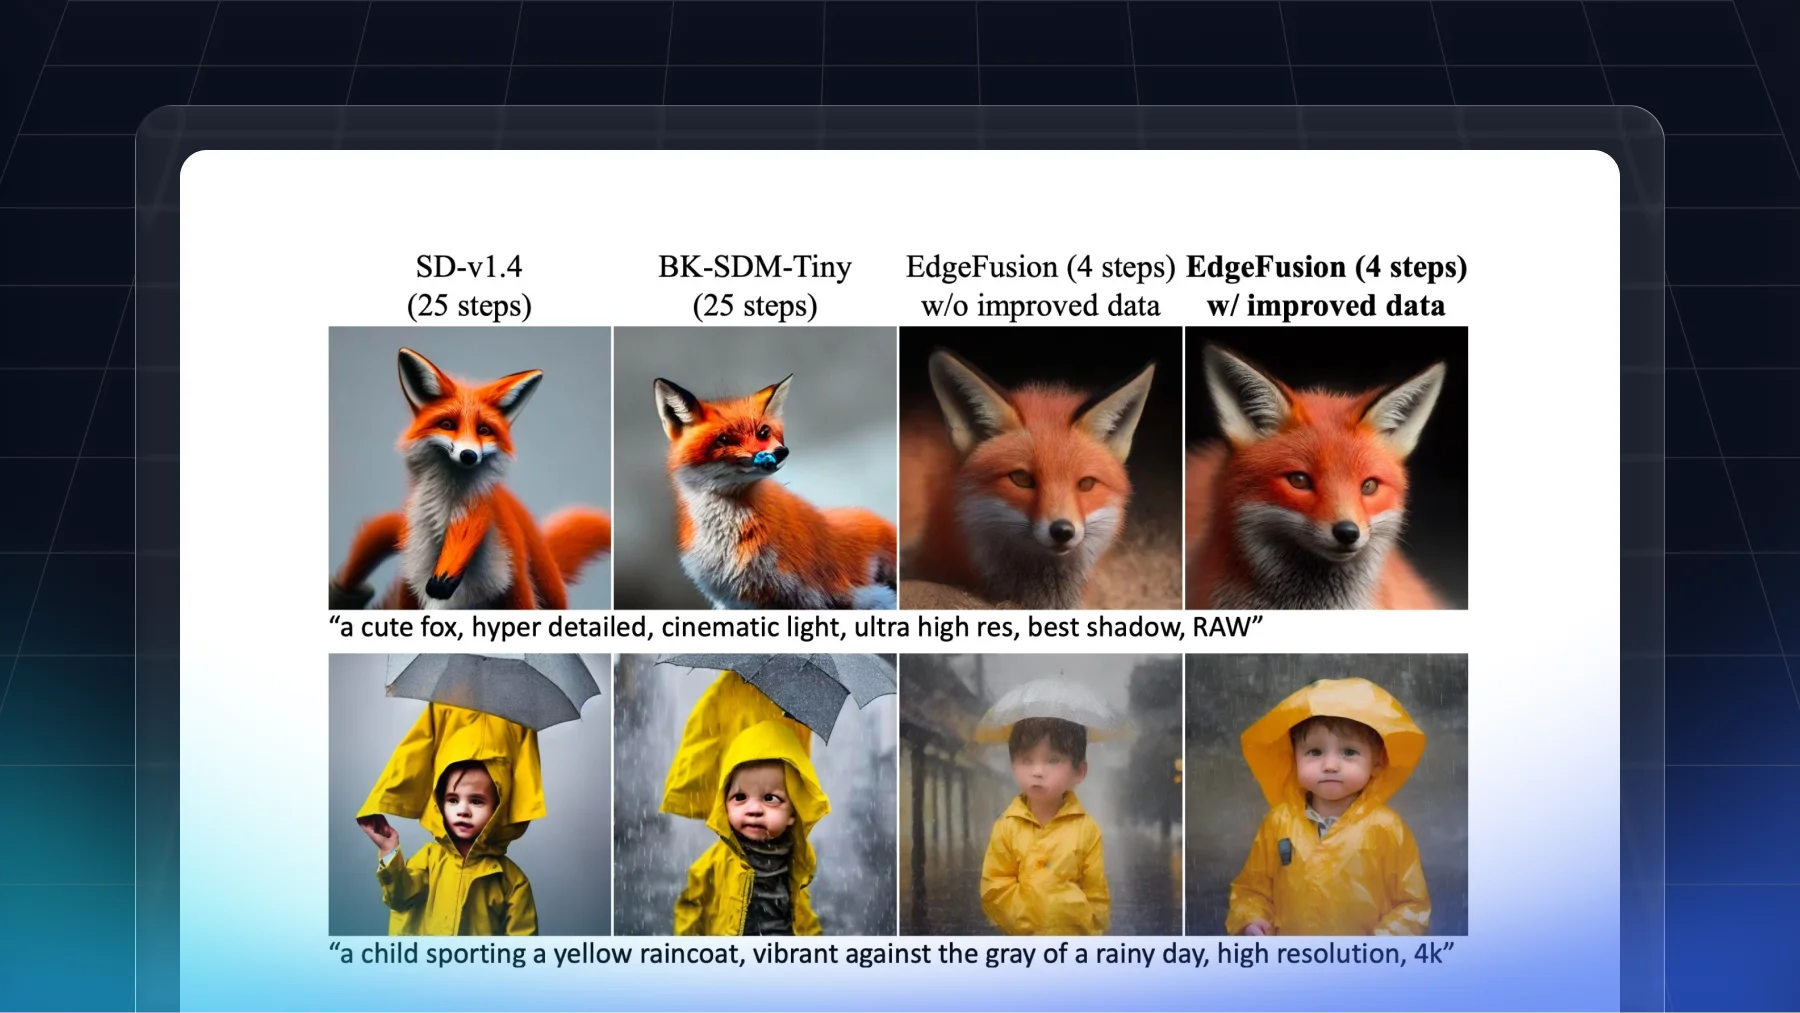
EdgeFusion은 고품질 합성 데이터와 LCM 맞춤 증류로 컴팩트 확산 모델의 생성 품질을 높였습니다. 모델 분할과 W8A16 양자화로 엑시노스 NPU에서 2단계, 1초 이내 생성을 달성했습니다.
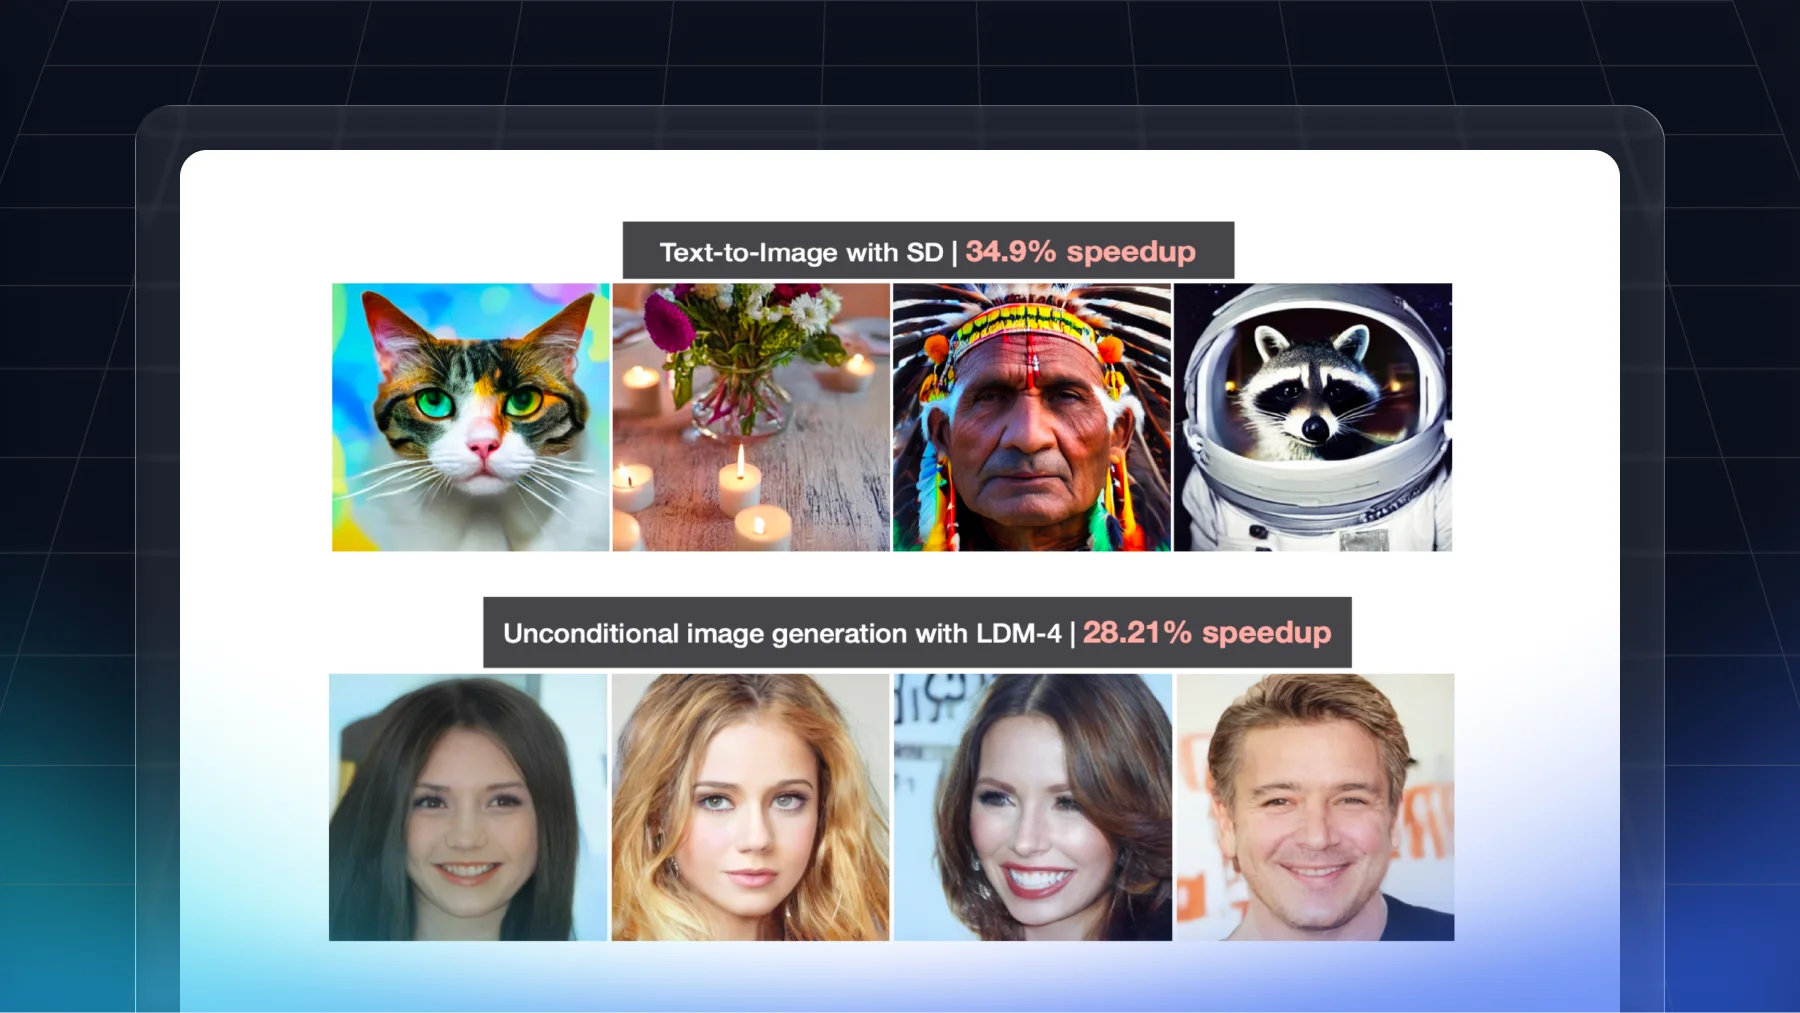
LD-Pruner는 잠재 표현 변화로 LDM Unet 연산자의 중요도를 평가해 가지치기합니다. 다양한 생성 작업에서 성능 저하를 줄이며 추론 속도와 메모리 효율을 개선했습니다.