
AI
LLaMA-3.2-Vision 경량화를 위한 크로스 어텐션 기반의 시각 정보 축소
두줄요약
크로스 어텐션의 희소성을 활용해 LLaMA-3.2-Vision의 불필요한 시각 토큰을 제거했습니다. 성능을 유지하며 KV 캐시, 메모리 사용량, 추론 지연을 줄였습니다.
구조와 흐름
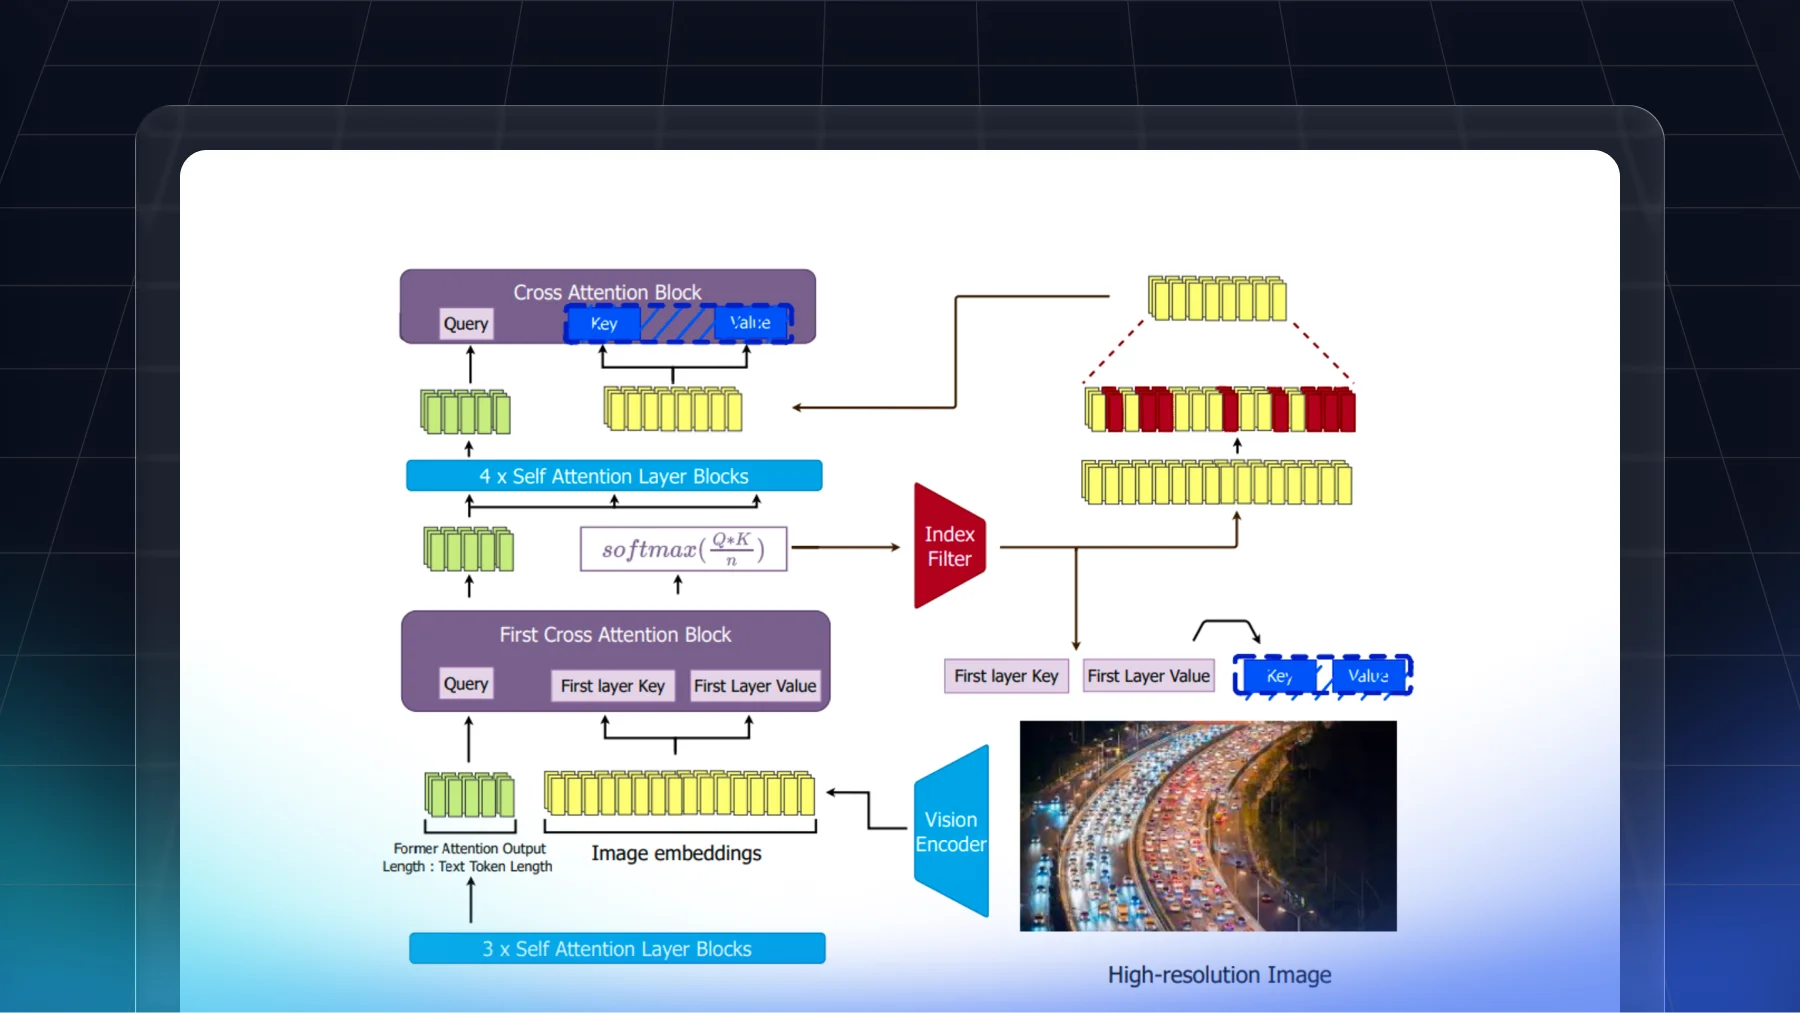
- 첫 번째 크로스 어텐션 블록의 헤드별 어텐션 가중치로 상위 k개 시각 특징 선택
- 모든 헤드의 상위 k 집합을 합쳐 최종 시각 토큰 구성
- 첫 레이어 이후 시각 특징 가지치기를 통한 key-value projection 및 어텐션 연산 축소
선택 이유
- 크로스 어텐션 이미지 토큰의 KV 캐시가 텍스트 토큰보다 큰 주요 연산 병목
- 초기 레이어의 시각 특징 선택과 이후 레이어 패턴의 높은 일관성
- 크로스 어텐션 맵 희소성 활용과 추가 학습 없는 중요도 기반 가지치기
성능/운영 포인트
- 전체 시각 특징 50% 축소 상태에서 기존 벤치마크 성능 유지
- KV 캐시 요구량, 추론 지연, 메모리 사용량 절감
- 배치 크기 증가에 따른 최적화 효과 증대
