AI
모바일 디바이스에 효율적인 비전 언어 모델 배포하기
두줄요약
LLaVA를 Phi-3-mini와 CLIP ViT-B/16 기반 PhiVA로 경량화해 모바일 배포 과정을 설명했습니다.\nGalaxy 24 Ultra에서 이미지 인코딩 지연 시간을 37초에서 6초로 줄이고 디코딩 속도를 높였습니다.
문제 상황
- CLIP ViT-L/14와 Vicuna-v1.5-7B 기반 LLaVA-v1.5-7B의 모바일 환경용 연산량·모델 크기 부담
- 클라우드 의존에 따른 비용 부담과 민감한 개인정보 외부 노출 위험
- 비전 언어 모델의 이미지·텍스트 동시 처리 미지원 MLC LLM 런타임
해결 방법
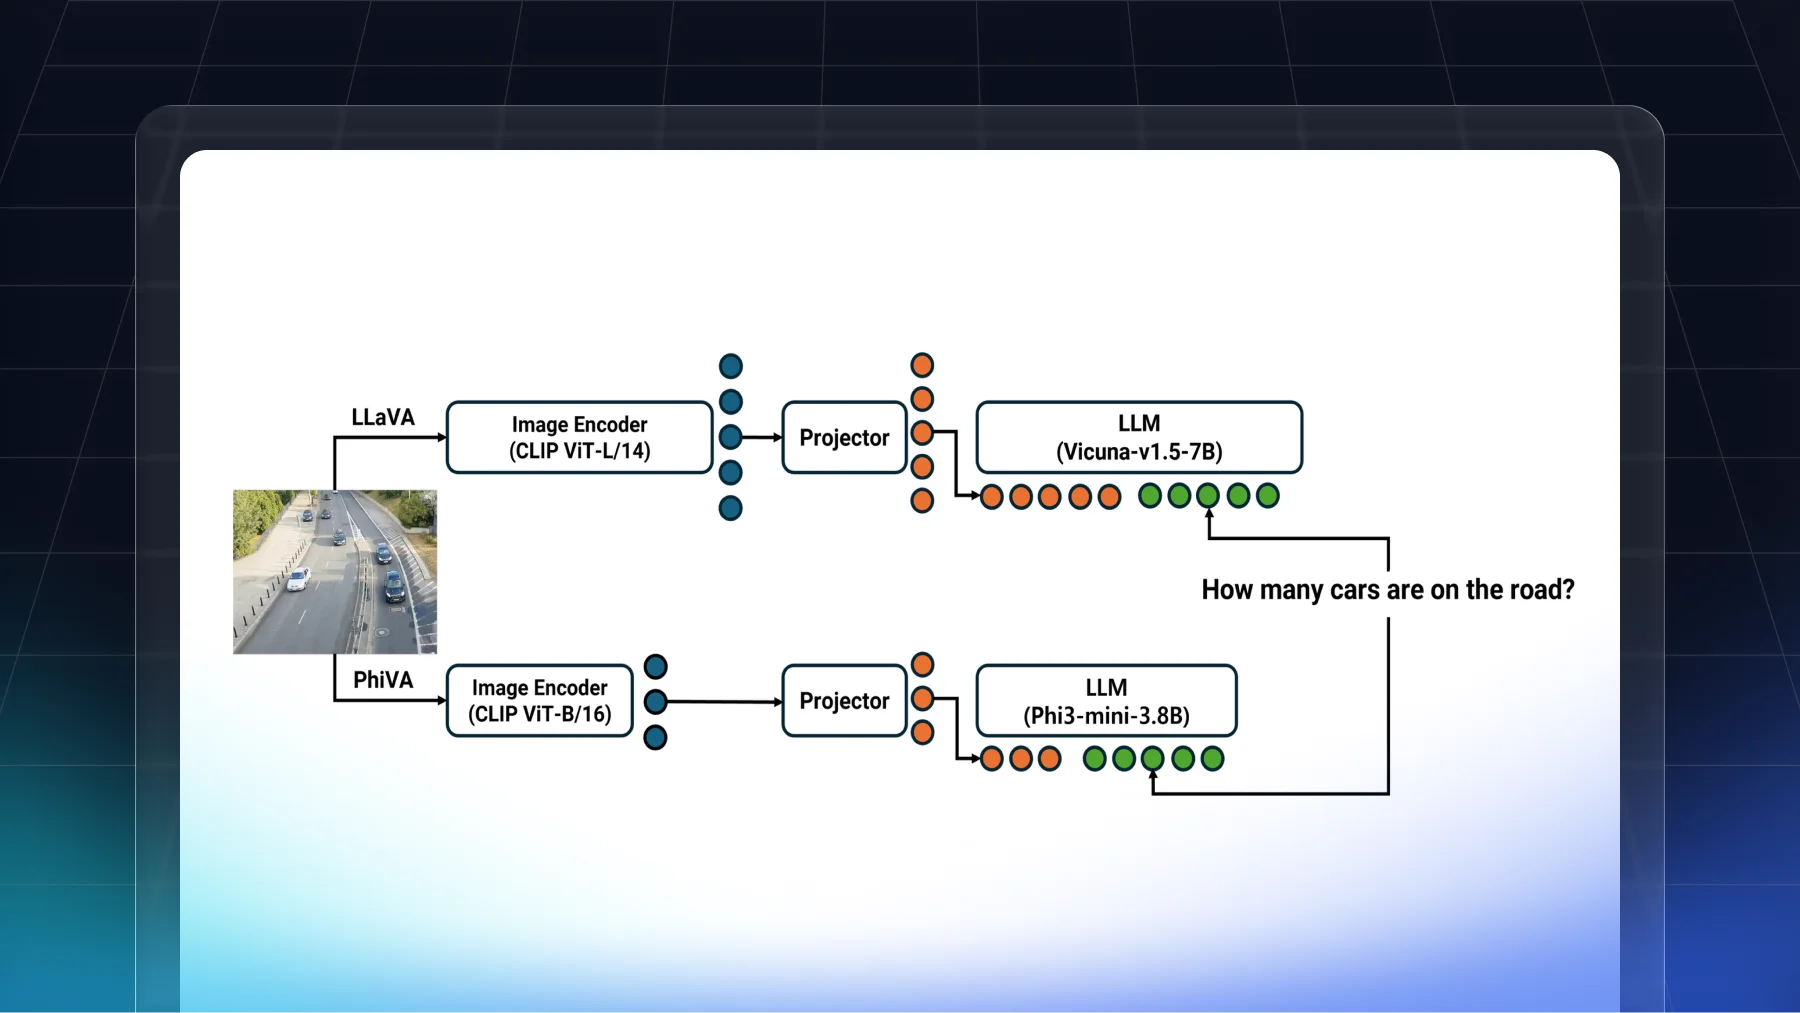
- 언어 모델을 Vicuna-v1.5-7B에서 Phi-3-mini 3.8B로 교체
- 이미지 인코더를 CLIP ViT-L/14에서 CLIP ViT-B/16으로 변경해 토큰 수와 임베딩 차원 축소
- 프로젝터 학습과 이미지 인코더 동결 기반 LoRA vision instruction tuning으로 PhiVA 구축
구조와 흐름
- CLIP ViT-B/16의 이미지 토큰 임베딩을 프로젝터로 Phi-3 입력 형식으로 변환
- MLC-Imp의 이미지 처리 구현체를 MLC LLM에 적용해 이미지·텍스트 채팅용 MLC-VLM-template 구성
성능/운영 포인트
- Galaxy 24 Ultra 기준 이미지 인코딩 지연 시간 37초에서 6초로 개선
- 언어 모델 디코딩 속도 초당 12토큰에서 18토큰으로 향상
- VLMEvalKit 평가에서 OCR 벤치마크를 제외한 항목의 성능 저하 최소화