축약된 LLM: 대형 언어 모델을 위한 간단한 깊이 가지치기 방법
트랜스포머 블록을 제거하는 깊이 가지치기로 LLM 추론 비용과 지연을 줄였습니다. 소규모 배치 환경에서 너비 가지치기보다 빠른 생성 속도와 경쟁력 있는 성능을 보였습니다.
#LLM#가지치기#Transformer
000
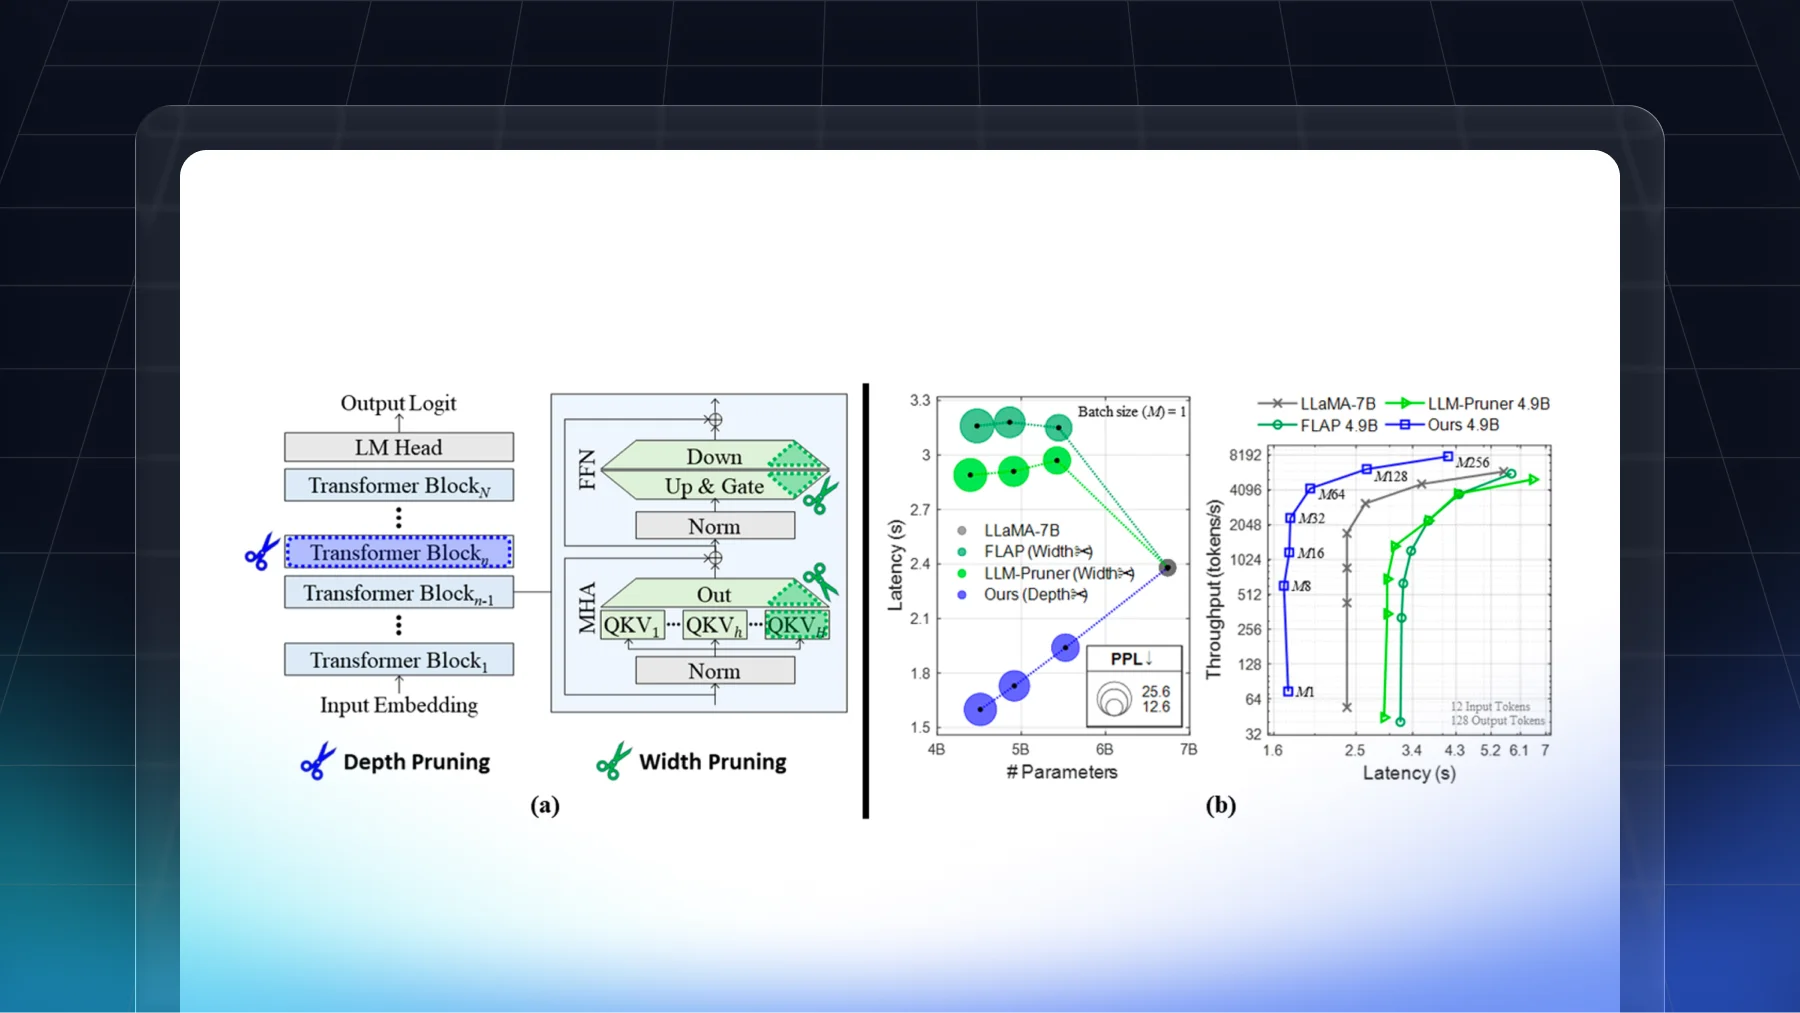
트랜스포머 블록을 제거하는 깊이 가지치기로 LLM 추론 비용과 지연을 줄였습니다. 소규모 배치 환경에서 너비 가지치기보다 빠른 생성 속도와 경쟁력 있는 성능을 보였습니다.
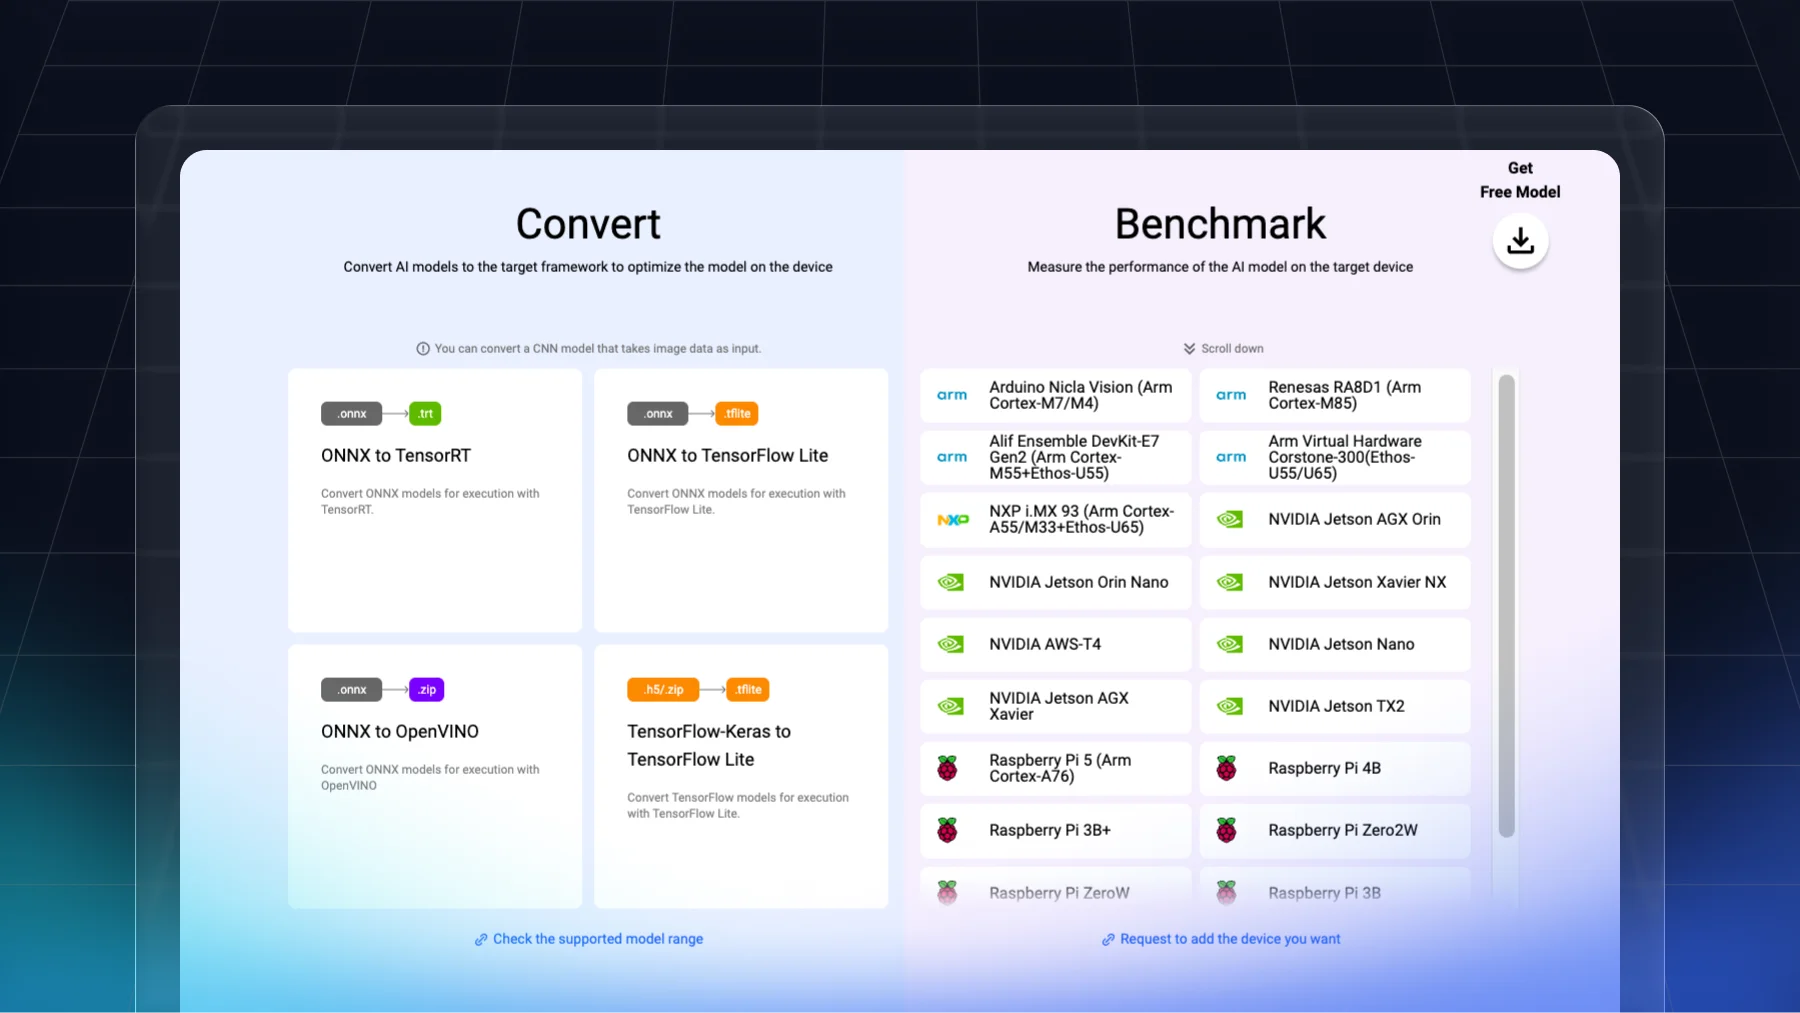
TAO Toolkit 모델을 ONNX로 내보내 LaunchX와 연동하는 과정을 소개했습니다. PyNetsPresso로 여러 엣지 장치의 변환 및 벤치마크를 확인합니다.
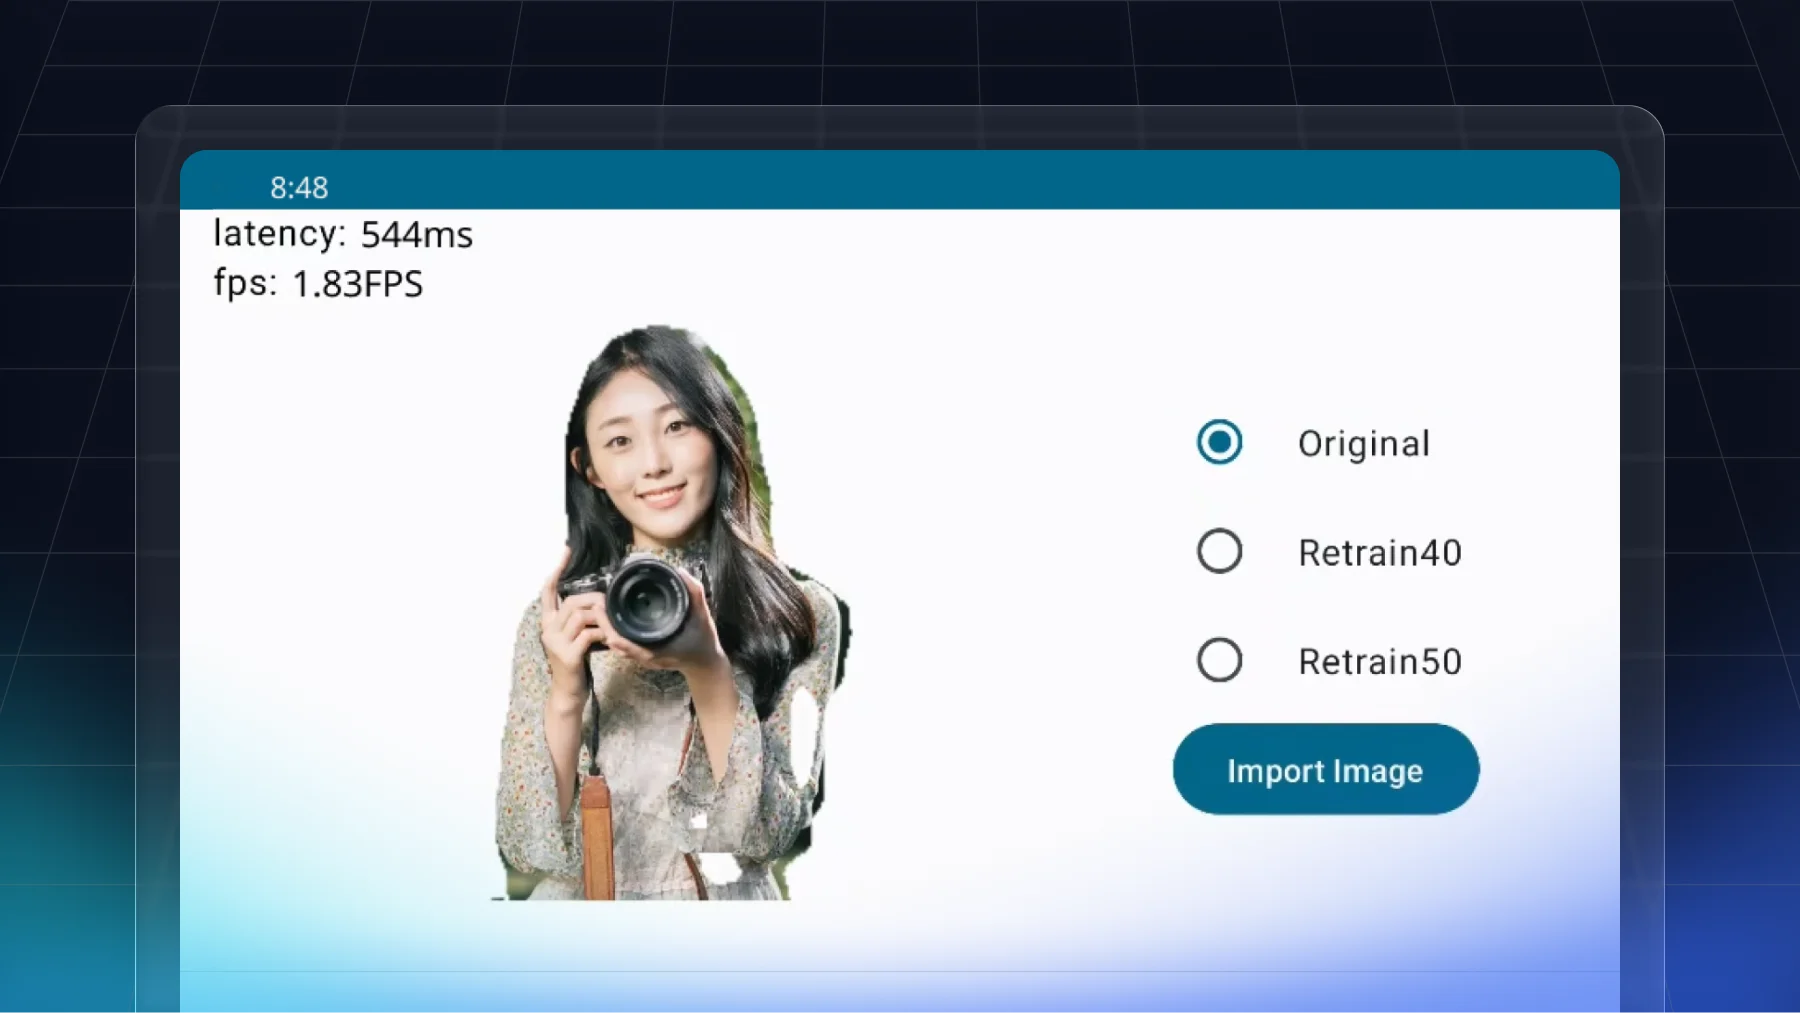
모바일 환경에서 PIDNet 의미론적 분할 모델의 실시간 처리 지연 문제를 다뤘습니다. NetsPresso 구조적 가지치기로 압축률별 정확도와 지연 시간의 균형을 비교했습니다.
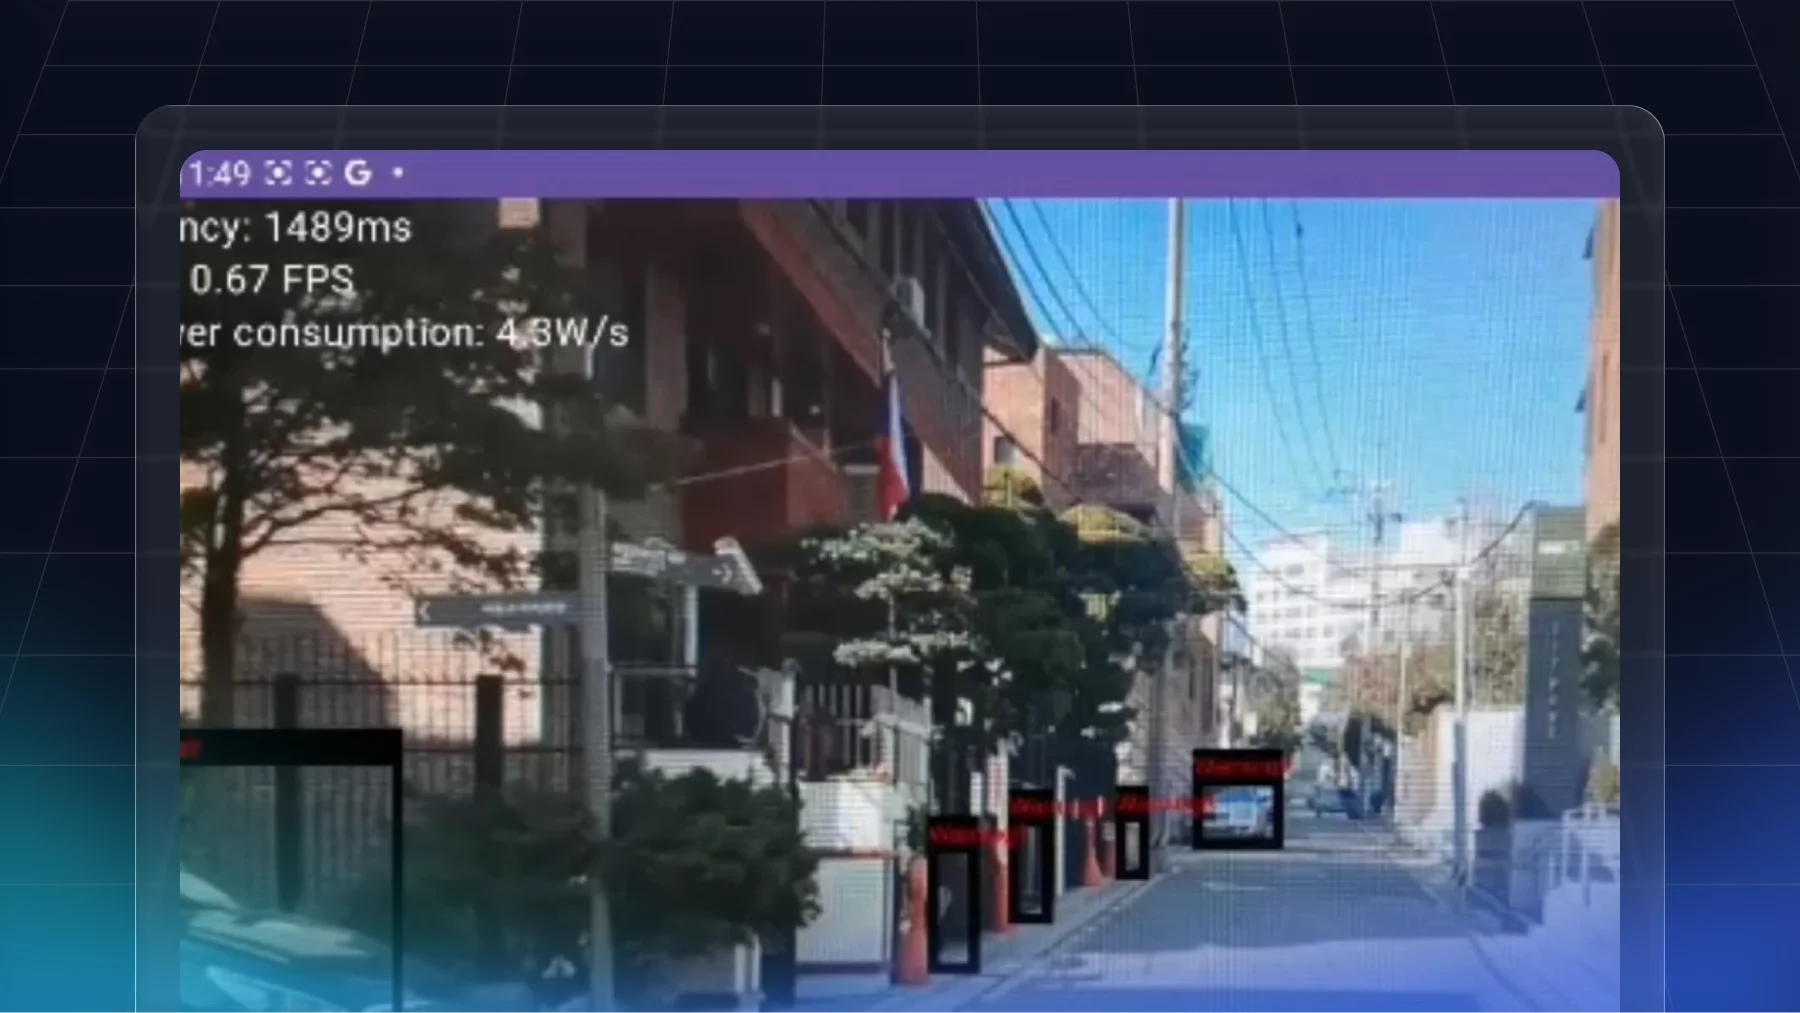
엣지 AI 기반 안드로이드 장애물 감지 앱의 실시간 객체 감지 방식을 소개했습니다. YOLOv5 모델 경량화로 지연 시간과 전력 소비를 낮춘 결과를 공유합니다.
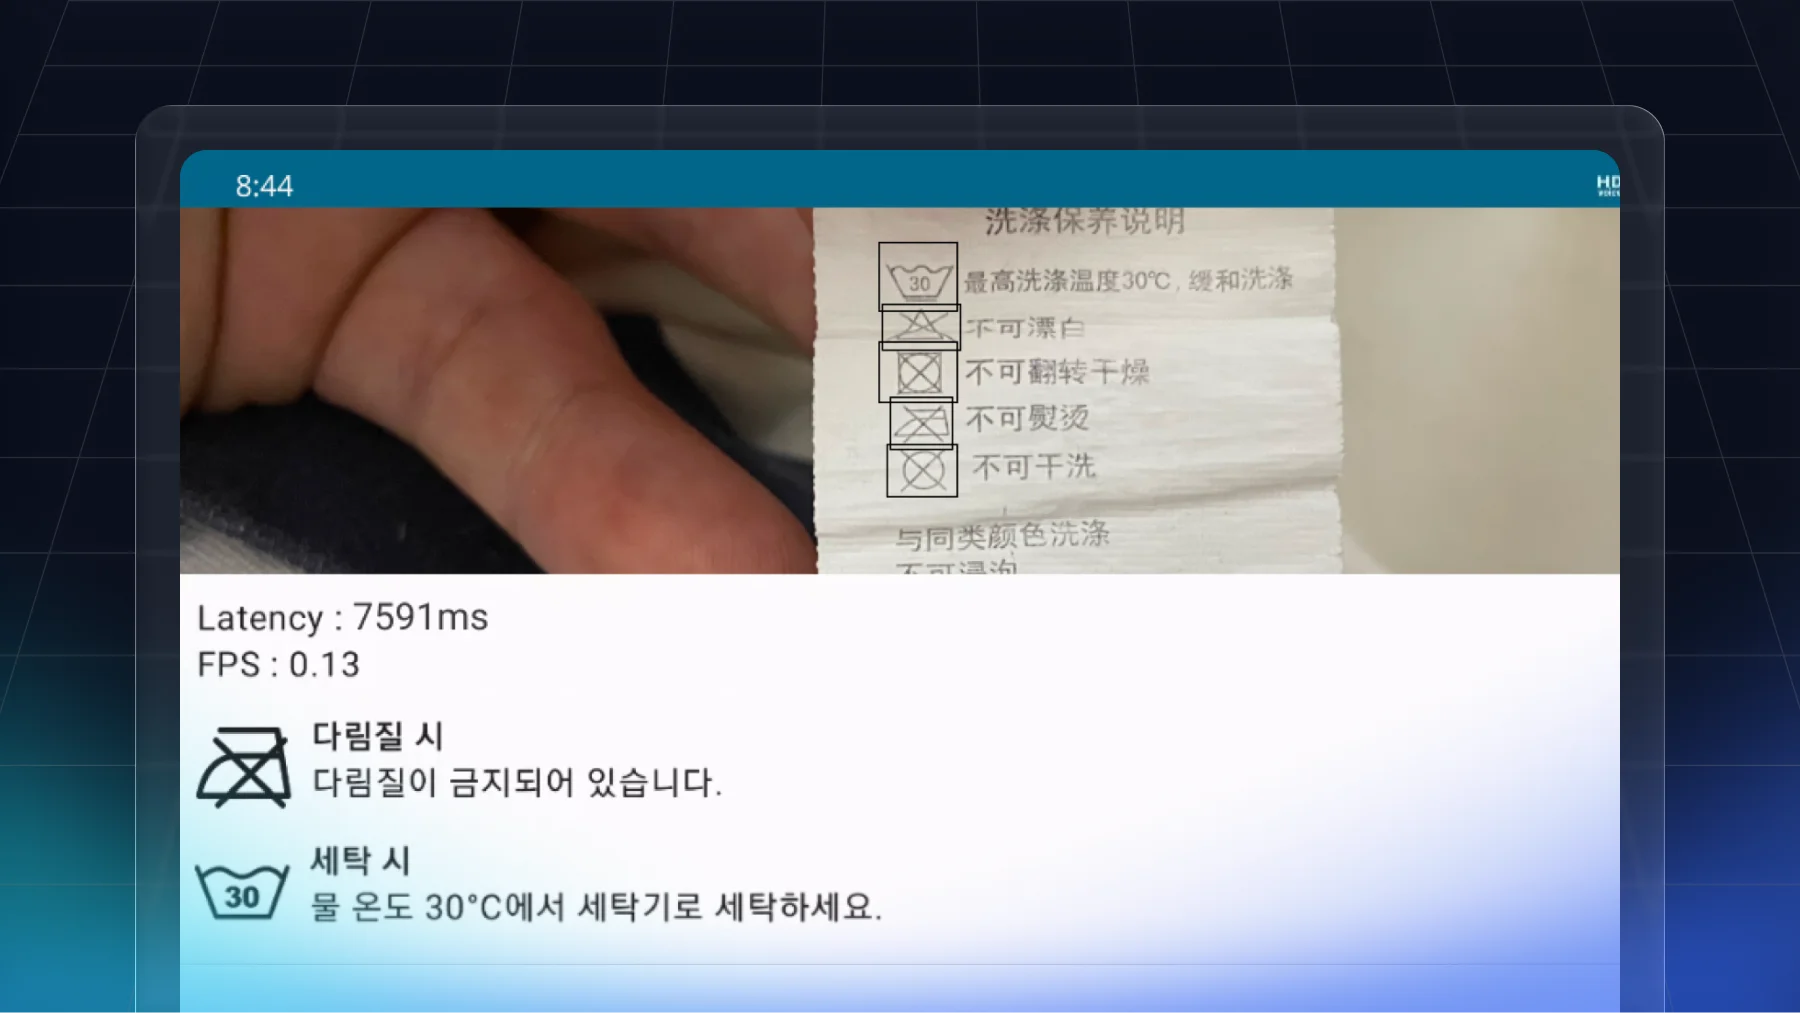
세탁 기호 객체 탐지 모델을 Android용 TFLite로 구현하고 NetsPresso로 최적화했습니다. 경량 모델은 크기를 줄이면서도 유사한 정확도와 더 빠른 탐지 속도를 보였습니다.
안드로이드 기기에서 TFLite 객체 감지 모델로 포트홀을 실시간 감지했습니다. NetsPresso 경량화로 정확도를 유지하며 지연 시간과 연산량을 줄였습니다.
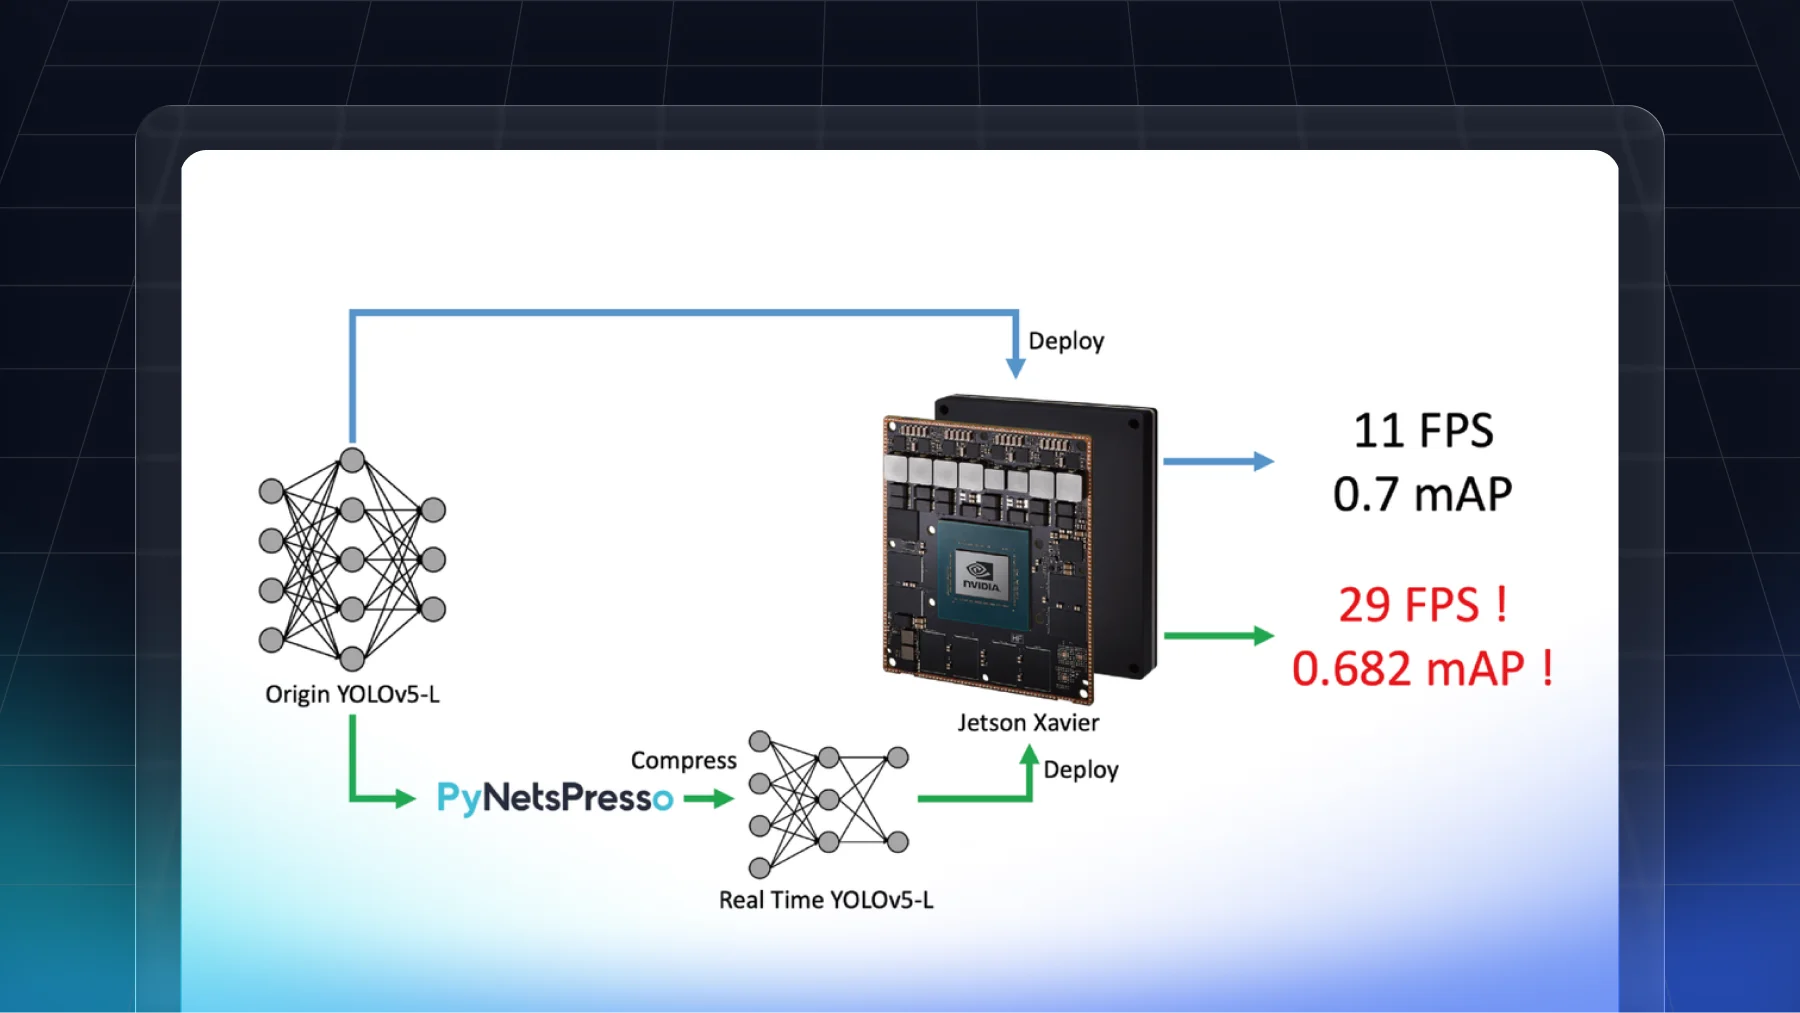
PyNetsPresso의 DAP로 YOLOv5-L에서 의존성을 고려한 파라미터 제거 방식을 소개했습니다. Jetson Xavier·TensorRT 환경에서 2.63배 성능 향상과 2% 수준의 성능 저하를 제시했습니다.