AI
ERGO: 비전-언어 모델을 위한 효율적인 고해상도 이미지 이해 기술
두줄요약
ERGO는 질의와 장면 문맥으로 중요한 영역을 먼저 찾는 2단계 비전-언어 추론을 제안했습니다. 강화학습 보상 설계로 비전 토큰을 줄이면서 정확도와 실제 지연 시간을 개선했습니다.
문제 상황
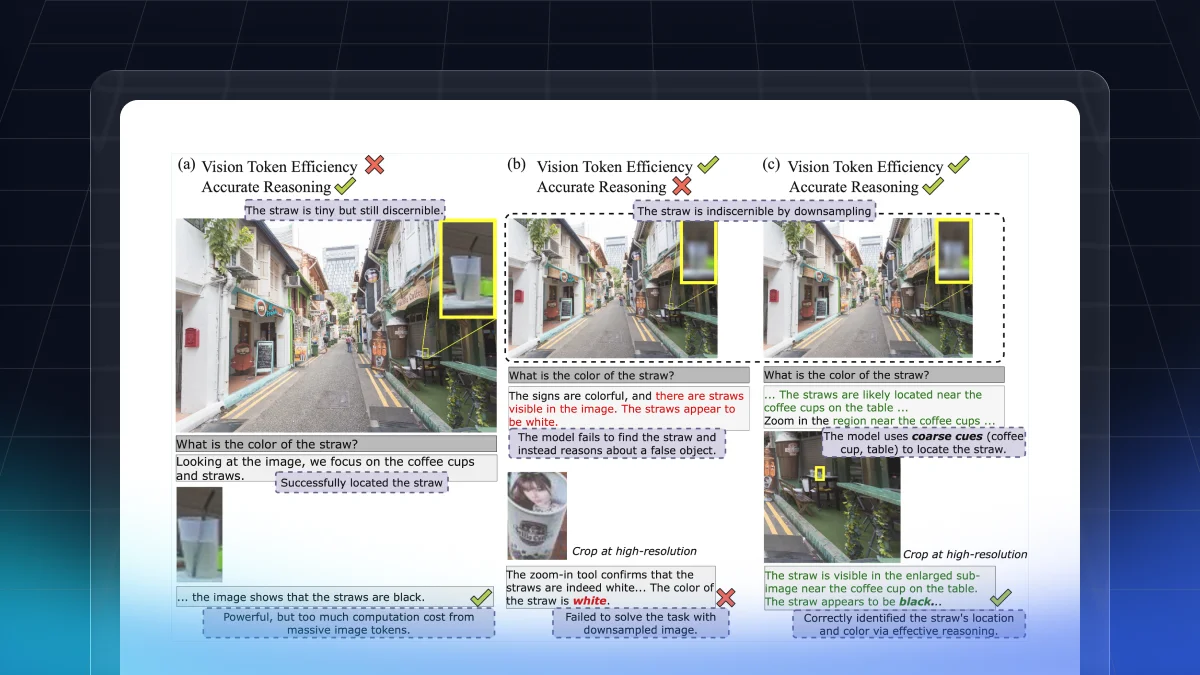
- 고해상도 이미지 처리 시 비전 토큰 급증에 따른 연산 오버헤드와 지연 증가
- 저해상도 입력에서 세부 객체 인식에 의존하는 기존 시각 추론의 성능·효율 저하
구조와 흐름
- 저해상도 이미지와 텍스트 질의 기반의 사고 과정 및 과제 관련 바운딩 박스 예측
- 원본 해상도 크롭 영역의 재입력을 통한 최종 답변 생성
- 필요한 영역만 고해상도로 분석하는 2단계 Coarse-to-Fine 추론
선택 이유
- 영역 검증 보상으로 질의 수행에 충분한 self-contained 영역 선택 유도
- 영역 크기 조정 보상으로 과도한 크롭과 전체 이미지 선택 억제
- TCE 보상을 통한 문맥 기반의 효율적 시각 탐색 학습
성능/운영 포인트
- 더 적은 비전 토큰으로 기존 기법 대비 높은 고해상도 벤치마크 성능
- vLLM 호환 환경에서 최대 3배 실제 지연 감소
- 보상 요소 추가에 따른 일관된 성능 향상 확인