AI
NVFP4란? NVIDIA Blackwell에서 실측한 LLM 추론 효율
두줄요약
Blackwell용 NVFP4의 2단계 스케일링 구조와 LLM 추론 실측 결과를 분석했습니다. RTX PRO 6000에서 A100 대비 최대 2배 처리량과 미미한 정확도 차이를 확인했습니다.
구조와 흐름
- E2M1 4비트 값, 16개 단위 FP8 블록 스케일, 텐서 단위 FP32 스케일의 2단계 구조
- Blackwell 5세대 Tensor Core의 네이티브 FP4/FP8 가속 경로와 A100의 고정밀 에뮬레이션 경로 비교
- vLLM 기반 RTX PRO 6000·A100 환경에서 TTFT, TPOT, 전체 처리량 및 정확도 측정
선택 이유
- 낮은 비트 폭의 대역폭·메모리 효율과 블록·텐서 스케일링 기반 동적 범위 보존의 결합
- NVIDIA GPU 단일 환경의 NVFP4와 멀티벤더 호환성을 겨냥한 MXFP4의 선택 구도
성능/운영 포인트
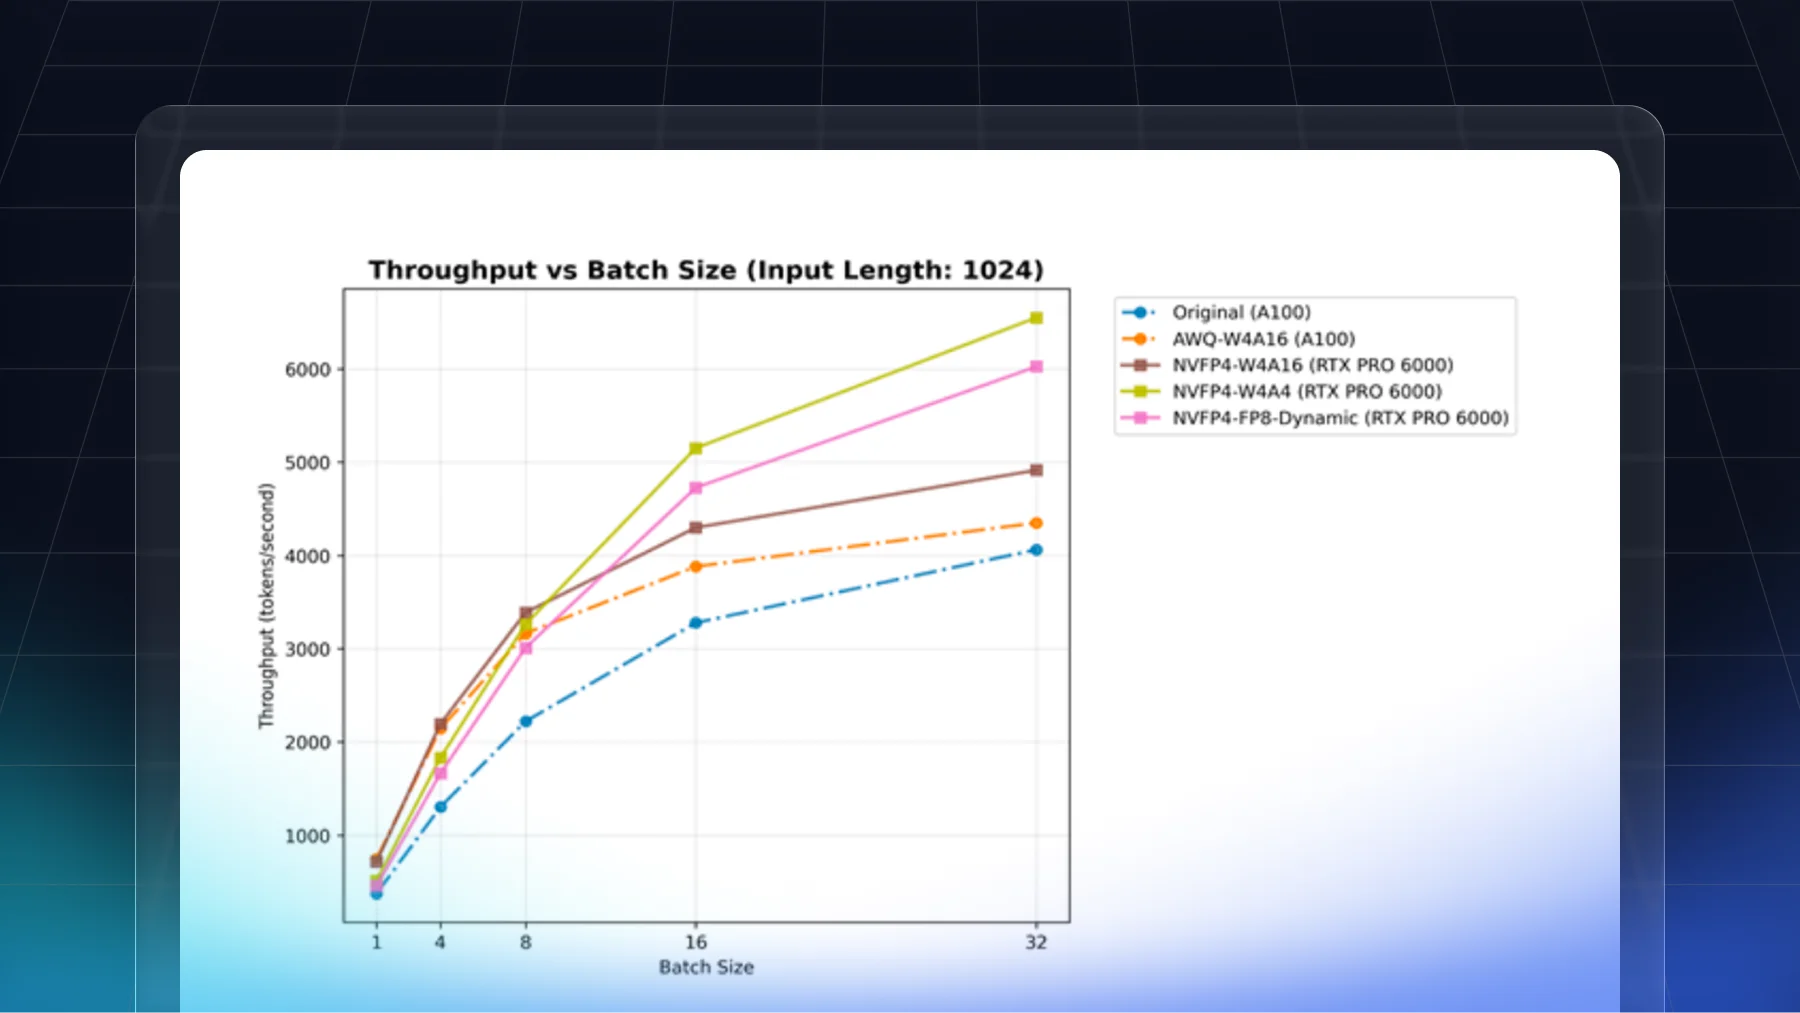
- RTX PRO 6000에서 NVFP4-W4A4 및 NVFP4-FP8-Dynamic의 A100 최적 설정보다 약 1.7~2배 높은 전체 처리량
- 대규모 배치·긴 입력에서 네이티브 FP4 경로와 활성화 양자화의 처리량 이점 확대
- HellaSwag·MMLU·PiQA 기준 정밀도 형식 간 ±0.005~0.02 수준의 정확도 차이
주의할 점
- A100에서는 FP4/FP8 네이티브 지원 부재로 BF16 대비 TTFT 이점 부재
- Decode 단계의 KV 캐시 중심 병목과 동적 스케일링·역양자화 오버헤드
- vLLM v0.10.1.1 및 초기 NVFP4/FP8 커널 최적화 수준에 따른 상대 추세 중심 해석