AI
지식 증류(Self-distillation)를 활용한 비디오 자기지도학습(Self-supervised Learning) 프레임워크
두줄요약
다음 프레임 예측과 EMA 교사를 결합한 비디오 자기지도학습 프레임워크를 제안했습니다. 광류·객체 추적 없이 ADE20K 분할과 COCO 검출 성능을 높였습니다.
문제 상황
- 정적 이미지 중심 자기지도 시각 표현 학습의 시간적 흐름·3D 기하 단서 활용 한계
- 광류 추정과 객체 추적 모듈 의존에 따른 복잡도·비용 부담
해결 방법
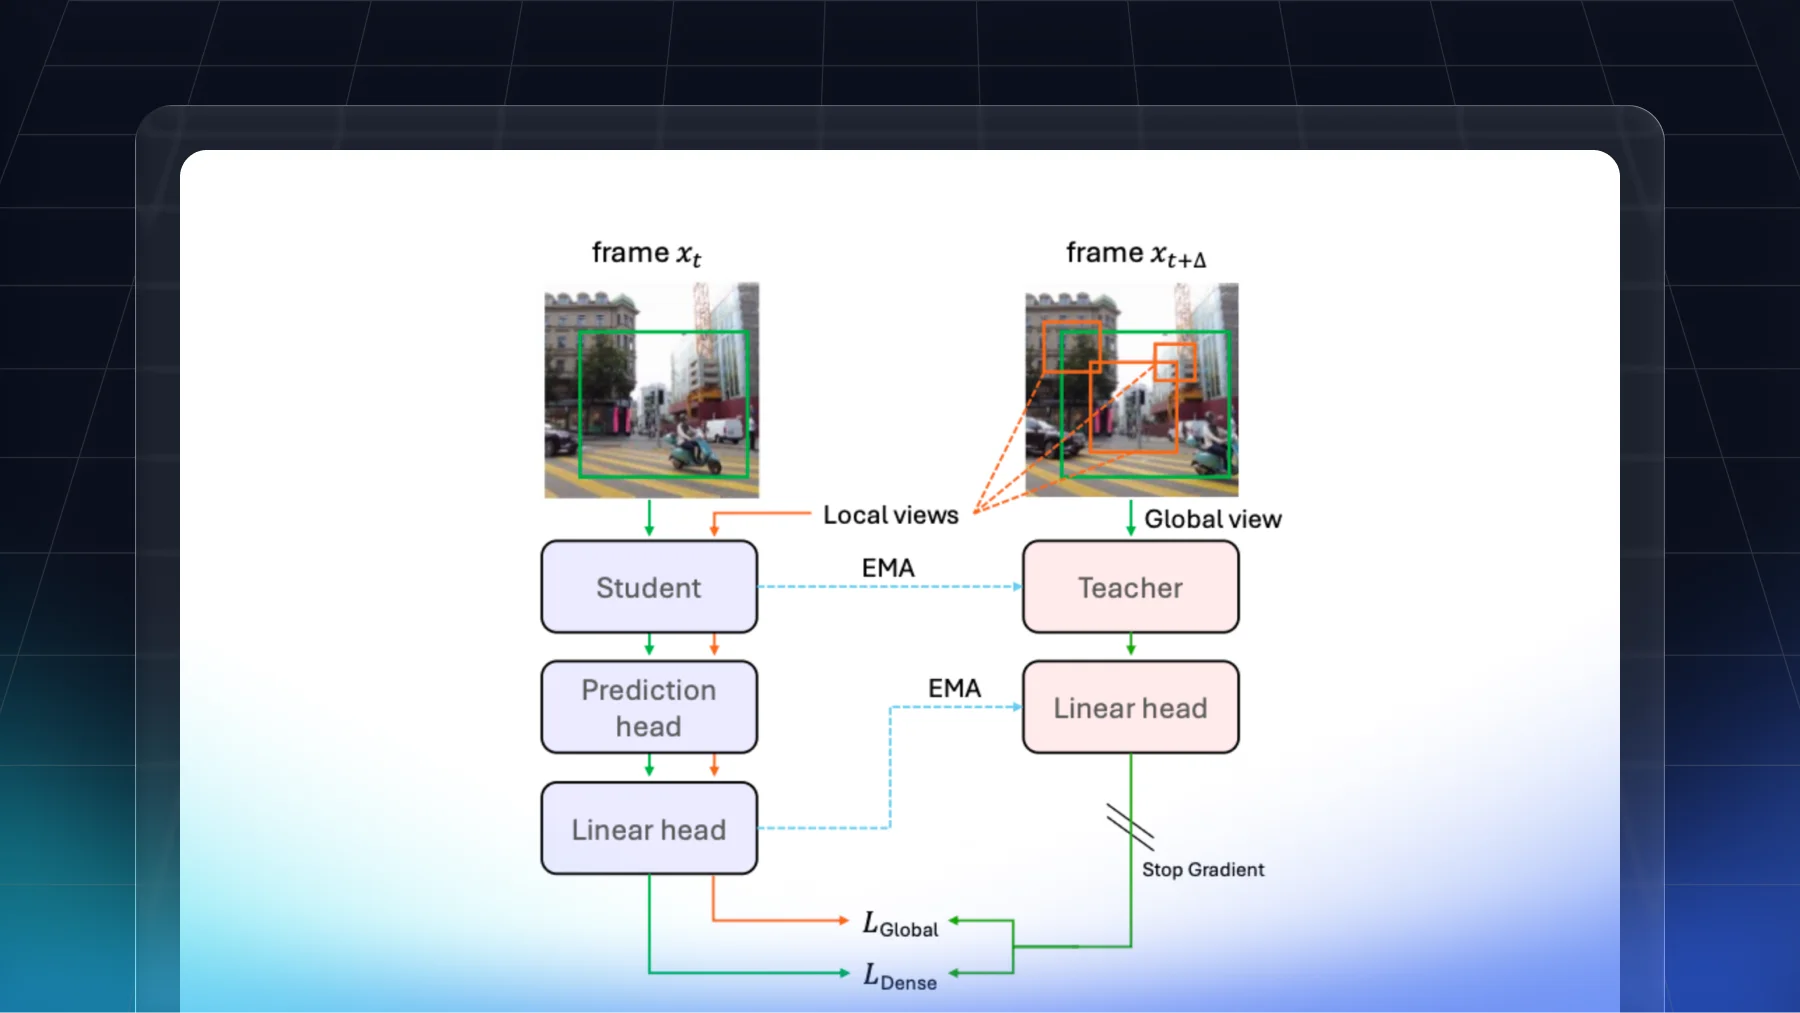
- 현재 프레임 임베딩으로 다음 프레임의 패치 특징을 예측하는 보조 학습 목적 함수
- EMA로 갱신되는 교사 네트워크의 타깃 특징과 학생 네트워크 예측의 정렬
- 패치 단위 교차 엔트로피와 CLS 토큰 기반 대조 손실의 결합
구조와 흐름
- DINO 유사 학생-교사 프레임워크와 어텐션 블록 2개·MLP 기반 예측 헤드
- 현재 프레임 t 입력, 다음 프레임 t+30의 패치 특징 예측
- 학습 후 예측 헤드 제거, 단일 프레임 인코더 기반 추론 유지
성능/운영 포인트
- ADE20K에서 UperNet 파인튜닝 36.4% mIoU, 선형 프로빙 18.3%
- COCO 객체 검출에서 33.5 mAP로 DoRA·DINO 대비 우수한 결과
- 스트라이드 Δ=30에서 가장 높은 성능, 적절한 시간적 맥락의 중요성