AI
[넷츠프레소 톺아보기] 모델 최적화부터 타깃 배포까지 한 번에 끝내는 플랫폼
두줄요약
넷츠프레소의 CLI 기반 AI 모델 최적화·배포 파이프라인을 소개했습니다. 양자화 탐색과 시각화로 정확도·지연시간·메모리의 균형을 검증합니다.
문제 상황
- 타깃 런타임의 연산자 미지원, 높은 추론 지연시간, 양자화 정확도 저하로 반복되는 모델 포팅·튜닝
- 모델 구조·연산자 구성과 하드웨어 런타임 제약의 차이로 모델별 수작업 최적화 부담
구조와 흐름
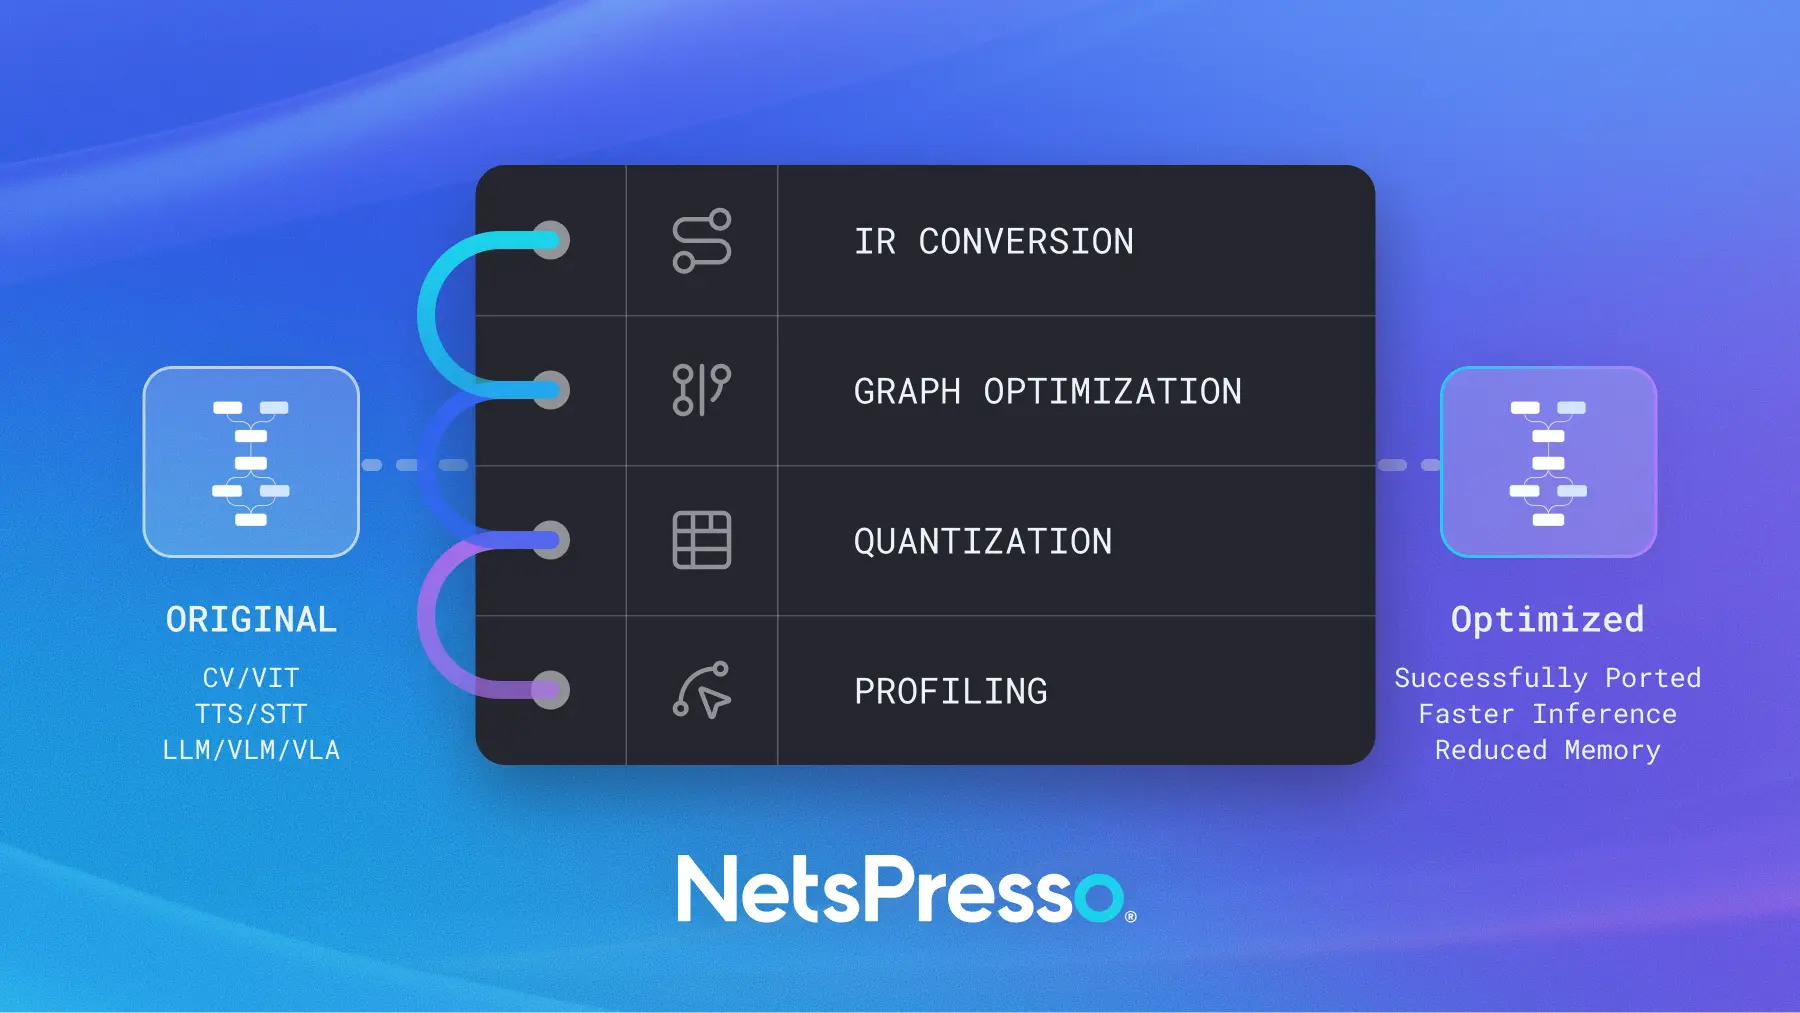
- 모델·데이터셋·타깃 디바이스·런타임 지정 후 AQ, GO, GQ 단계의 YAML 파이프라인 생성
- NPIR 변환 뒤 가중치 양자화, 그래프 최적화, 하드웨어 맞춤 그래프 양자화, 평가·프로파일링 수행
np report결과 비교와np export기반 타깃 하드웨어용 바이너리 추출
성능/운영 포인트
- sweep 후보군과 PPL·지연시간 기준을 통한 양자화 알고리즘·AMP 조합 자동 탐색
- Probe의 그래프 Diff, 레이어별 SNR·지연시간 분포 기반 최적화 결과 진단
- CPU·멀티 GPU, Docker·Python 설치, On-Premise 환경 및 로컬 모델·데이터셋 경로 지원
트레이드오프
- 예시 기준 메모리와 지연시간의 큰 감소에 따른 PPL 상승
- 정확도, 지연시간, 메모리 지표별 우선순위에 따른 최적 조합 선택