

실행은 도메인별로, 문맥은 한 레포에
중앙 DW Airflow를 멈추지 않고 도메인별 클러스터와 dbt 선언형 파이프라인으로 단계적으로 이전했습니다. 단일 레포에 의존성·지표 문맥을 모아 운영 복잡도와 에이전트 탐색 비용을 낮췄습니다.
#Airflow#dbt
6900
중앙 DW Airflow를 멈추지 않고 도메인별 클러스터와 dbt 선언형 파이프라인으로 단계적으로 이전했습니다. 단일 레포에 의존성·지표 문맥을 모아 운영 복잡도와 에이전트 탐색 비용을 낮췄습니다.
Spark Operator와 Tenant Operator를 분리해 Spark Connect 서버의 복구·교체를 제어했습니다. Blue-Green 전환, readiness 개선, glibc arena 제한으로 세션과 메모리 문제를 다뤘습니다.

Hive 4.2에서 제거된 get_table RPC로 Spark 잡이 실패한 원인을 추적했습니다. Thrift IDL 계약을 보존한 RPC 복원과 생성 코드 검증 방식을 정리했습니다.
Oozie/Sqoop 기반 데이터 파이프라인을 Airflow/Spark로 전환한 사례를 정리했습니다. YAML 템플릿, 동적 파티셔닝, Parquet 최적화로 운영성과 조회 성능을 함께 개선했습니다.


흩어진 클라우드 운영 데이터를 하나의 기준으로 모으기 위해 레이크하우스 기반 통합 플랫폼 Deck 구축 과정을 소개했습니다. Object Storage를 SSOT로 두고 레이어를 분리해 과금과 분석의 신뢰성을 높였습니다.
검색 리랭킹의 콜드 스타트와 임베딩 공간 불일치 문제를 안정화 기법으로 해결했습니다. 오프라인과 A/B 테스트에서 성능과 매출 개선도 확인했습니다.
Spark Connect를 멀티세션 서비스로 운영하며 생기는 단일 장애점과 리소스 경합 문제를 다뤘습니다. replica, Gateway, 부하 점수 기반 세션 배치로 안정성을 높인 과정을 정리했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
Iceberg 운영에서 스냅샷 폭증과 Small File 문제를 어떻게 다뤘는지 정리했습니다. 작업 이력 관리와 메인터넌스 정책으로 비용과 성능을 개선한 사례입니다.
200개 이상 DB를 BigQuery로 옮기던 ELT 운영 문제를 DT Platform으로 분리·표준화했습니다. UI와 DSL, 자동 마이그레이션으로 리드타임과 리뷰 병목을 줄였습니다.
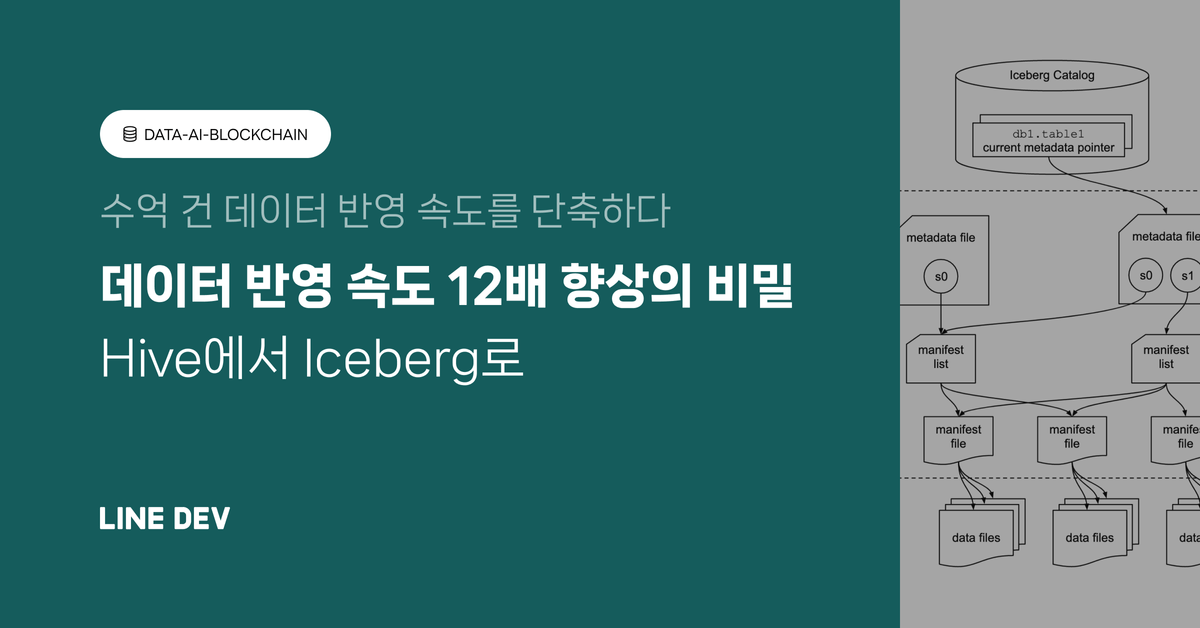
Hive 기반 전체 재작성 ETL의 한계를 Iceberg와 Flink로 개선한 사례를 소개했습니다. 체크포인트, 2PC, 파티셔닝 최적화로 데이터 반영 속도를 12배 높였습니다.
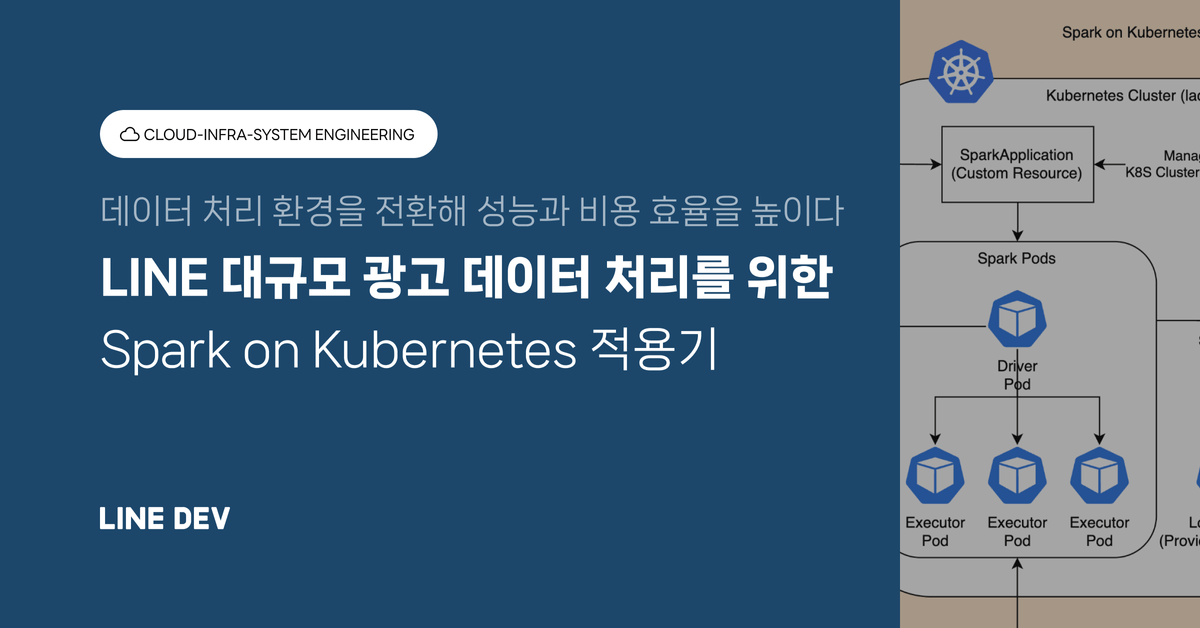
LINE Ads의 대규모 광고 데이터를 처리하기 위해 Spark on Kubernetes를 도입한 사례입니다. 성능 향상, 비용 절감, 버전 유연성을 함께 확보했습니다.
전수 적재의 지연과 정합성 문제를 해결하기 위해 CDC 기반 증분 복제 파이프라인을 설계했습니다. 전체 로우 해시와 사후 검증으로 멱등성과 신뢰도를 높이고, 시간 단위 배치로 최신성을 개선했습니다.

Event·Metric Config와 증분 집계로 실험 메트릭 계산을 표준화했습니다. Z-test·Delta Method와 통합 UI로 결과 해석 불일치를 줄였습니다.
DynamoDB+S3 이중 저장을 Iceberg 단일 테이블로 통합해 비용을 약 91.5% 절감했습니다. 조회 성능과 서빙 안정성도 함께 개선하고, 컴팩션과 조회의 균형 중요성을 정리했습니다.