AI
[넷츠프레소 AQ 딥다이브] K-EXAONE-236B 모델을 4비트(NVFP4)로 양자화하는 법
두줄요약
K-EXAONE-236B MoE의 집중 이상치를 오프라인 변환으로 제어해 NVFP4로 양자화했습니다. 추가 커널 없이 vLLM에서 서빙하며 BF16 수준 정확도와 약 3.5배 압축을 제시했습니다.
문제 상황
- K-EXAONE-236B-A23B의 레이어·전문가별 상이한 가중치 분포와 마지막 두 레이어의 집중된 이상치
- 추가 커널·예외 처리 없이 47개 MoE 레이어 전체를 NVFP4 단일 포맷으로 서빙해야 하는 제약
구조와 흐름
- 약 2,270억 개 전문가 가중치 분석을 통한 이상치 분포 진단
- 가중치 좌표계 회전, 잔여 이상치 이동, NVFP4 양자화 순서의 오프라인 융합
- 변환 결과를 가중치에 내재화하고 vLLM 네이티브 경로로 서빙
선택 이유
- 민감 레이어 제외와 혼합 정밀도 없이 표준 NVFP4 규격 준수
- 런타임 보정 연산 대신 양자화 전 가중치 변환으로 추가 커널 회피
성능/운영 포인트
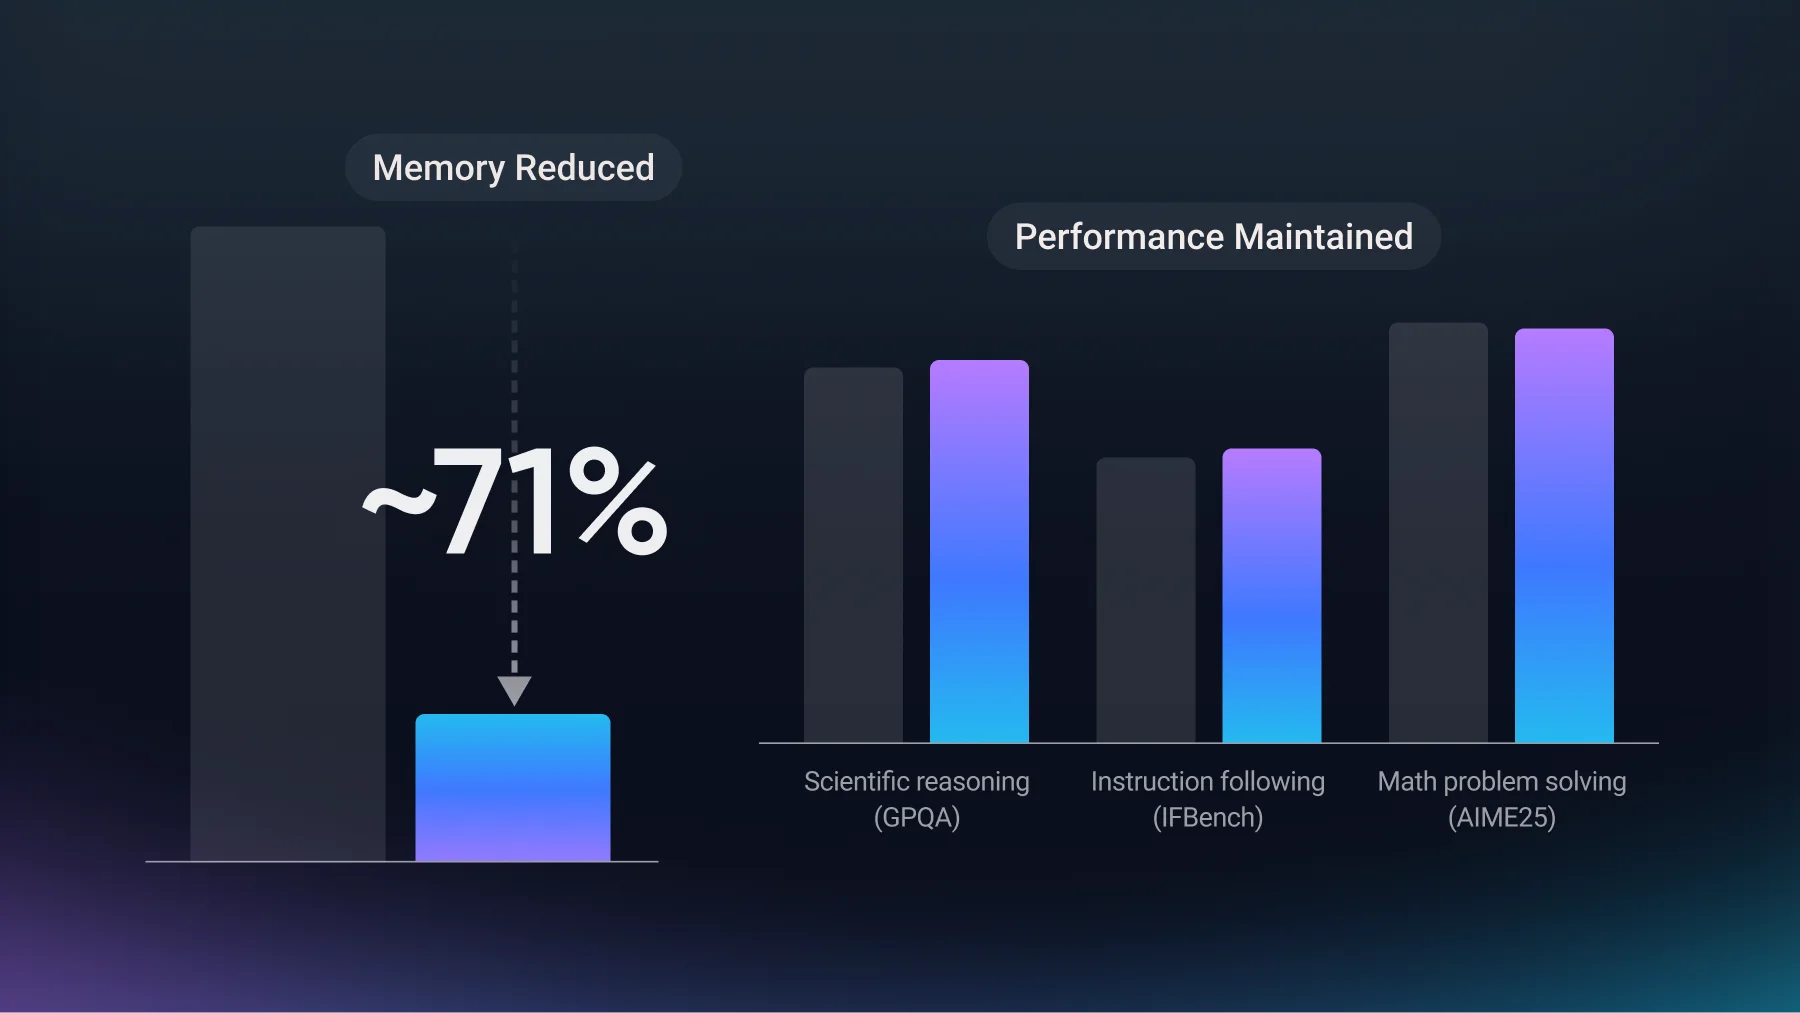
- BF16 대비 약 3.5배 모델 압축과 GPQA·IFBench·AIME 2025 정확도 차이의 오차 범위 유지
- 메모리 대역폭 병목인 MoE 추론에서 모델 크기 축소에 따른 추론 속도 약 1.5~2배 향상 가능성
- 벤치마크 수치의 특정 모델·하드웨어·설정 조합 의존성