AI
[넷츠프레소 딥다이브] 양자화부터 그래프 최적화까지, 단계별 모델 배포 파이프라인
두줄요약
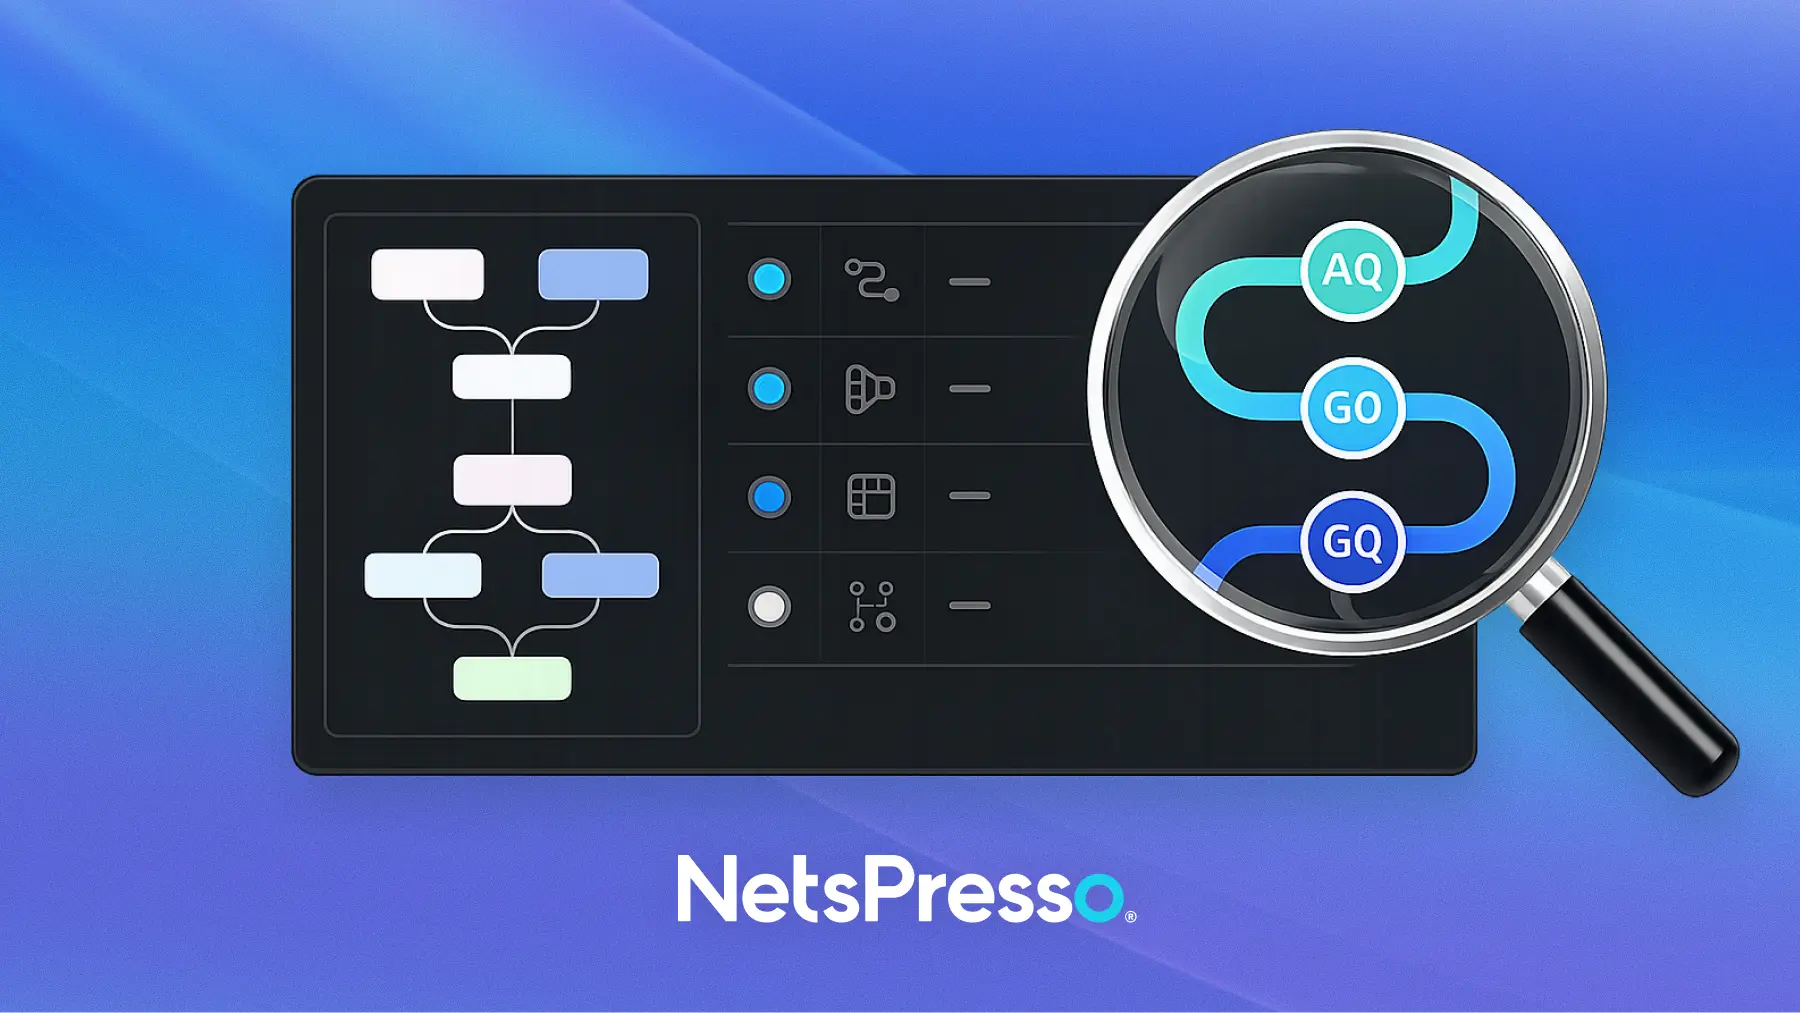
넷츠프레소의 AQ·GO·GQ 기반 모델 배포 파이프라인 구조를 설명했습니다. 양자화부터 그래프 최적화·온디바이스 검증까지의 흐름을 다뤘습니다.
문제 상황
- 엣지 디바이스별 미지원 연산자, 제한된 메모리·연산력, 파편화된 툴체인으로 인한 모델 배포 복잡성
- 양자화·그래프 변환·컴파일 단계마다 다른 입출력 포맷과 타깃 변경 시 반복되는 재검증 부담
구조와 흐름
- AQ에서 AWQ·GPTQ·AutoRound·HQQ 등 양자화 알고리즘 적용 및 공통 중간 표현 NPIR로 정규화
- GO에서 150개 이상 패턴을 바탕으로 타깃 하드웨어별 연산자 분해·교체·제거 수행
- GQ에서 Capability Map 기반 스킴 검증, 캘리브레이션, 레이어별 혼합 정밀도 자동 배정
- 컴파일러의 타깃 바이너리 생성과 프로파일러의 온디바이스 지연 시간·메모리 측정으로 연결
선택 이유
- 원본 레이어 맥락과 원자 연산 노드를 함께 보존하는 NPIR 기반의 단계 간 최적화 연계
- 하드웨어별 지원 연산·데이터 타입 차이를 반영한 그래프 변환과 Fail-Fast 검증
- 민감 레이어에 높은 정밀도를 배정하는 AMP 기반 정확도 손실 억제
성능/운영 포인트
- Llama 3.2 1B 예시에서 AQ 메모리 87% 절감, GO 지연 시간 17% 단축, GQ 추가 60% 단축
- 전체 예시 기준 지연 시간 67% 단축, 메모리 87% 절감과 PPL 27.63→31.30 변화
- 모델·하드웨어·설정 조합에 따른 벤치마크 결과 차이와 프로파일링 기반 검증 필요