AI
H100 8장을 2장으로: LLM 경량화가 만든 GPU 비용 절감
두줄요약
MoE 양자화와 비균일 전역 프루닝으로 LLM 가중치 메모리를 줄이는 사례를 소개했습니다. Solar Open2와 Kimi K3의 GPU 구성 축소 및 벤치마크 결과를 비교했습니다.
문제 상황
- LLM 서빙 시 고정 메모리 비중이 큰 가중치와 GPU 장수·비용의 직접적 연관성
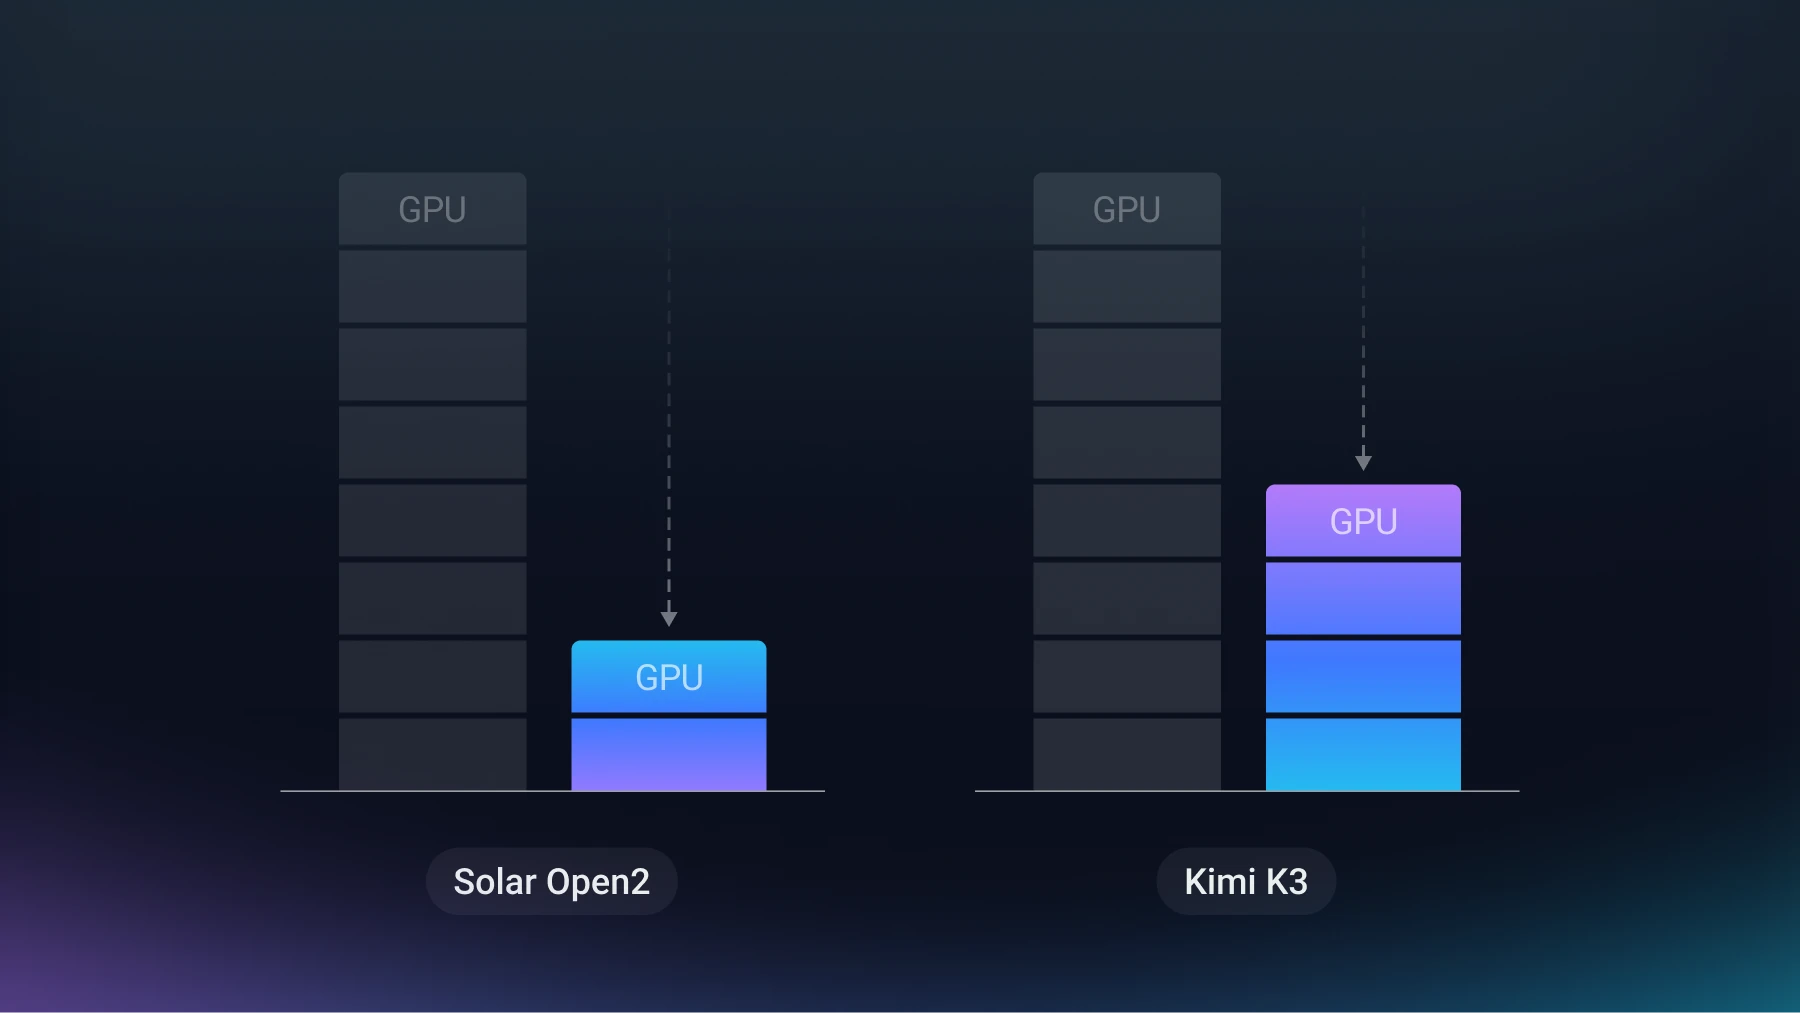
- Solar Open2 250B의 H100 8장 구성과 Kimi K3 2.8T의 B300 8장 권장 구성
해결 방법
- MoE 전문가 활성화 불균형을 보완하는 합성 캘리브레이션 데이터 기반 양자화
- 라우터 로짓 간격 보존을 위한 라우터 인지형 MoE 양자화
- 레이어별 전문가 수를 다르게 유지하는 비균일 전역 프루닝과 추론 엔진 수정
성능/운영 포인트
- Solar Open2 가중치 500.6GB에서 117.8GB로 축소, KV 캐시 포함 137.8GB로 H100 2장 구성
- Solar Open2 양자화 후 종합 벤치마크 0.4점 하락, 프루닝 후 고난도 추론 평균 0.6점 하락
- Kimi K3 25%·50% 프루닝으로 각각 B300 6장·4장 구성, 일부 고난도 과학 추론 태스크의 성능 하락
주의할 점
- 비균일 프루닝의 표준 체크포인트 형식 이탈과 추론 엔진 수정 필요성
- 모델·하드웨어·컨텍스트·배치 설정에 따른 메모리 및 성능 결과 변동