AI
노타의 MoE LLM 양자화 연구 2편, ICML 2026 워크숍에 나란히 이름을 올리다
두줄요약
MoE LLM 양자화에서 전문가 선택 경로를 보존하는 두 PTQ 기법을 소개했습니다. 라우팅 마진과 출력 민감 토큰을 활용해 저비트 성능을 개선했습니다.
문제 상황
- 모든 전문가 파라미터 상주에 따른 MoE LLM 배포 메모리 부담
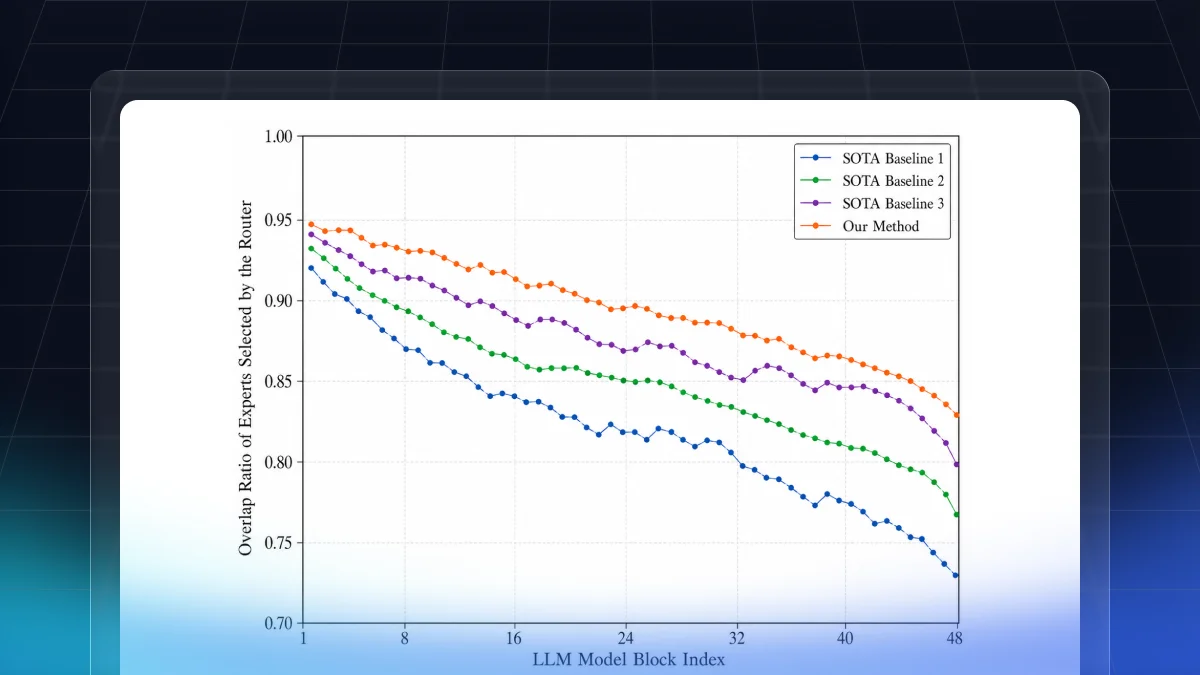
- 저비트 PTQ의 라우터 교란으로 상위 k 전문가와 연산 경로가 바뀌는 문제
해결 방법
- 선택 전문가와 경계 미선택 전문가 간 쌍별 마진 보존을 통한 전문가 순위 유지
- 로컬 복원 품질과 후속 블록의 다운스트림 라우팅을 함께 고려하는 캘리브레이션 목적 함수
- 출력 분포 변화 토큰만 식별해 집중 정렬하는 선택적 라우터 정렬
성능/운영 포인트
- 캘리브레이션 단계 적용으로 추론 시 추가 모듈과 연산 오버헤드 없음
- 전문가 순위 보존 기법의 6개 모델·비트 설정 중 5개 최고 평균 다운스트림 정확도와 최저 perplexity
- 선택적 정렬에 4비트 약 49%, 3비트 약 57% 토큰만 활용하면서 균일 정렬과 동등 이상 성능
적용해볼 점
- MoE PTQ 목표를 가중치 복원 오차 최소화에서 출력 영향을 주는 라우팅 구조 보존으로 전환
- 저비트 배포 시 라우팅 마진, 다운스트림 라우터, 출력 민감 토큰 기반 평가 병행