AI
GPU 없이 VLA 돌리기: 퀄컴 NPU에서 1.6초를 230ms로
두줄요약
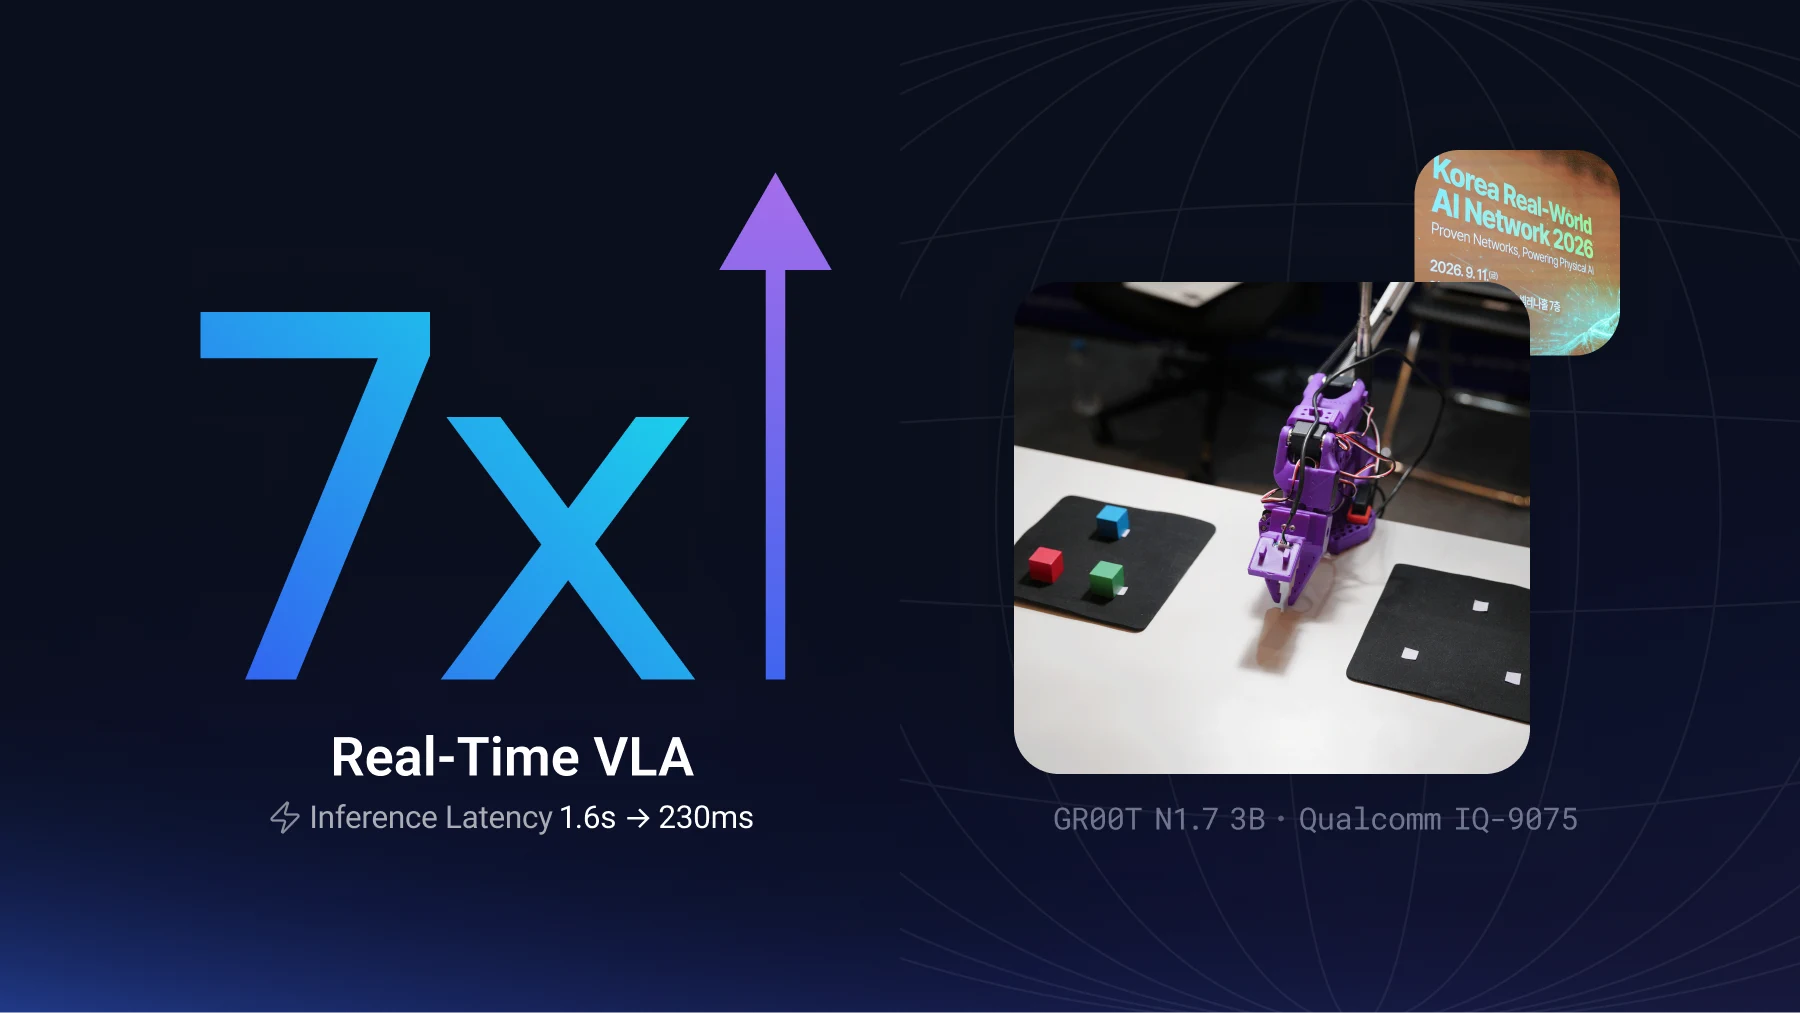
퀄컴 NPU에서 VLA를 실시간 구동하기 위해 백본·런타임·제어 루프를 함께 최적화했습니다. GR00T N1.7을 약 230ms까지 줄이고 RTC로 로봇팔의 연속 동작을 검증했습니다.
문제 상황
- 퀄컴 Dragonwing IQ-9075 NPU에서 VLA를 실시간 구동하기 어려운 높은 E2E 지연 시간
- SO-101 로봇팔의 액션 청크 실행 중 추론 지연에 따른 정지와 제어 루프 병목
구조와 흐름
- Vision Encoder·LLM·Action Head를 멀티 NPU에 분산하는 NQRR 런타임과 타깃 NPU 맞춤 그래프 재작성
- 백본 5종의 지연 시간·LIBERO 성공률·실기 성공률 비교를 통한 GR00T N1.7 선정
- 카메라 스레드 분리, 청크 경계 스무딩, RTC 기반 추론·동작 병렬화
선택 이유
- MolmoAct2는 LLM 제거 가정에서도 Vision Encoder와 Action Head만으로 실시간 상한 초과
- GR00T N1.7은 최적화 후 400ms 수준과 SO-101 실기 성공률 80%를 함께 충족
- 전시 구성은 최저 추론 시간보다 로봇팔 정지 없는 연속 동작을 우선해 RTC 선택
성능/운영 포인트
- GR00T N1.7 E2E 지연 시간 1,602.4ms에서 약 230ms로 단축
- 카메라 스레드 분리로 관측 지연 700ms에서 58ms, 팔 정지 시간 501ms에서 247ms로 감소
- RTC 적용 구성의 1시간 연속 구동에서 처리량 약 37% 증가, 평균 성공 시간 약 21% 단축