AI
[Nota AI Server] 온프레미스 LLM 구축, GPU 사기 전에 확인해야 할 것
두줄요약
온프레미스 LLM의 GPU 수는 모델 크기뿐 아니라 양자화·가지치기와 KV 캐시 조건을 함께 고려해야 합니다. Nota AI Server는 최적화와 서빙 구성을 사전 검증해 GPU 절감 구성을 제공합니다.
문제 상황
- 온프레미스 LLM 구축 시 원본 모델 크기만 기준으로 한 GPU 수 산정으로 과도한 장비 구매 가능성
- 동시 사용자 수와 긴 문맥에 따른 KV 캐시 메모리 증가, 모델별 상이한 어텐션 구조
해결 방법
- GPU 구매 전 INT4·NVFP4 양자화와 Global Pruning 적용 후 정확도 검증 기반의 GPU 구성 확정
- MoE 라우터의 전문가 순위 보존을 위한 양자화 캘리브레이션과 층별 전문가 중요도 기반 가지치기
- 모델별 vLLM·SGLang 서빙 설정, 병렬화, OpenAI 호환 API를 포함한 설치형 환경 제공
구조와 흐름
- 가중치 메모리와 KV 캐시 총량 산정 후 텐서 병렬 단위에 맞춘 GPU 수 결정
- 층별 전문가 수가 다른 가지치기 모델을 지원하도록 수정한 vLLM 모델 정의 적용
- 인증·사용량 한도·요청 큐·모니터링·로그와 128K 문맥·동시 사용자 20명 부하 검증 구성
성능/운영 포인트
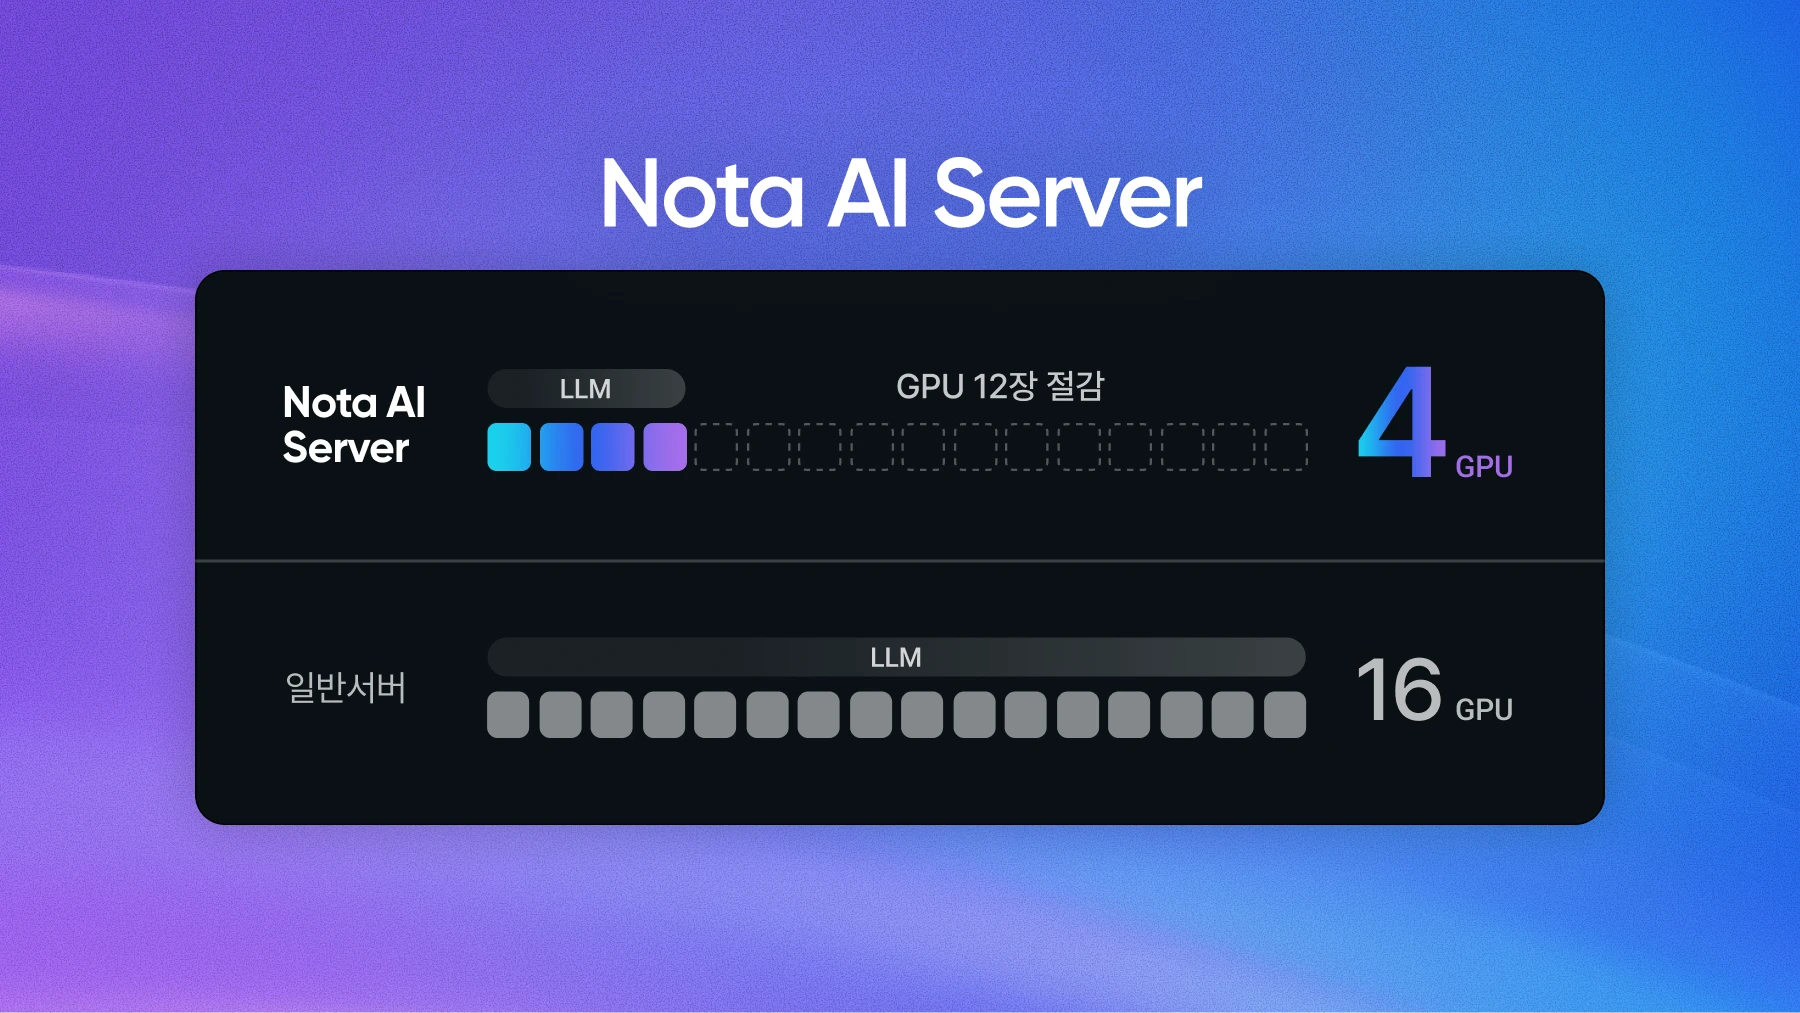
- Solar Open 2 250B급 모델의 RTX PRO 6000 구성 예시: BF16 16장 대비 4비트 양자화·Global Pruning 후 4장
- 최적화 모델의 VRAM 최대 73.5% 절감과 동시 사용자 증가 시 처리량 이득
- 폐쇄망용 Air-gap 패키징과 사내 데이터 기반 Private AI 운영 지원