AI
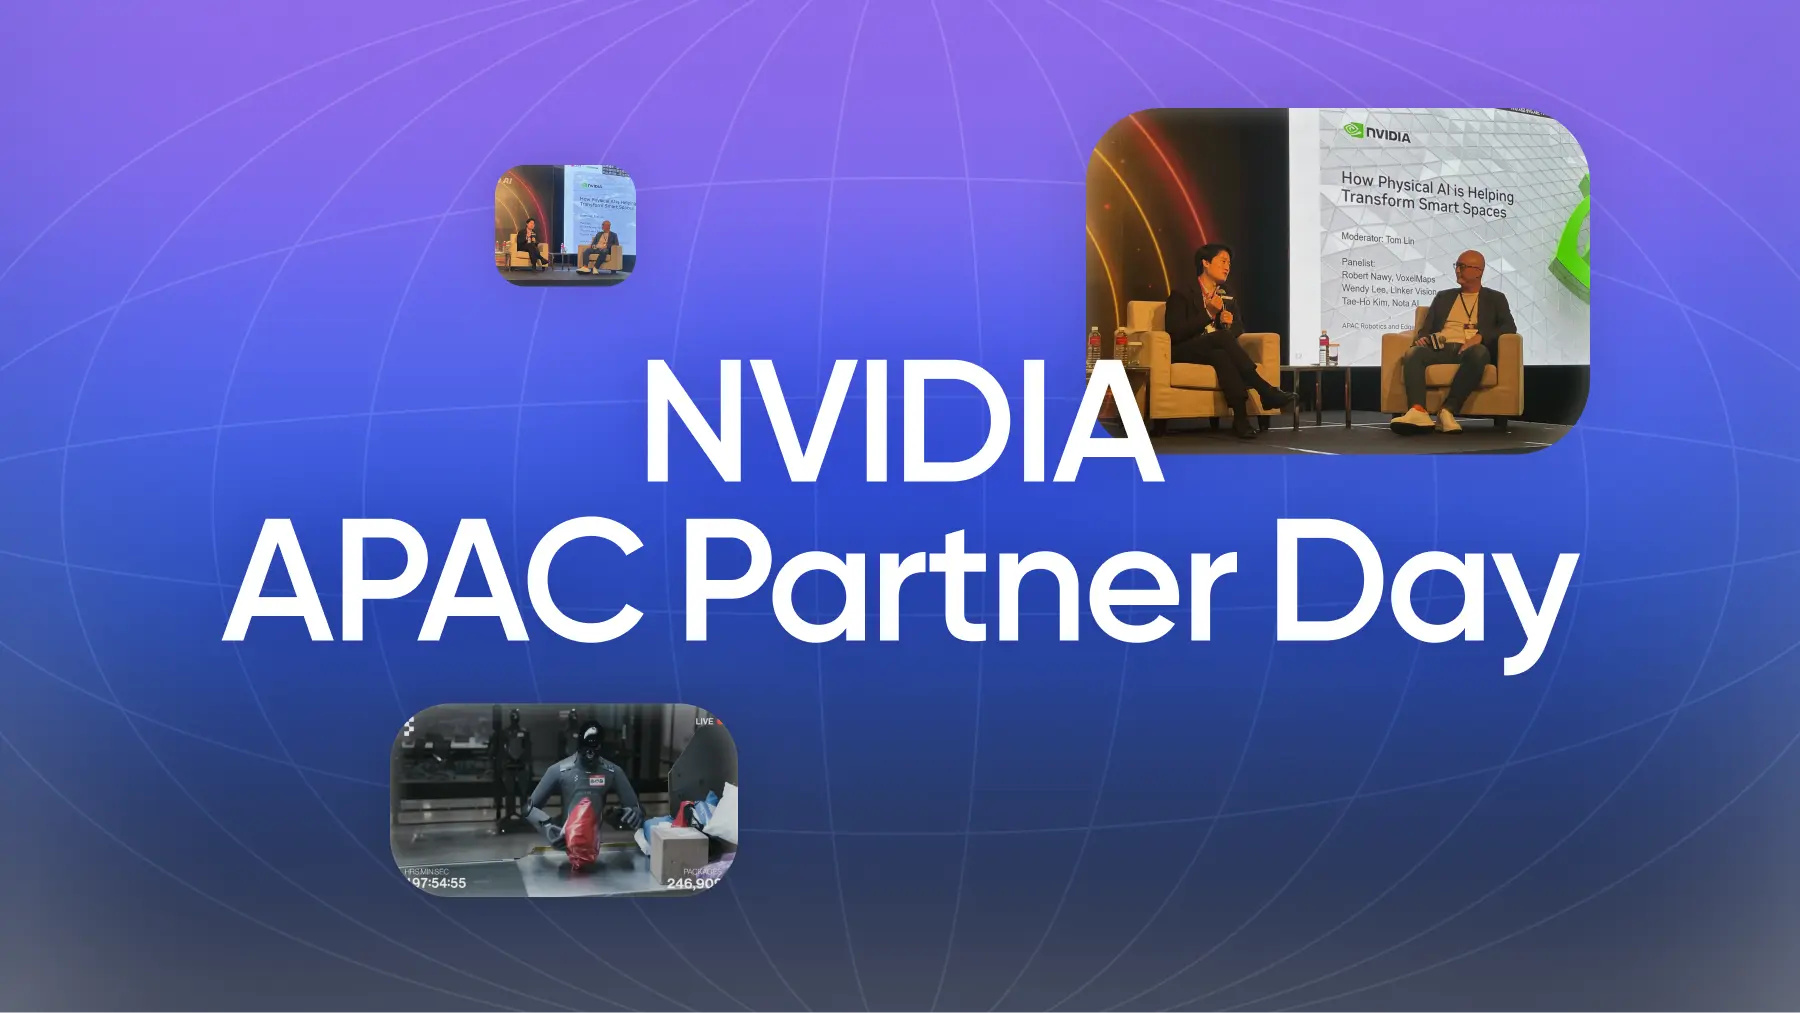
노타는 왜 엔비디아 아태 파트너데이 ‘한국 유일’ 패널이 되었나: 피지컬 AI의 마지막 퍼즐
두줄요약
피지컬 AI의 현장 적용을 위해 클라우드 대신 엣지 AI가 필요한 이유를 설명했습니다. 하드웨어 맞춤형 모델 최적화로 VLA 추론 지연을 줄인 사례를 소개했습니다.
구조와 흐름
- 피지컬 AI의 물리 환경 인식·판단·행동과 엣지 디바이스 내 실시간 구동 필요성
- VLA 모델의 비전 인코더·LLM·액션 헤드 연결 구조와 대규모 파라미터 요구
문제 상황
- 클라우드 의존 시 왕복 지연, 네트워크 단절, 통신·서버 비용, 민감 데이터 보안·규제 리스크
- 거대 VLM·VLA 모델과 전력·메모리·연산 능력이 제한된 엣지 하드웨어 간의 배포 간극
해결 방법
- 타깃 하드웨어 특성과 모델 구조를 함께 분석하는 넷츠프레소의 환경 맞춤형 엣지 최적화
- 비전 인코더·LLM 가중치 보존과 액션 헤드 추론의 선별적 효율화
성능/운영 포인트
- Qualcomm IQ-9075 기반 SmolVLA에서 작업 성공률 유지, 액션 헤드 지연 218ms에서 31ms로 단축
- 전체 추론 속도 1.63배 향상과 반복 작업 현장의 총처리량 개선 가능성