카페 아르바이트를 뽑는데, AI 대학원생이 지원을 했다.
MoE Gemma 4 26B의 전문가 절반을 가지치기해 노트북 내장 GPU에서 카페 주문 처리를 검증했습니다. 일반 지식은 감소했지만 64e는 실전 성능을 유지했으며, 과도한 가지치기는 사람 평가에서 드러났습니다.
#LLM#MoE#Gemma
10600
MoE 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 3개 · 많이 쓴 회사 노타·데보션·한글과컴퓨터
15개 표시
MoE Gemma 4 26B의 전문가 절반을 가지치기해 노트북 내장 GPU에서 카페 주문 처리를 검증했습니다. 일반 지식은 감소했지만 64e는 실전 성능을 유지했으며, 과도한 가지치기는 사람 평가에서 드러났습니다.
MoE 전문가 사용량 편중을 분석해 REAP 기반 절반 프루닝을 적용했습니다. 유저 지표 차이 없이 GPU당 대화 처리량을 1.6배로 높였습니다.

MoE의 토큰별 라우팅, 총·활성 파라미터, 밀집 구조 대비 계산 효율을 설명했습니다. 메모리 요구량과 양자화 난점, 이를 줄이는 NMQ 접근도 소개했습니다.
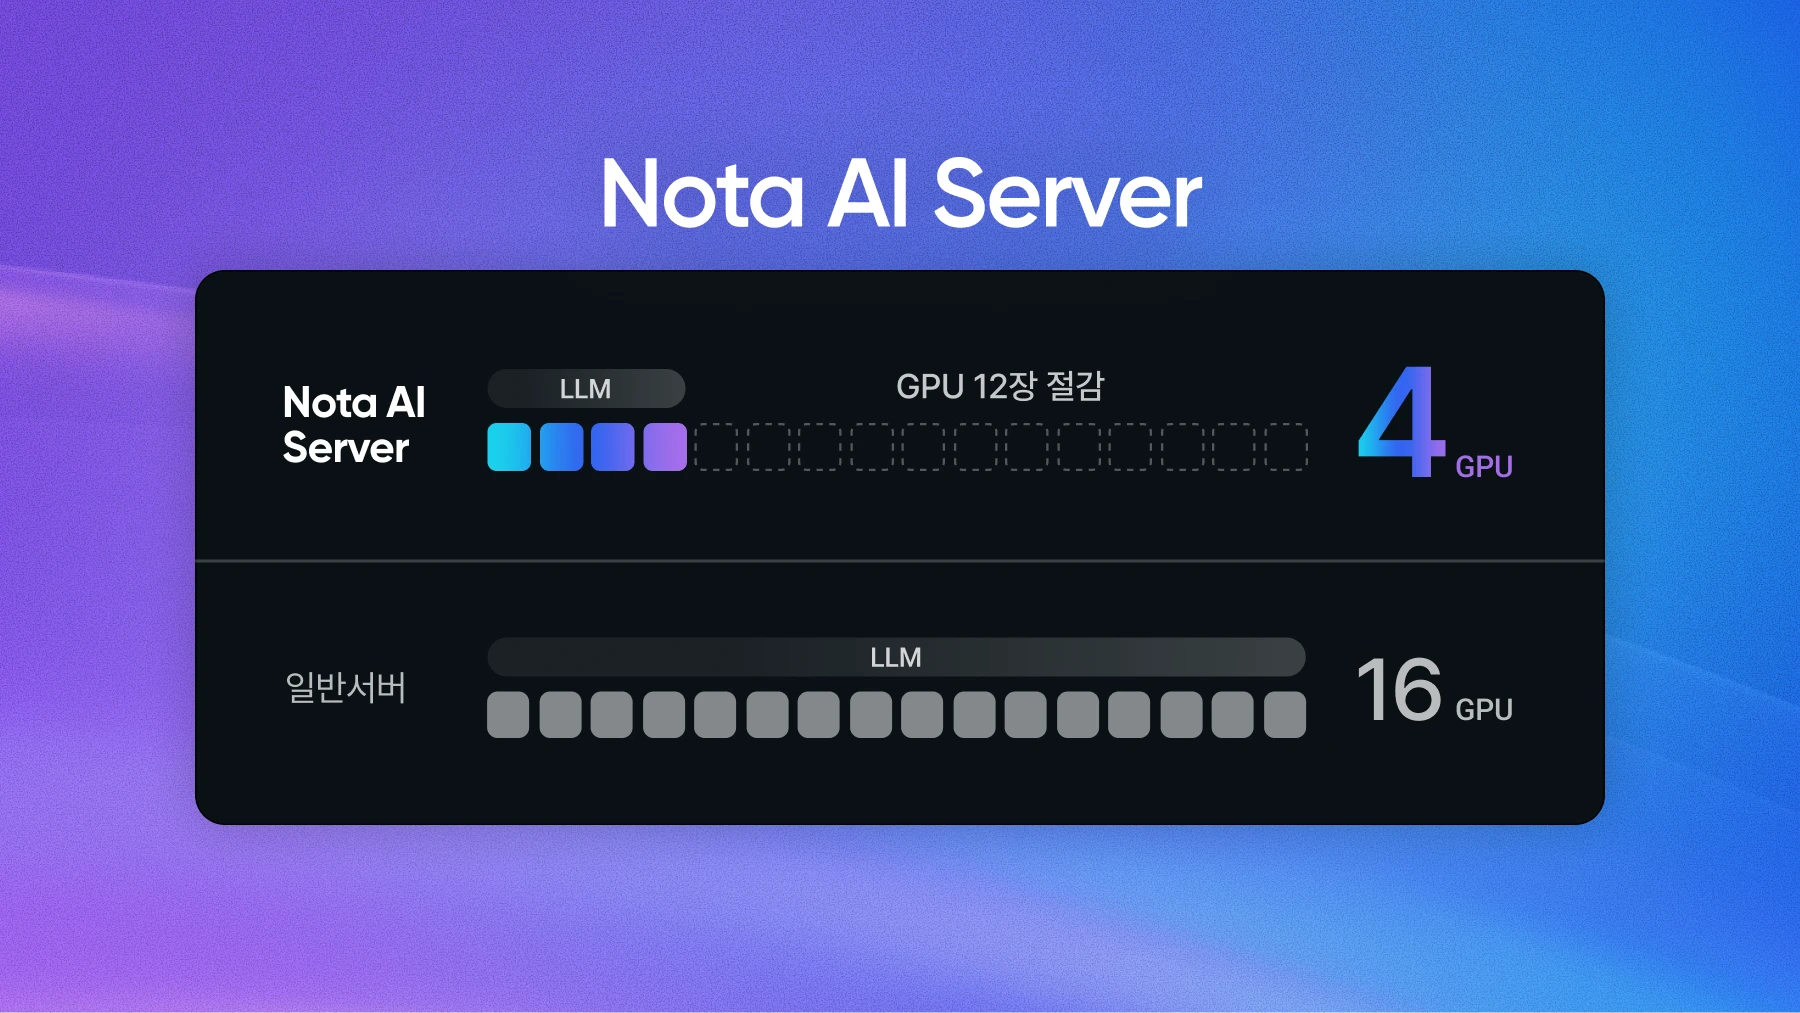
온프레미스 LLM의 GPU 수는 모델 크기뿐 아니라 양자화·가지치기와 KV 캐시 조건을 함께 고려해야 합니다. Nota AI Server는 최적화와 서빙 구성을 사전 검증해 GPU 절감 구성을 제공합니다.
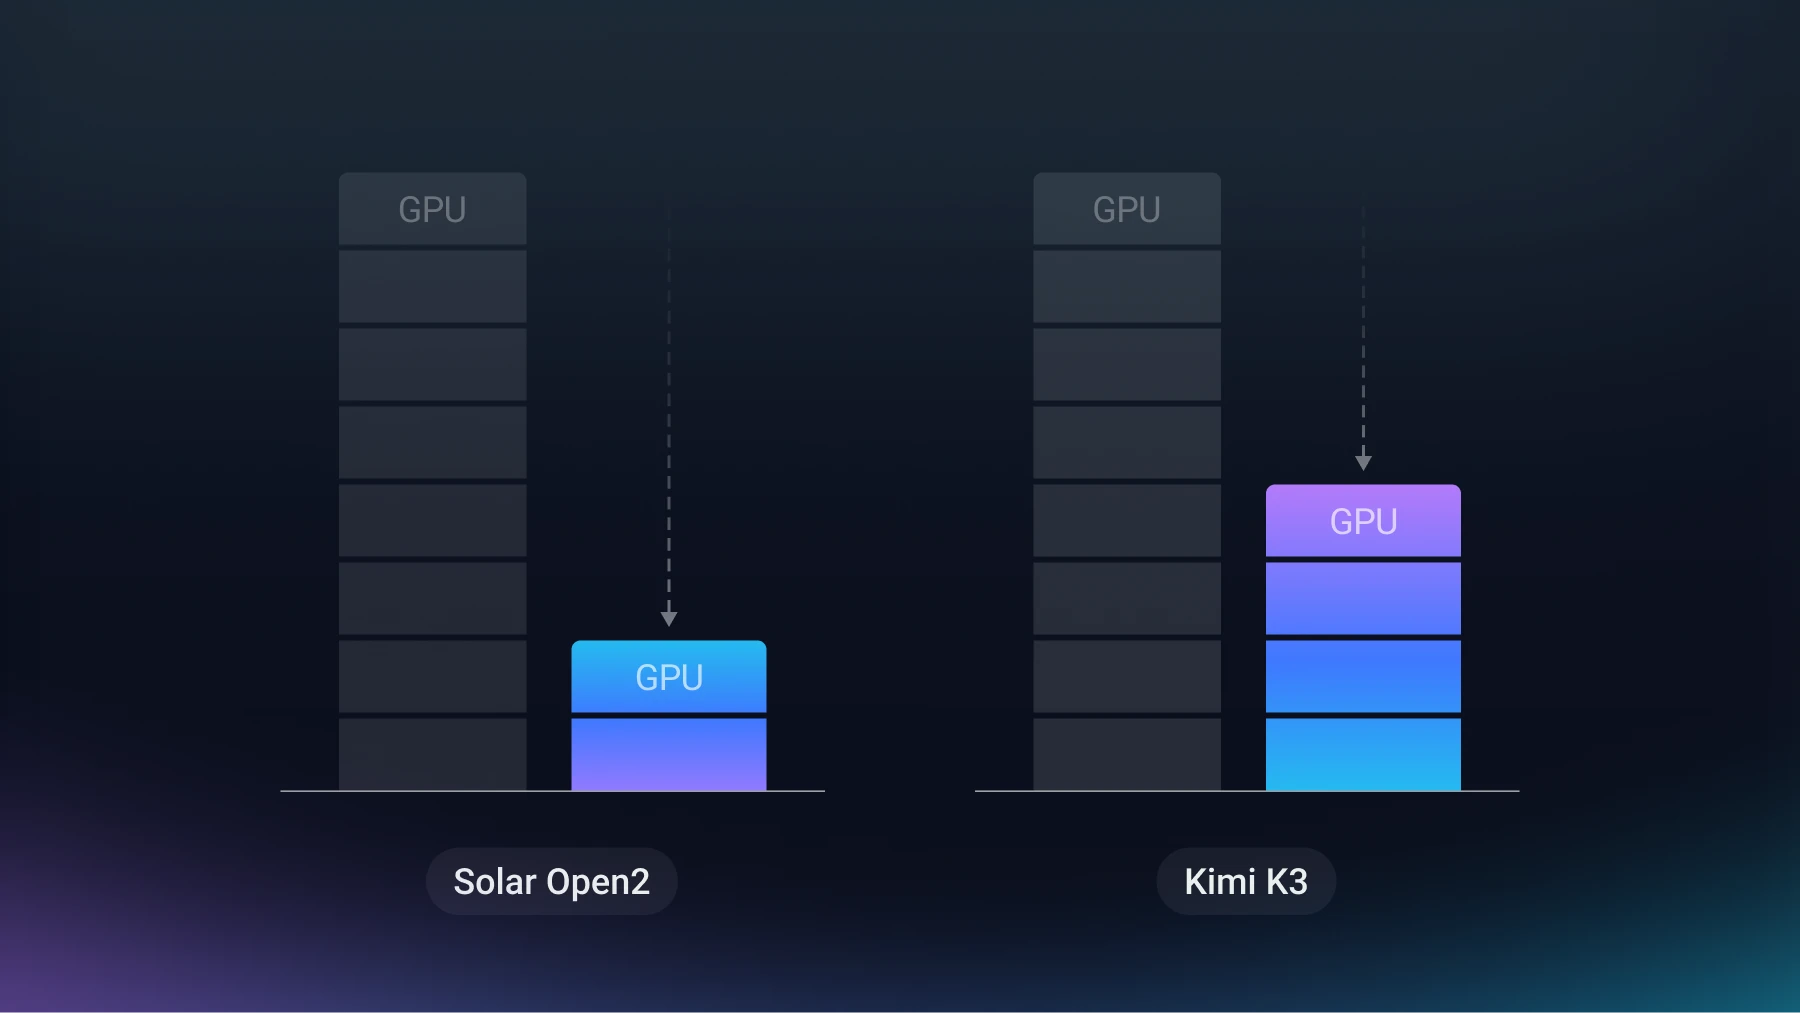
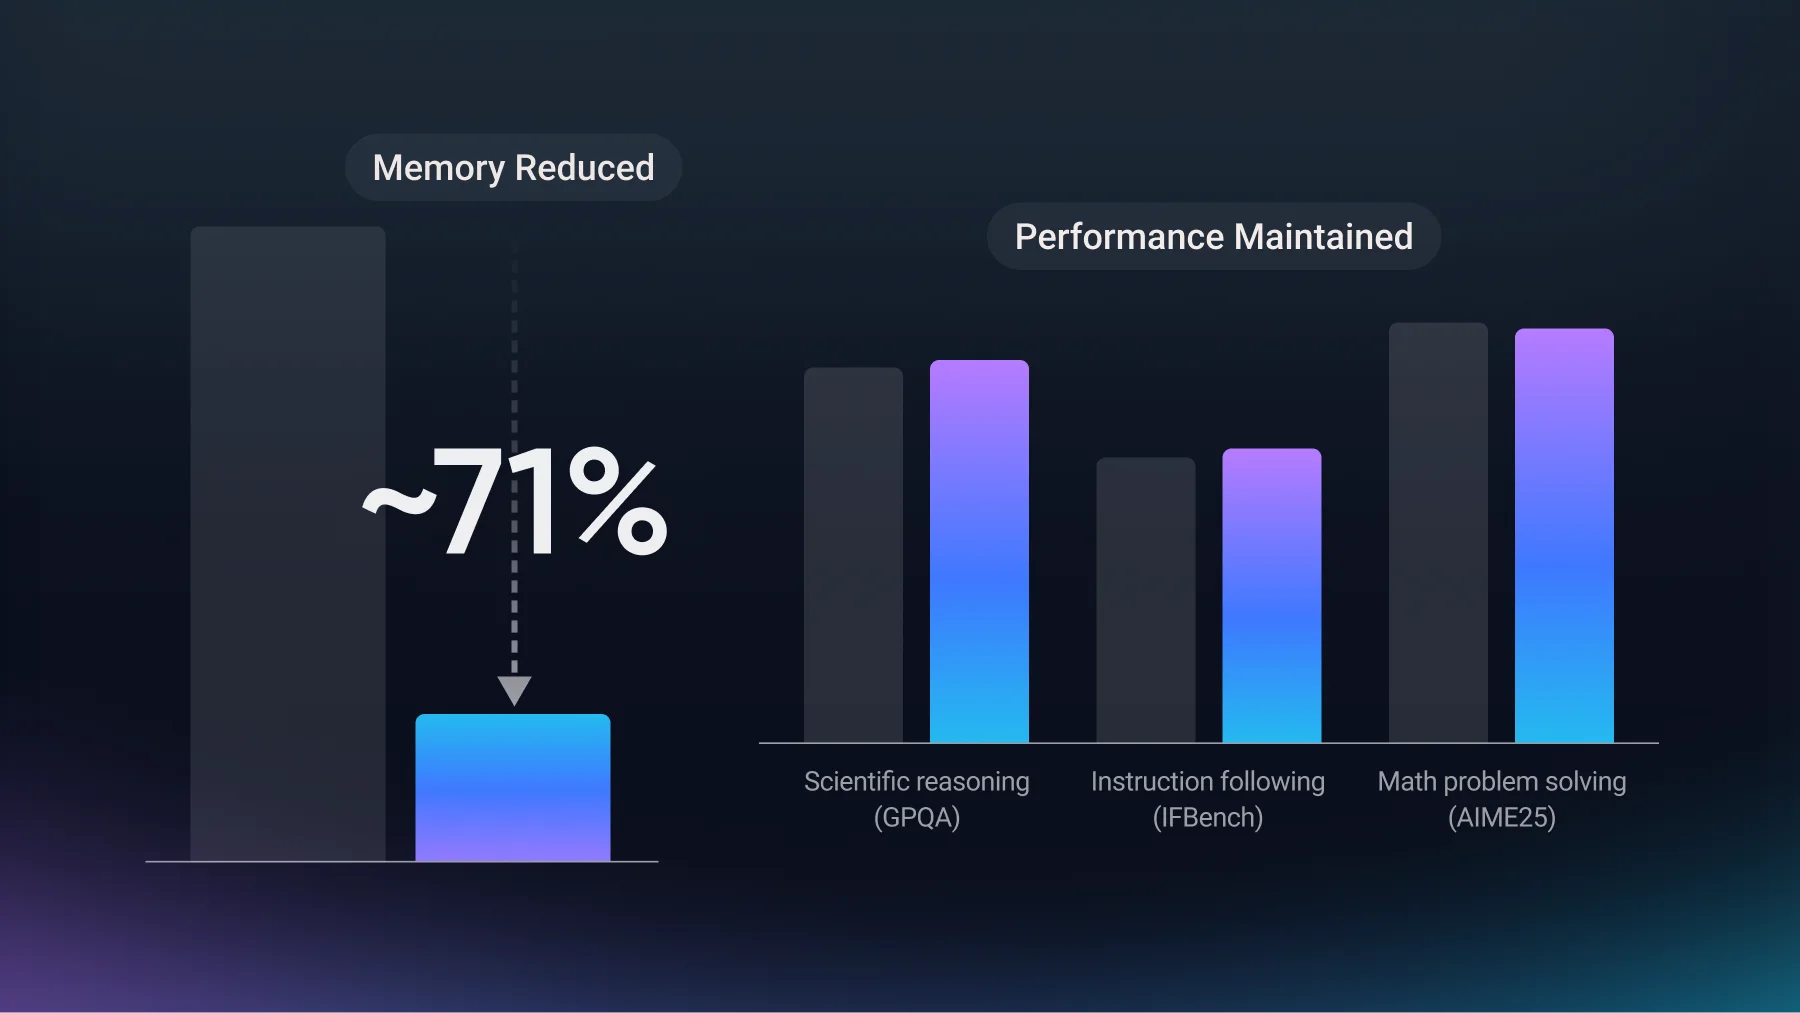
MoE 양자화와 비균일 전역 프루닝으로 LLM 가중치 메모리를 줄이는 사례를 소개했습니다. Solar Open2와 Kimi K3의 GPU 구성 축소 및 벤치마크 결과를 비교했습니다.
K-EXAONE-236B MoE의 집중 이상치를 오프라인 변환으로 제어해 NVFP4로 양자화했습니다. 추가 커널 없이 vLLM에서 서빙하며 BF16 수준 정확도와 약 3.5배 압축을 제시했습니다.
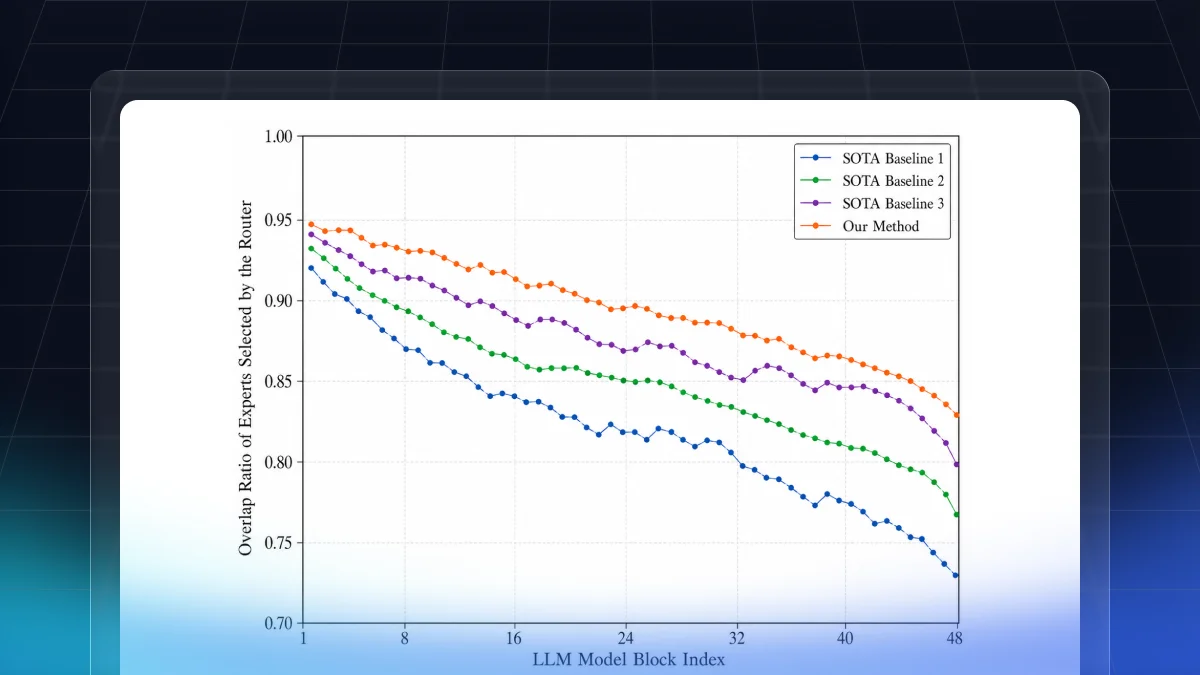
MoE LLM 양자화에서 전문가 선택 경로를 보존하는 두 PTQ 기법을 소개했습니다. 라우팅 마진과 출력 민감 토큰을 활용해 저비트 성능을 개선했습니다.
AI 에이전트 단독 양자화의 비용·검증·디바이스 호환성 문제를 분석했습니다. 넷츠프레소 파이프라인으로 재현 가능한 모델 최적화와 배포를 제안합니다.
Nemotron 해커톤에서 MoE 전문가 활성화와 양자화 민감도를 고려한 합성 데이터 파이프라인을 구현했습니다. 정량 평가와 데모를 바탕으로 Track C 및 종합 1위를 기록했습니다.
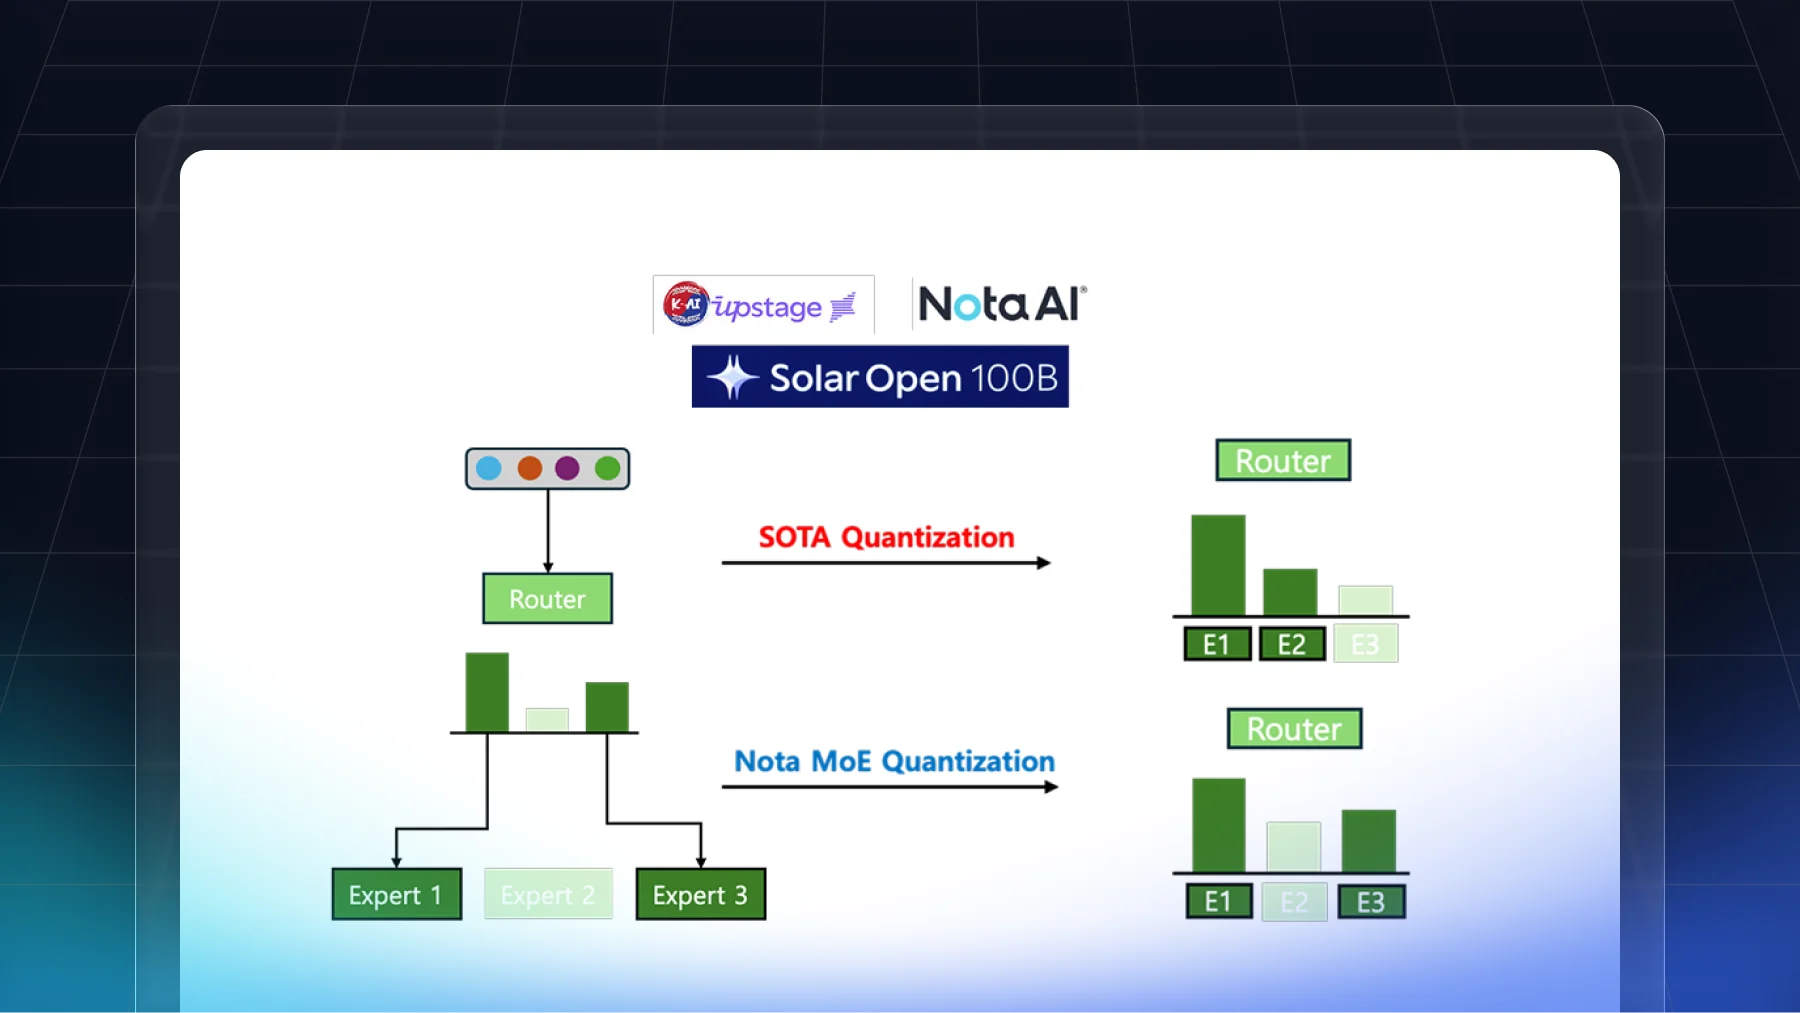
MoE 양자화의 재라우팅 문제를 줄이기 위한 NMQ 손실 함수를 소개했습니다. Solar-Open-100B에서 성능과 라우팅 일치도 개선을 확인했습니다.
단일 LLM 중심에서 벗어나 특화 모델을 조합하는 AI 아키텍처 전환을 설명했습니다.비용, 지연 시간, 정확성, 보안 한계를 줄이기 위한 오케스트레이션 전략을 정리했습니다.
LLM의 무작정 큰 모델 경쟁 한계를 짚고 MoE의 구조와 장점을 정리했습니다. 또한 실제 서비스에서 필요한 메모리, 통신, 로드 밸런싱 최적화 포인트를 설명했습니다.

Meta Llama 4 토크나이저의 한국어 효율과 주요 특성을 비교 분석했습니다. 독자 토크나이저, 강화된 챗 템플릿, 스페셜 토큰 구성도 함께 살펴봤습니다.

딥시크와 마누스의 등장으로 중국 오픈소스 LLM 생태계가 빠르게 다원화되고 있음을 정리했습니다. 딥시크는 고성능 개방형 LLM, 마누스는 자율 에이전트라는 서로 다른 방향을 보여주었습니다.
Snowflake가 기업 중심 LLM Arctic을 오픈소스로 공개하고, 낮은 훈련비용과 높은 성능을 강조했습니다. Dense-MoE 하이브리드 구조와 FP8 양자화로 추론 효율도 개선했습니다.