
전문가의 절반을 내보냈습니다
MoE 전문가 사용량 편중을 분석해 REAP 기반 절반 프루닝을 적용했습니다. 유저 지표 차이 없이 GPU당 대화 처리량을 1.6배로 높였습니다.
#LLM#MoE#model
3300

model 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 2개 · 많이 쓴 회사 노타·라인·타다
14개 표시
MoE 전문가 사용량 편중을 분석해 REAP 기반 절반 프루닝을 적용했습니다. 유저 지표 차이 없이 GPU당 대화 처리량을 1.6배로 높였습니다.
MoE의 토큰별 라우팅, 총·활성 파라미터, 밀집 구조 대비 계산 효율을 설명했습니다. 메모리 요구량과 양자화 난점, 이를 줄이는 NMQ 접근도 소개했습니다.
Disrupting a coordinated model-distillation campaign
OpenAI가 보호된 모델 추론을 추출하려는 조직적 적대적 증류 캠페인을 차단했습니다. 재생 경로와 스트리밍 출력 보호를 강화하고 업계와 위협 정보를 공유합니다.
Our framework for reporting model misalignment
OpenAI가 모델 정렬 실패 사례를 조사·공개하는 프레임워크와 첫 6건의 보고서를 공개했습니다. 원인 규명 전에도 투명성을 우선하되, 제3자 관련 보안·법률 의무를 우선합니다.
if(kakao)2026 첫째 날의 기술 세션 주제와 구성을 소개했습니다. AI 방향성 세션에서 Kanana SLM 개발 노하우를 공유합니다.
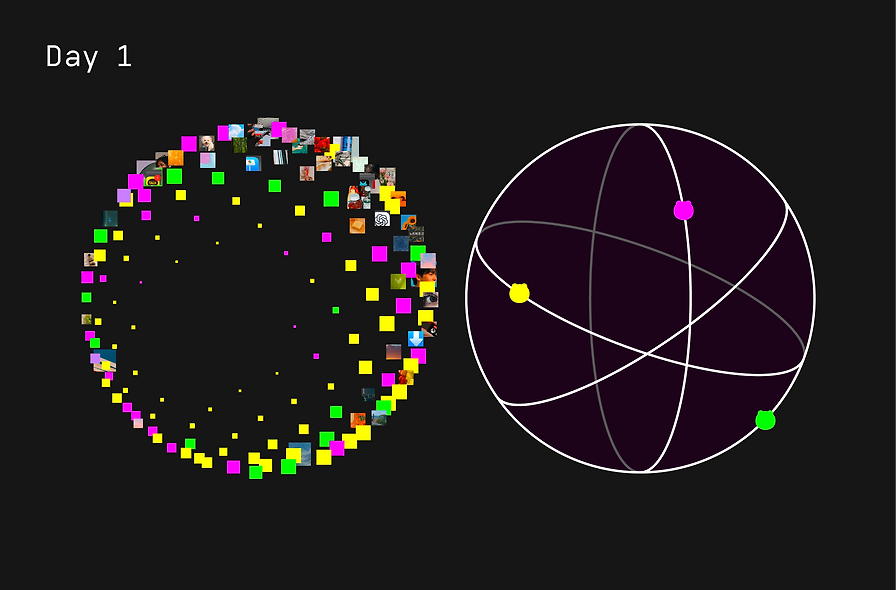
Path to Astra: critical capabilities and frontier safeguards
OpenAI는 Astra가 Critical 사이버보안 역량 임계값을 충족했다고 밝혔습니다. 초기에는 제한된 테스터와 Daybreak Blue를 통해 방어적 사용을 확대합니다.
미리캔버스의 여러 검색 과제를 하나의 임베딩 공간으로 묶기 위한 모델 개발 과정을 소개했습니다. 태스크별 운영의 한계를 줄이고 디자인 도메인 특성에 맞게 학습한 방식이 핵심이었습니다.
Predicting model behavior before release by simulating deployment
OpenAI가 실제 대화 맥락을 재생해 출시 전 모델 행동을 예측하는 방법을 소개했습니다. GPT‑5‑series Thinking에서 위험 빈도 추정과 신규 오정렬 탐지에 활용했습니다.
미저장 연락처의 관계를 예측하는 AI 기능 고도화 과정을 소개했습니다. 데이터 정제와 LLM 학습으로 정확도를 13% 이상 높였습니다.

함수는 값이 이미 확인됐다는 암묵적 가정에 의존하지 않도록 설계해야 합니다. 내부 검증, 반환값 처리, 타입 보장으로 책임을 명확히 나누는 방법을 소개했습니다.
서비스용 LLM을 성능 저하 없이 소형화하는 경량화 레시피를 소개했습니다. 제목 추천과 키워드 추출 사례로 실무 적용 방식을 다뤘습니다.
티맵에서 집 등록을 유도하고 집 추천을 강화한 사례를 다루고 있습니다. CDP와 딥러닝 모델링으로 내비게이션 편의성을 높이는 방향을 소개합니다.
정산 도메인에 DDD와 MDD를 적용해 흩어진 지식과 강결합 구조를 정리했습니다. 모델을 단순화하고 책임을 분리해 가독성과 확장성을 높였습니다.

DynamoDB의 핵심 개념과 설계 기준을 RDBMS ERD 관점에서 정리했습니다. Access Pattern을 먼저 정의하고 Reverse Modeling으로 테이블과 인덱스를 설계하는 흐름을 설명했습니다.