프론티어 모델 대신, 우리 모델이 모든 상담을 분석합니다
상담 분석 세 작업을 자체 멀티태스크 모델로 전환해 상용 LLM보다 높은 성능을 확보했습니다. 골든셋 기반 평가와 서빙 최적화로 비용을 99.4% 절감하고 운영 체계를 구축했습니다.
#LLM#ML#LoRA
3800
LoRA 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
많이 쓴 회사 데보션·노타·라인
12개 표시
상담 분석 세 작업을 자체 멀티태스크 모델로 전환해 상용 LLM보다 높은 성능을 확보했습니다. 골든셋 기반 평가와 서빙 최적화로 비용을 99.4% 절감하고 운영 체계를 구축했습니다.
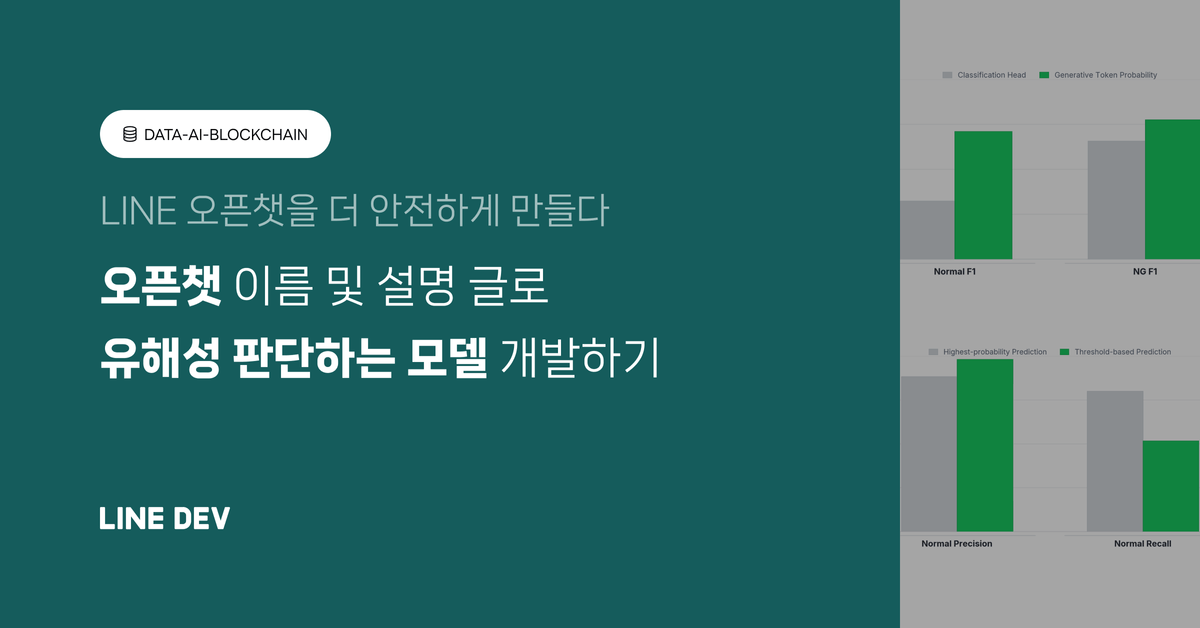
오픈챗 이름과 설명 글로 유해성을 판단하는 모니터링 모델 개발 과정을 소개했습니다. 디코더 기반 분류와 임곗값 조정으로 자동 검수 범위를 넓혔습니다.
금융보안 AI 경진대회에서 24GB 단일 GPU 제약 아래 LLM 파이프라인을 설계하고 우수상을 수상한 과정을 정리했습니다. 모델 선정부터 CPT, RAG, 양자화, 출력 제어까지의 선택 이유와 성능 개선 결과를 공유했습니다.
올리브영이 Gemma 3-4B 기반 sLLM을 단일 T4 GPU 환경에서 학습해 리뷰 테마 추천에 적용한 사례를 다뤘습니다. 상용 API 대비 재현성과 비용 통제력을 높이고, 프롬프트 단축과 최적화로 실서비스 품질을 확보했습니다.
vLLM의 핵심 기술과 성능 최적화 옵션, 그리고 v1 엔진의 구조 개선을 정리했습니다. 기능 호환성과 운영 단순성을 높이면서 성능을 끌어올린 흐름을 함께 설명했습니다.

Hugging Face API를 활용해 GPU에서 딥러닝 모델을 학습하는 흐름과 메모리 사용 구조를 설명했습니다. 또한 Gradient Accumulation, Checkpointing, LoRA, QLoRA로 메모리를 줄이는 방법을 소개했습니다.

LLM 파인튜닝에서 배치 크기, 시퀀스 길이, 메모리 최적화 기법의 영향을 실험 기반으로 정리했습니다. GPU 제약과 데이터 특성에 맞춰 직접 실험하며 최적값을 찾는 접근을 강조했습니다.

에이닷 전화 통화요약 서비스에 적용한 LLM 개발 과정을 소개했습니다. 자동·수동 데이터를 결합한 학습과 LoRA 기반 미세조정, 전문가 평가로 품질을 높였습니다.

ICML 2024에서 발표한 이상탐지 연구와 현장 경험, LLM 관련 주요 동향을 함께 정리했습니다. 라벨 없는 데이터의 이상탐지 알고리즘과 alignment·효율화·in-context learning 흐름을 간단히 소개했습니다.

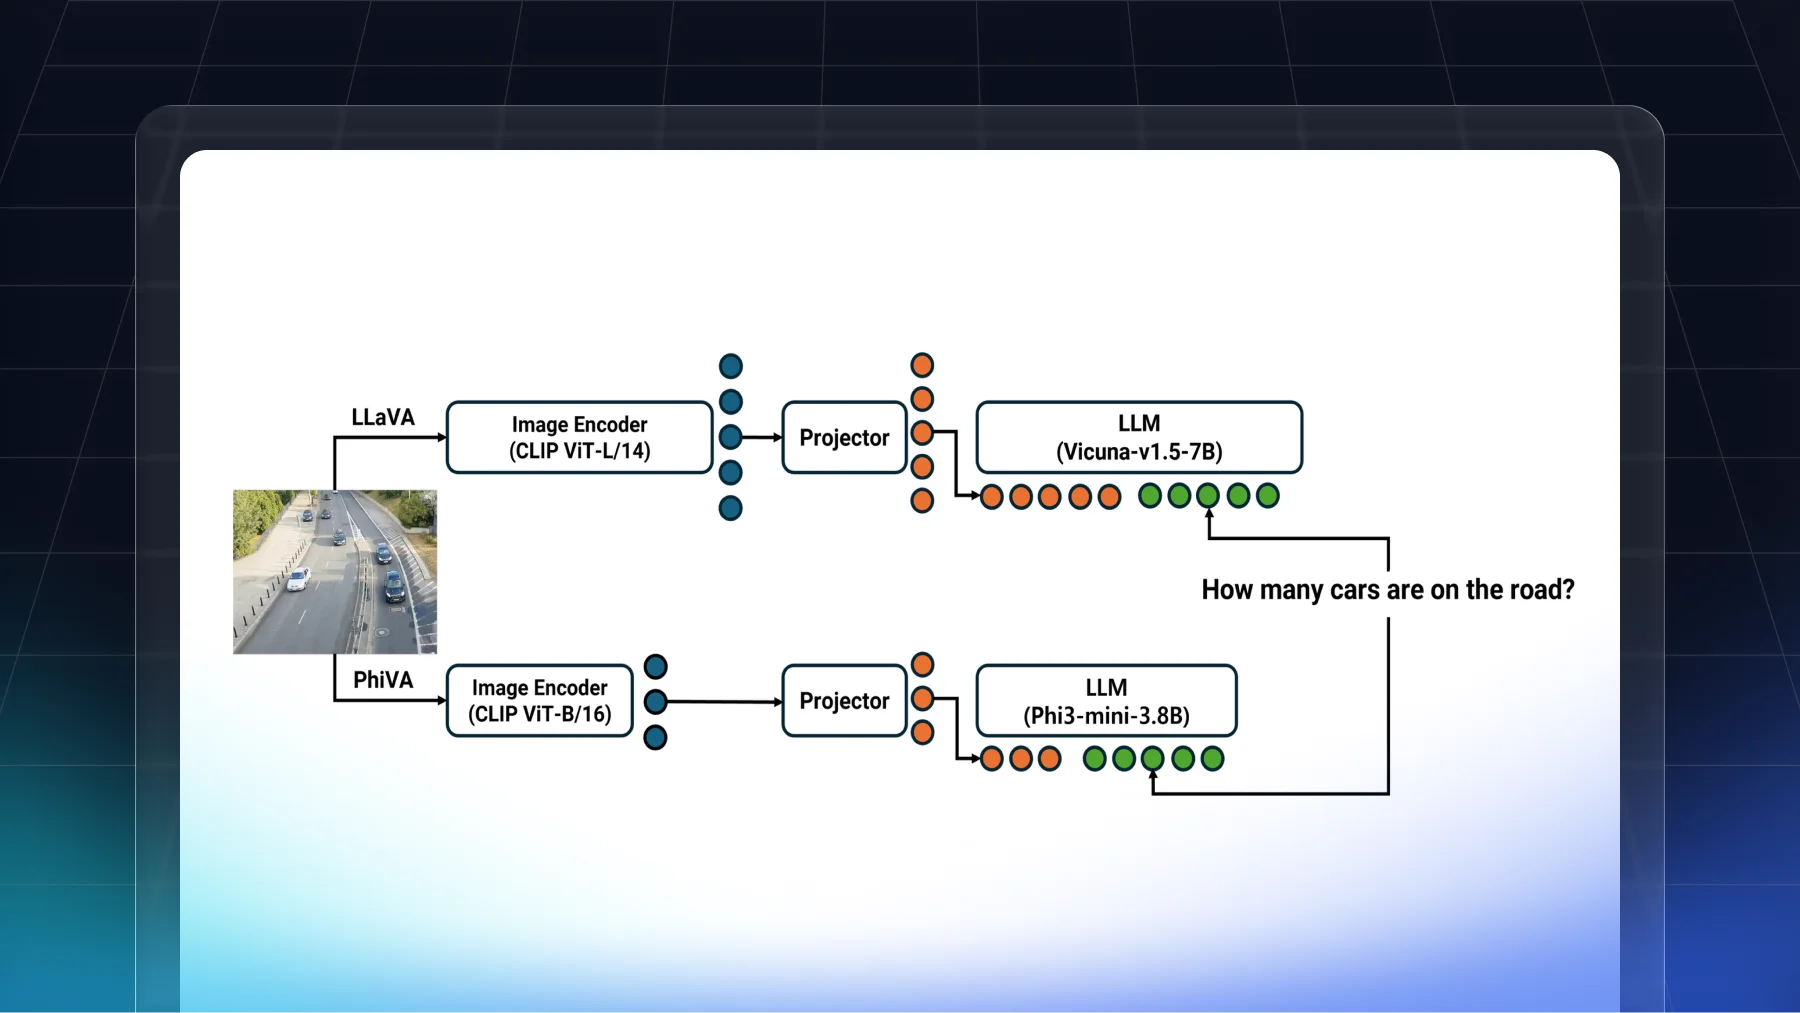
LLaVA를 Phi-3-mini와 CLIP ViT-B/16 기반 PhiVA로 경량화해 모바일 배포 과정을 설명했습니다. Galaxy 24 Ultra에서 이미지 인코딩 지연 시간을 37초에서 6초로 줄이고 디코딩 속도를 높였습니다.
언어 모델의 fine-tuning 성능을 높이는 LoRA, TAPT, DAPT, Adversarial Training을 소개했습니다. 대규모 전체 학습보다 비용과 효율을 고려한 적용 방향을 정리했습니다.
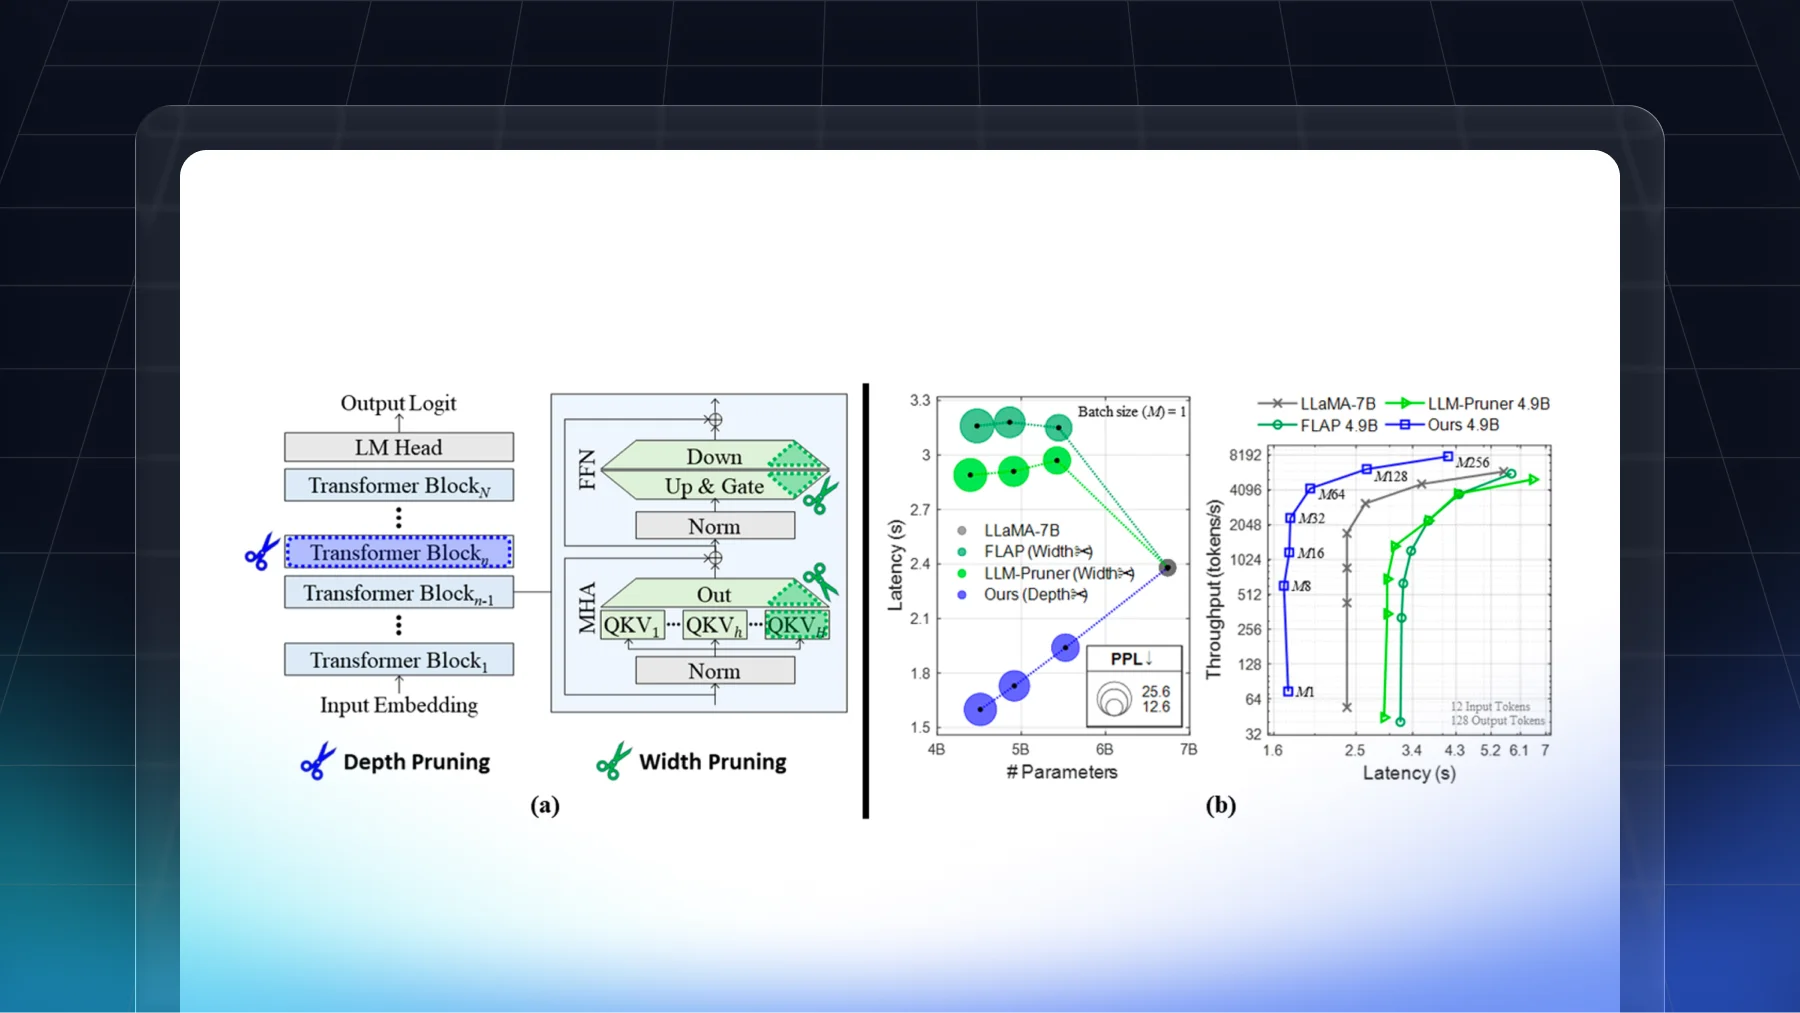
트랜스포머 블록을 제거하는 깊이 가지치기로 LLM 추론 비용과 지연을 줄였습니다. 소규모 배치 환경에서 너비 가지치기보다 빠른 생성 속도와 경쟁력 있는 성능을 보였습니다.