AI
축약된 LLM: 대형 언어 모델을 위한 간단한 깊이 가지치기 방법
두줄요약
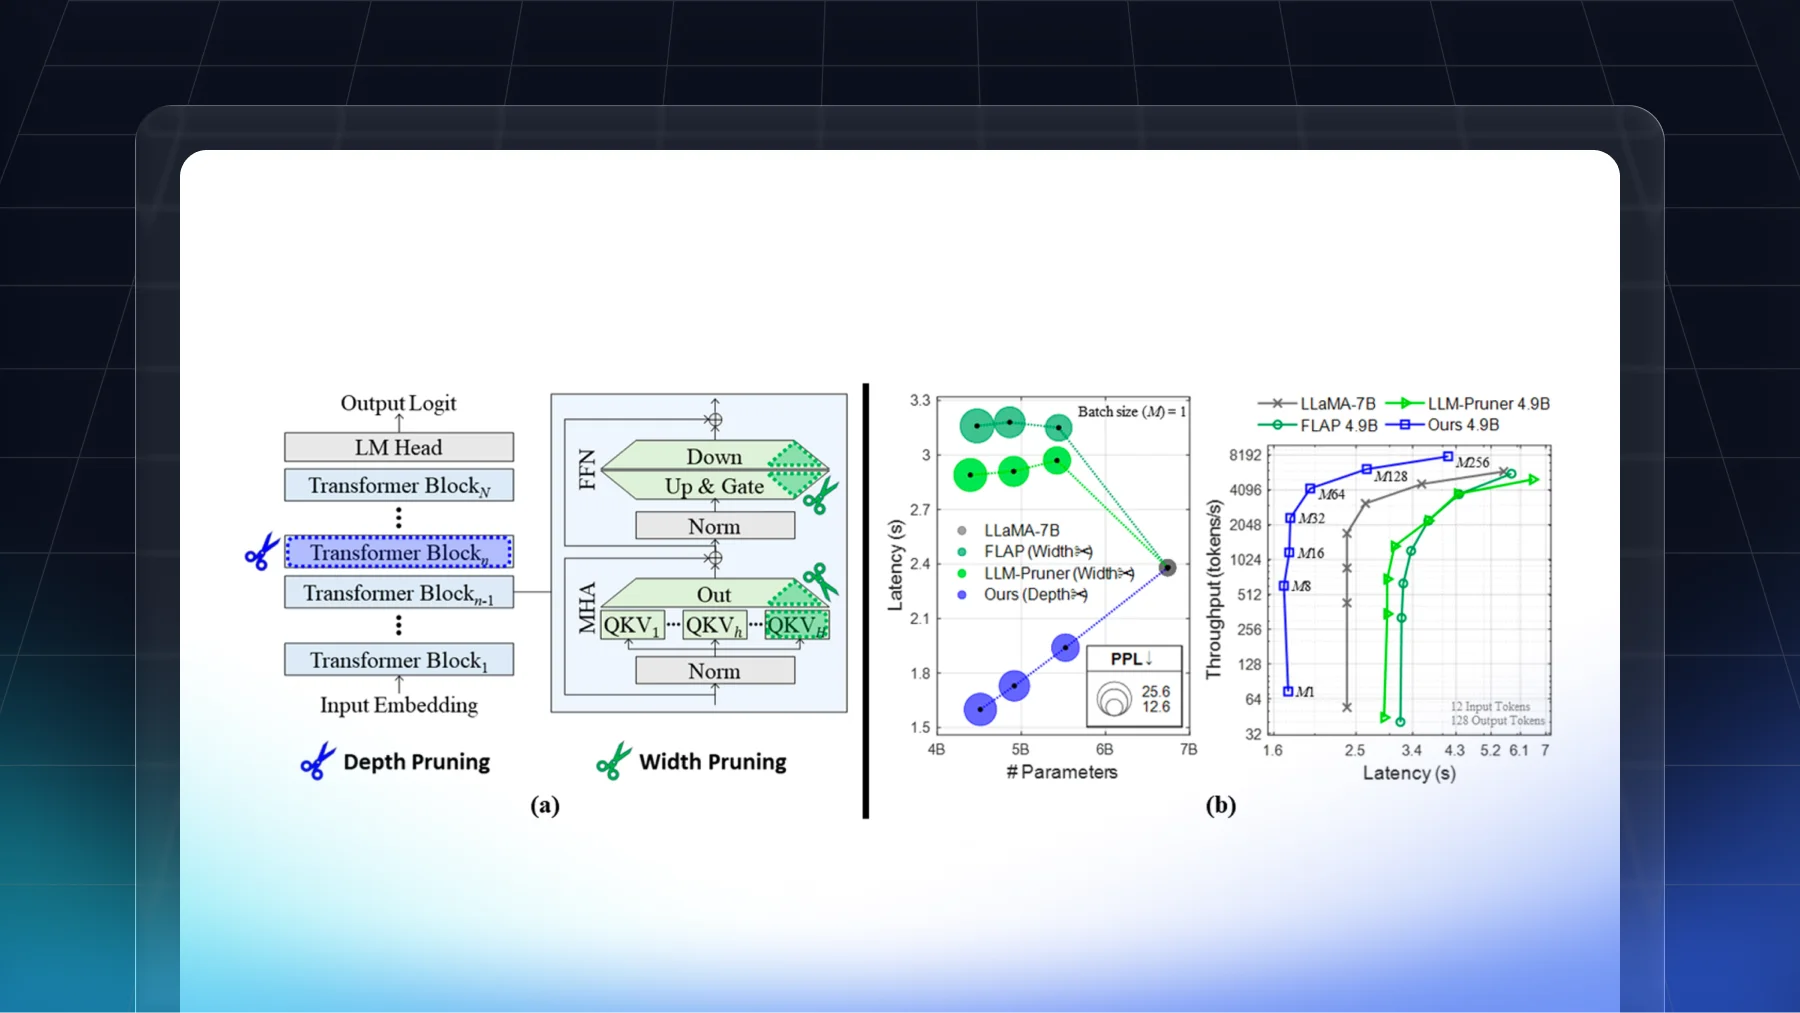
트랜스포머 블록을 제거하는 깊이 가지치기로 LLM 추론 비용과 지연을 줄였습니다.\n소규모 배치 환경에서 너비 가지치기보다 빠른 생성 속도와 경쟁력 있는 성능을 보였습니다.
구조와 흐름
- 트랜스포머 블록의 중요도 산정 후 중요도가 낮은 블록을 일회성 제거
- 가지치기 네트워크의 생성 성능 회복을 위한 LoRA 재훈련
선택 이유
- 소규모 배치·메모리 제약 환경에서 가중치 크기보다 메모리 제한의 큰 영향
- 너비 축소 대신 트랜스포머 블록 완전 제거를 통한 실질적 추론 가속 목표
성능/운영 포인트
- LLaMA-1-7B·Vicuna-v1.3-13B에서 너비 가지치기 대비 생성 속도 향상
- WikiText-2의 경쟁력 있는 PPL 및 유사한 제로샷 성능
- GPU 성능에 맞지 않는 너비 가지치기 가중치 크기의 속도 저하 가능성
적용해볼 점
- 로컬 장치 배포 전 블록별 중요도 기반 깊이 가지치기 검토
- 가지치기 후 LoRA 기반의 메모리 효율적 성능 복구 적용