
[AI Ready Data] 표와 예외 조건을 지키는 문서 변환 결과 검증
문서 변환 결과에서 표·단위·예외·출처를 보존하고 구조와 업무 의미를 검증하는 방식을 설명합니다. 대체 변환 기록과 프로세스 격리로 실행 장애 및 품질 검토 범위를 관리합니다.
#Databricks#Python#JSON
400
[AI Ready Data] 표와 예외 조건을 지키는 문서 변환 결과 검증
JSON 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 2개 · 많이 쓴 회사 넥스트리·뱅크샐러드·라인
17개 표시
문서 변환 결과에서 표·단위·예외·출처를 보존하고 구조와 업무 의미를 검증하는 방식을 설명합니다. 대체 변환 기록과 프로세스 격리로 실행 장애 및 품질 검토 범위를 관리합니다.
최상위 제어 입력과 고비용 라벨 함수가 결합한 댓글 타이핑 지연을 측정해 원인을 분석했습니다. ref 기반 비제어 입력으로 전환해 리렌더와 라벨 호출을 제거하고 입력 성능을 개선했습니다.
Build more responsive apps with the Decisions API
OpenAI가 GPT‑6 Luna 기반 Decisions API를 정식 출시했습니다. 빠른 분류·라우팅·다음 작업 선택을 위해 GPT‑Live 통합과 JSON·이미지 입력을 지원합니다.
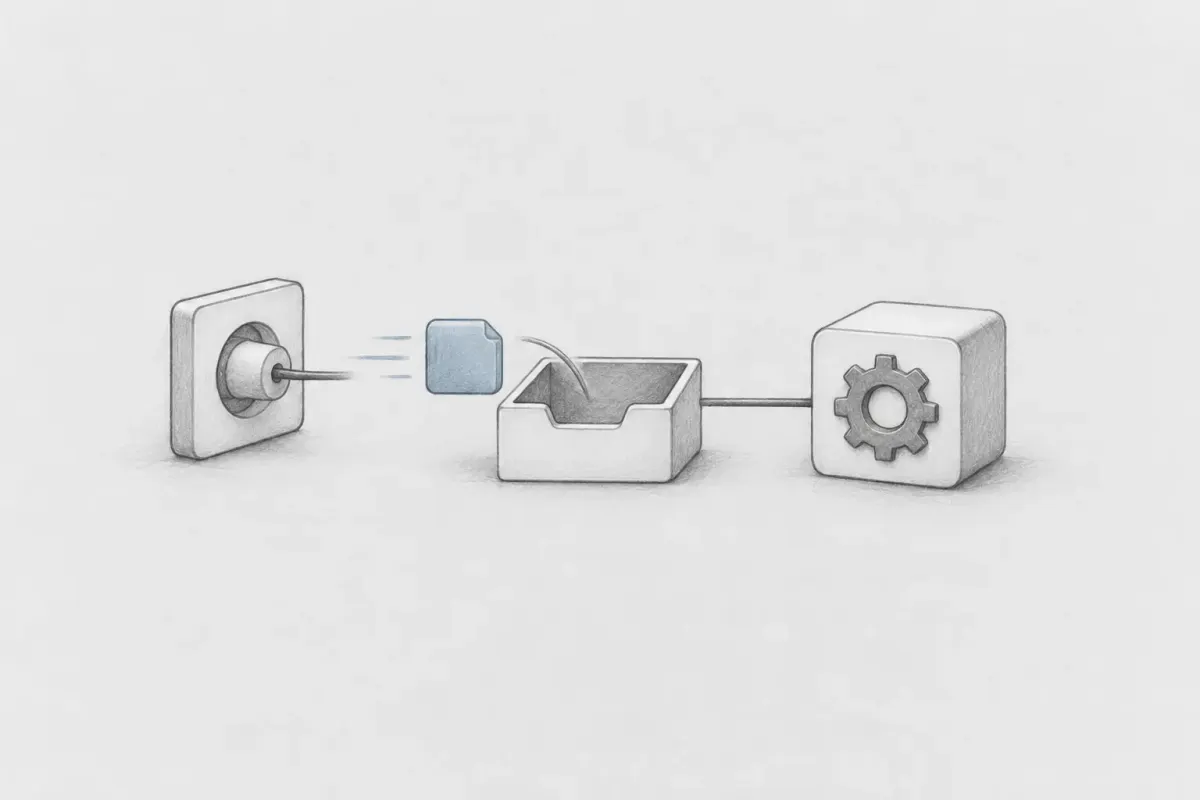
외부 API 수신과 실제 데이터 처리를 분리한 구조를 소개했습니다. 요청은 Payload로 저장하고 내부 Timer Event가 비동기로 처리하도록 설계했습니다.
SpreadJS 파일 형식별로 올바른 로딩 API를 매칭하는 방법을 정리했습니다. 확장자와 데이터 형태를 구분해 import()와 fromJSON()을 적용하면 파싱 오류를 줄일 수 있었습니다.
LLM으로 대규모 기술 문서를 만들 때는 내용을 생성하는 것과 구조·서식을 통제하는 것을 분리해야 했습니다. BC 단위 분할, JSON 스키마, 정합성 검증으로 187쪽 초안을 43쪽 최종본으로 줄였습니다.

동적 CMS와 JSON 기반 관광 콘텐츠 관리 시스템에 LLM을 적용한 사례를 소개했습니다. 또한 할루시네이션과 보안, 비용을 고려한 AI-Native 개발의 주의점을 정리했습니다.

대규모 LLM 서비스에서 프롬프트보다 컨텍스트 설계가 더 중요하다는 점을 설명했습니다. 필요한 도구와 정보만 단계적으로 주입해 성능 저하와 환각을 줄인 방법을 공유했습니다.
엔카믿고 챗봇에 대화 맥락 기반 추천질문을 붙이며 SSE, 보증 분기, Structured Output 문제를 해결했습니다. 동적 프롬프팅과 명확한 JSON 지침으로 안정성을 높이고 답변량도 19% 증가했습니다.

MySQL의 JSON 데이터 타입 저장 구조와 성능 차이를 비교하는 글입니다. 5.7.8부터 지원된 JSON 타입의 특징과 일반 문자열 저장 방식의 차이를 다룹니다.
CQRS와 MongoDB 도입 후에도 엑셀 다운로드가 느린 원인을 Tomcat의 NDJSON flush 병목에서 찾았습니다. 1000개씩 버퍼링해 직접 write하도록 바꿔 성능 개선을 이끌었습니다.

오래된 문서와 반복 문의로 생기는 정책 파악 문제를 코드 기반 추출로 줄인 실험을 소개했습니다. Cursor, MCP, 벡터 DB를 활용해 최신 정책을 실시간으로 검증하고 응답하는 체계를 구축했습니다.
LLM 프롬프트와 JSON 후처리로 현실적인 금융 테스트 데이터를 생성했습니다. GitHub Actions 자동화로 QA와 개발에 지속 활용했습니다.
에이닷 뮤직 에이전트에 Multi Prompt Fine-tuning을 적용하며 겪은 시행착오와 개선 과정을 공유했습니다. gpt-4o-mini 전환으로 한글 깨짐과 품질 문제가 크게 완화된 사례였습니다.

Moshi의 기본 개념과 JSON 직렬화·역직렬화 흐름, 장단점을 정리했습니다. GSON과의 차이와 Kotlin CodeGen 기능도 함께 살펴보았습니다.

Apple Retail Store 전시용 iOS 데모 앱을 짧은 기간에 제작한 과정을 소개했습니다. Protocol 기반 mocking과 날짜 보정으로 오프라인 데모 경험을 구성했습니다.
안드로이드 데이터 변환에 사용한 Reflection의 스크롤 반응성 저하를 분석했습니다. APT 기반 Accessor 코드 생성으로 직접 호출 방식의 성능과 유지보수성을 확보했습니다.
