OpenAI Performance Factory로 ChatGPT 성능을 빠르게 유지하는 방법
How OpenAI’s Performance Factory keeps ChatGPT fast
OpenAI는 Codex 기반 Performance Factory로 ChatGPT 성능 회귀 대응을 자동화했습니다. 경고 조사부터 수정안 제시와 배포 후 복구 검증까지 워크플로로 연결합니다.
#Codex#ChatGPT#성능
300
성능 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 11개 · 많이 쓴 회사 마켓컬리·올리브영·카카오엔터테인먼트FE
20개 표시
How OpenAI’s Performance Factory keeps ChatGPT fast
OpenAI는 Codex 기반 Performance Factory로 ChatGPT 성능 회귀 대응을 자동화했습니다. 경고 조사부터 수정안 제시와 배포 후 복구 검증까지 워크플로로 연결합니다.
EC2와 JMeter로 출발지 IP를 고정한 분산 부하 테스트 환경을 설계했습니다. DLT와 비교해 원시 결과 분석과 서버별 모니터링 기준을 정리했습니다.

갤럭시 워치 홈 앱의 간헐적 Jank 원인을 찾는 AI 에이전트 개발 사례를 소개합니다. 자동 재현, Perfetto SQL 전처리, 소스코드 매칭으로 개선안 도출을 시도했습니다.
확산형 언어모델의 병렬 토큰 예측·반복 정제 방식과 블록 생성, 토큰 편집을 설명했습니다. 도입 시 TPS뿐 아니라 첫 응답 지연, 품질, 비용을 같은 조건에서 비교해야 합니다.
AI 에이전트로 늘어난 코드 변경에 맞춰 QA 외주화 구조를 Quality Platform 방식으로 전환했습니다. 개발자가 테스트·데이터·회귀 검증 도구로 품질과 성능을 직접 확인하도록 지원합니다.

TV 운영체제 패키지의 실행 로그로 커버리지를 측정하는 동적 분석 로직을 다룹니다. 두 대형 패키지에서 60시간 이상 걸리던 분석 병목의 최적화 사례를 소개합니다.
실서비스 운영에서의 백엔드 설계·개선 경험을 공유하는 밋업을 소개합니다. 아키텍처, 성능, 안정성과 인증·인가 등 현장 고민을 다룹니다.
Kubernetes GPU 노드를 Kata Containers 기반 VM으로 격리하는 발표를 소개합니다. GPU·NIC 할당과 VM 부팅·성능 최적화 방안을 다룹니다.
부하 테스트로 공통 조회 API의 병목과 N+1 호출을 확인하고 응답 구조를 개선했습니다. 요약 조회와 호출 제거로 병목의 상대적 위치가 낮아졌음을 확인했습니다.
최상위 제어 입력과 고비용 라벨 함수가 결합한 댓글 타이핑 지연을 측정해 원인을 분석했습니다. ref 기반 비제어 입력으로 전환해 리렌더와 라벨 호출을 제거하고 입력 성능을 개선했습니다.
미리캔버스 웹 에디터 팀이 편집 기능의 핵심 로직과 상태 구조를 설계하는 역할을 소개했습니다. MFA와 책임 분리 구조를 바탕으로 실시간 반응성·확장성을 확보하는 방식을 공유했습니다.
Java 25의 유연한 생성자 본문 규칙과 상속 초기화 순서의 주의점을 설명했습니다. 컴팩트 객체 헤더 기반의 메모리·GC 성능 진단 기준도 다뤘습니다.
Java 25의 생성자, 모듈 임포트, 기본형 패턴 매칭 문법을 소개합니다. Compact Object Headers 기반 HotSpot JVM 메모리 최적화도 살펴봅니다.
WebView별 영상 재생 제약에 스틸 이미지·스프라이트 대체 경로를 설계했습니다. 해상도와 인코딩은 실기기 검증으로 사용자 흐름 중심으로 최적화했습니다.
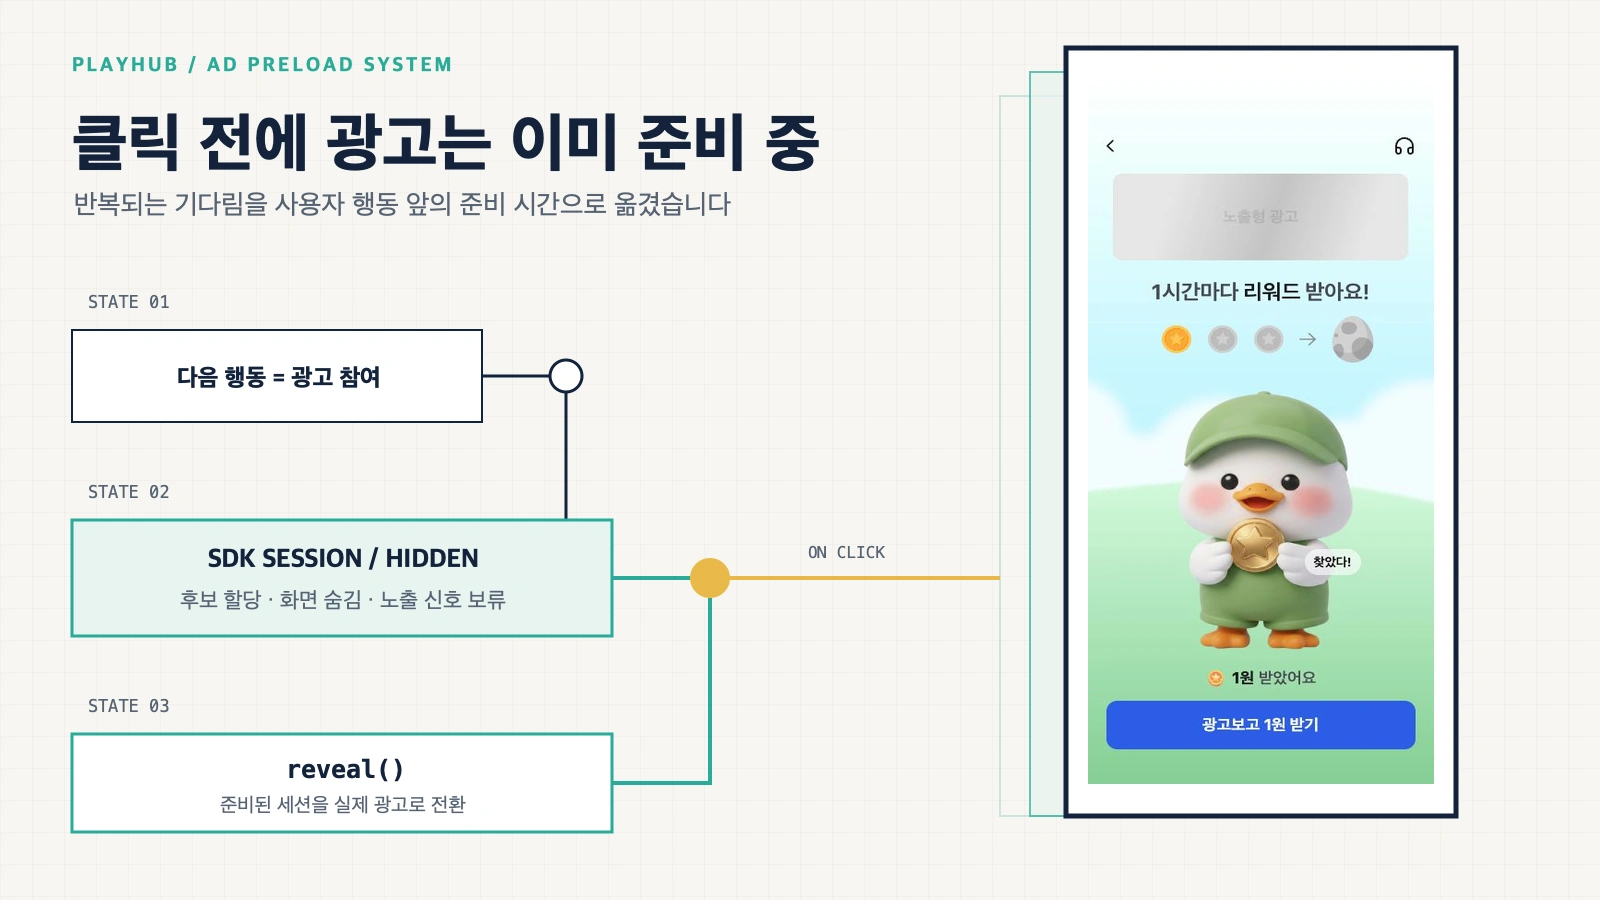
프리로드 API 없는 광고 SDK를 hidden 세션으로 선실행해 반복 대기 시간을 줄이는 구조를 설계했습니다. 우선순위 병합, 노출 신호 보류, 세션 정리와 폴백·관측 기준을 정리했습니다.
이미지 토큰 편차로 발생한 멀티모달 학습 GPU 부하 불균형을 분석했습니다. Pack 재배치와 통신 오버랩으로 품질 저하 없이 처리량을 13.3% 높였습니다.
공유 API 유무와 성능 이슈를 기준으로 MS 간 도메인 참조 방식을 구분했습니다. 기본은 ID 참조이며, 성능 문제가 확인될 때만 표시용 VO 동기화를 검토합니다.
React와 TypeScript 기반 SpreadJS Excel 상세 화면의 초기 로딩 지연을 단계별 측정으로 분석했습니다. 모든 시트에 바인딩하던 구조를 필요한 시트만 처리하도록 바꿔 로딩 시간을 약 40~50% 줄였습니다.
수만 건 Grid 화면에서 Cell 계산과 데이터 조합이 반복되며 Main Thread Blocking이 발생했습니다. 사전 집계와 계산 결과 재사용으로 반복 연산을 줄여 개선했습니다.
복잡한 배송 센터 결정 로직을 전략 패턴과 컴포지트로 분리해 확장성과 유지보수성을 높였습니다. DB 기반 룰 On/Off와 실행 순서 제어로 배포 없이 정책 변경과 성능 최적화도 가능하게 했습니다.