Closing the GitHub Actions Monitoring Gap: Observing ARC Runners with an Exporter
ARC Runner와 GitHub Actions Job의 연결 및 대기 상태를 관측하는 exporter를 구축했습니다. 웹훅·S3 상태 보존·알림으로 대기 지연과 Runner 병목을 탐지했습니다.
S3 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 7개 · 많이 쓴 회사 AWS·농심NDS·타다
20개 표시
ARC Runner와 GitHub Actions Job의 연결 및 대기 상태를 관측하는 exporter를 구축했습니다. 웹훅·S3 상태 보존·알림으로 대기 지연과 Runner 병목을 탐지했습니다.
AWS Secrets Manager와 S3로 AI Agent의 모델 인증과 보고서 보관을 분리해 설계했습니다. 권한 확인, 객체 버전 관리, 키 교체 검증을 통한 운영 보안 원칙을 설명합니다.
AWS Emulator로 계정과 자격 증명 없이 로컬·CI에서 AWS 통합 테스트를 실행하는 방법을 설명했습니다. 환경 변수 격리와 계정 확인 가드, 실제 AWS 검증을 함께 권고합니다.

게임듀오는 EC2 기반 ClickStack과 S3·SQS 버퍼로 관측 비용을 절반 이하로 줄였습니다. 로그 보존과 분산 트레이싱 범위를 확대하면서 유실 감시와 운영 자동화도 구축했습니다.
에이블리의 EKS 기반 Agent Sandbox로 프로젝트 작업환경을 중단·재개·만료하는 방식을 소개했습니다. Karpenter, Kyverno, S3를 연결해 유휴 자원 회수와 작업물 보존을 함께 운영했습니다.

Amazon Quick으로 Slack 메시지와 업무 기준 문서를 대조해 담당 이슈를 선별했습니다. Routine과 Agent로 매일 오전 Feed에 우선순위·근거·조치를 게시합니다.

Search OS는 AWS에서 상품 정보를 구조화 HTML로 변환해 SEO·GEO를 지원했습니다. CloudFront, EKS, S3 기반 분리 구조로 확장성과 운영 효율을 확보했습니다.

MSA 분산 로그 증가로 발생한 MongoDB 비용과 성능 문제를 데이터 티어링으로 해결했습니다. 최근 로그는 MongoDB에, 장기 로그는 S3에 자동 이관해 저장 비용과 메모리 부하를 줄였습니다.

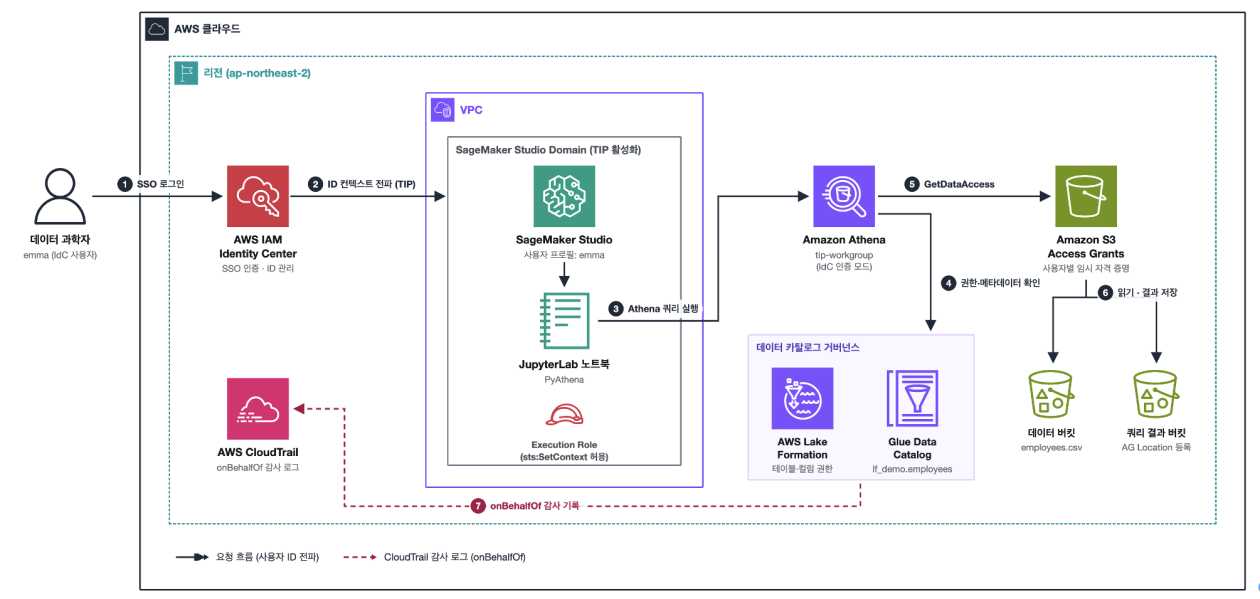
SageMaker Studio의 TIP로 사용자 ID를 Athena·S3·Lake Formation까지 전파하는 구성을 안내했습니다. S3 Access Grants와 CloudTrail을 통해 사용자별 권한 제어 및 감사 추적을 구현했습니다.

발전소 진단 지식을 Strands Agents와 Bedrock AgentCore로 연결하는 방법을 소개했습니다. 검색 계층과 응답 계층을 분리 평가해 근거 기반 진단 흐름을 설계했습니다.

Amazon EKS에서 vLLM으로 Gemma 4 31B 서빙의 콜드 스타트를 단계별로 최적화한 사례입니다. S3 직결 로더, 캐시 영속화, sleep mode로 시작 시간과 GPU 비용을 줄였습니다.
Amazon Quick을 활용해 CUDOS 기반 FinOps 분석과 리포팅을 자연어로 자동화하는 방법을 소개했습니다. 반복적인 비용 점검과 공유 업무를 줄이고 빠른 의사결정을 돕습니다.

라이브 스트리밍의 SCTE-35 광고 삽입을 AI 화면 인식과 서버리스 오케스트레이션으로 자동화하는 방법을 소개했습니다. 필러 화면 감지를 통해 광고 타이밍을 정밀하게 맞추고 운영 비용도 줄였습니다.

AWS 분산 학습용 컴퓨트를 초대규모로 확장하는 울트라클러스터와 울트라서버를 설명했습니다. 또한 ODCR과 Capacity Block으로 GPU 용량을 미리 확보하는 전략을 비교했습니다.

LGU+의 대규모 AWS 마이그레이션에서 Kiro와 Harness Engineering으로 전환 작업을 표준화했습니다. 설정 자동화와 지식 자산화를 통해 개발자 편차를 줄이고 재사용성을 높였습니다.

S3·CloudFront 기반 SPA에서 HTML, hashed asset, route fallback의 캐시 책임을 분리했습니다. 누락 asset은 404로 유지하고 chunk 오류에는 1회 새로고침 방어를 적용했습니다.

사내 AI 에이전트의 컨텍스트 비용과 안전성 문제를 줄이기 위해 v2 구조와 런타임 가드레일을 재설계했습니다. 파일, 채널, 스킬을 필요한 순간에만 제한적으로 읽도록 바꿨습니다.
Iceberg 운영에서 스냅샷 폭증과 Small File 문제를 어떻게 다뤘는지 정리했습니다. 작업 이력 관리와 메인터넌스 정책으로 비용과 성능을 개선한 사례입니다.
AWS 공간 데이터 관리로 건물 검사 결과를 공간 참조 데이터로 구조화하는 방법을 소개했습니다. 이미지와 메타데이터, 추론 결과를 연결해 장기 보존과 재분석 가능성을 높였습니다.

기존 상품명 중심 검색의 한계를 해결하기 위해 Amazon Bedrock Knowledge Bases 기반 자연어 검색 시스템을 구축했습니다. 하이브리드 검색과 메타데이터 필터링, 병렬 처리로 정확도와 응답 속도를 개선했습니다.