
Amazon EKS에서 vLLM으로 Gemma 4 서빙 최적화하기 [1부: 콜드 스타트 최적화]
Amazon EKS에서 vLLM으로 Gemma 4 31B 서빙의 콜드 스타트를 단계별로 최적화한 사례입니다. S3 직결 로더, 캐시 영속화, sleep mode로 시작 시간과 GPU 비용을 줄였습니다.
#Amazon EKS#vLLM
1200
Amazon EKS에서 vLLM으로 Gemma 4 31B 서빙의 콜드 스타트를 단계별로 최적화한 사례입니다. S3 직결 로더, 캐시 영속화, sleep mode로 시작 시간과 GPU 비용을 줄였습니다.

Amazon Quick을 활용해 CUDOS 기반 FinOps 분석과 리포팅을 자연어로 자동화하는 방법을 소개했습니다. 반복적인 비용 점검과 공유 업무를 줄이고 빠른 의사결정을 돕습니다.

라이브 스트리밍의 SCTE-35 광고 삽입을 AI 화면 인식과 서버리스 오케스트레이션으로 자동화하는 방법을 소개했습니다. 필러 화면 감지를 통해 광고 타이밍을 정밀하게 맞추고 운영 비용도 줄였습니다.

AWS 분산 학습용 컴퓨트를 초대규모로 확장하는 울트라클러스터와 울트라서버를 설명했습니다. 또한 ODCR과 Capacity Block으로 GPU 용량을 미리 확보하는 전략을 비교했습니다.

LGU+의 대규모 AWS 마이그레이션에서 Kiro와 Harness Engineering으로 전환 작업을 표준화했습니다. 설정 자동화와 지식 자산화를 통해 개발자 편차를 줄이고 재사용성을 높였습니다.
사내 AI 에이전트의 컨텍스트 비용과 안전성 문제를 줄이기 위해 v2 구조와 런타임 가드레일을 재설계했습니다. 파일, 채널, 스킬을 필요한 순간에만 제한적으로 읽도록 바꿨습니다.
쿠팡 파트너스
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
Iceberg 운영에서 스냅샷 폭증과 Small File 문제를 어떻게 다뤘는지 정리했습니다. 작업 이력 관리와 메인터넌스 정책으로 비용과 성능을 개선한 사례입니다.

AWS 공간 데이터 관리로 건물 검사 결과를 공간 참조 데이터로 구조화하는 방법을 소개했습니다. 이미지와 메타데이터, 추론 결과를 연결해 장기 보존과 재분석 가능성을 높였습니다.

기존 상품명 중심 검색의 한계를 해결하기 위해 Amazon Bedrock Knowledge Bases 기반 자연어 검색 시스템을 구축했습니다. 하이브리드 검색과 메타데이터 필터링, 병렬 처리로 정확도와 응답 속도를 개선했습니다.
AWS Athena로 ELB/ALB 액세스 로그를 분석하는 테이블 생성 방법을 정리했습니다. 로그 활성화와 S3 설정, 파티션 프로젝션 예시까지 함께 소개했습니다.

Deep Insight의 프로덕션 전환을 하네스 엔지니어링 관점에서 정리했습니다. 에이전트 추론, 코드 실행, 저장소, 네트워크를 분리해 안정성과 보안을 높였습니다.
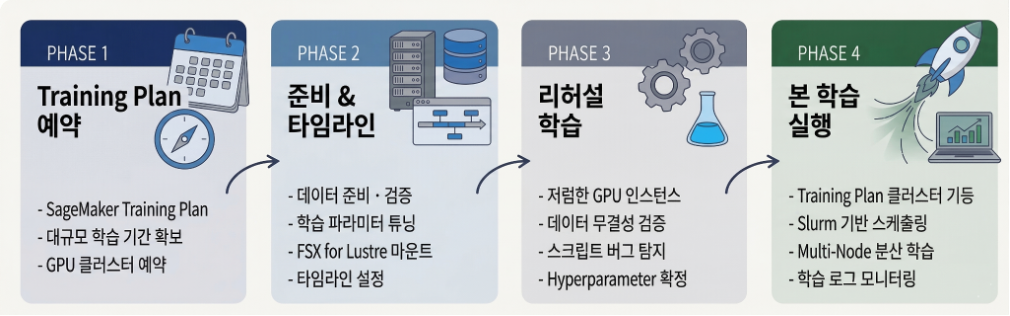
슈퍼브에이아이가 SageMaker HyperPod로 ZERO 모델의 대규모 분산 학습 효율을 높인 사례를 소개했습니다. 저가 리허설과 데이터 사전 로드로 비용과 학습 지연을 줄였습니다.

AWS 미디어 서비스와 TwelveLabs를 결합해 준실시간 비디오 분석 파이프라인을 구성하는 방법을 정리했습니다. 서버리스와 서버 기반, Kinesis Video Streams 활용 사례까지 함께 소개했습니다.

Strands Agents SDK로 TwelveLabs와 AWS 서비스를 결합한 에이전틱 비디오 엔진 구현 방식을 소개했습니다. 단일 에이전트와 멀티 에이전트 구조로 영상 검색, 요약, 자막 처리 흐름을 구성했습니다.