AI
Chip Placement with Deep Reinforcement Learning
두줄요약
Chip Placement를 Hard Macro 순차 배치 MDP로 정의한 Google의 강화학습 방식을 소개했습니다.\nGNN 상태 인코딩과 Wire Length·혼잡도 보상으로 PPA 제약을 근사했습니다.
구조와 흐름
- Netlist를 입력으로 Macro·Standard Cell·Wire를 Chip Canvas에 배치하고 Routing까지 물리 설계로 구체화하는 P&R 문제
- 강화학습 에이전트의 Hard Macro 순차 배치 후 Standard Cell Cluster의 Force-Directed 배치 방식
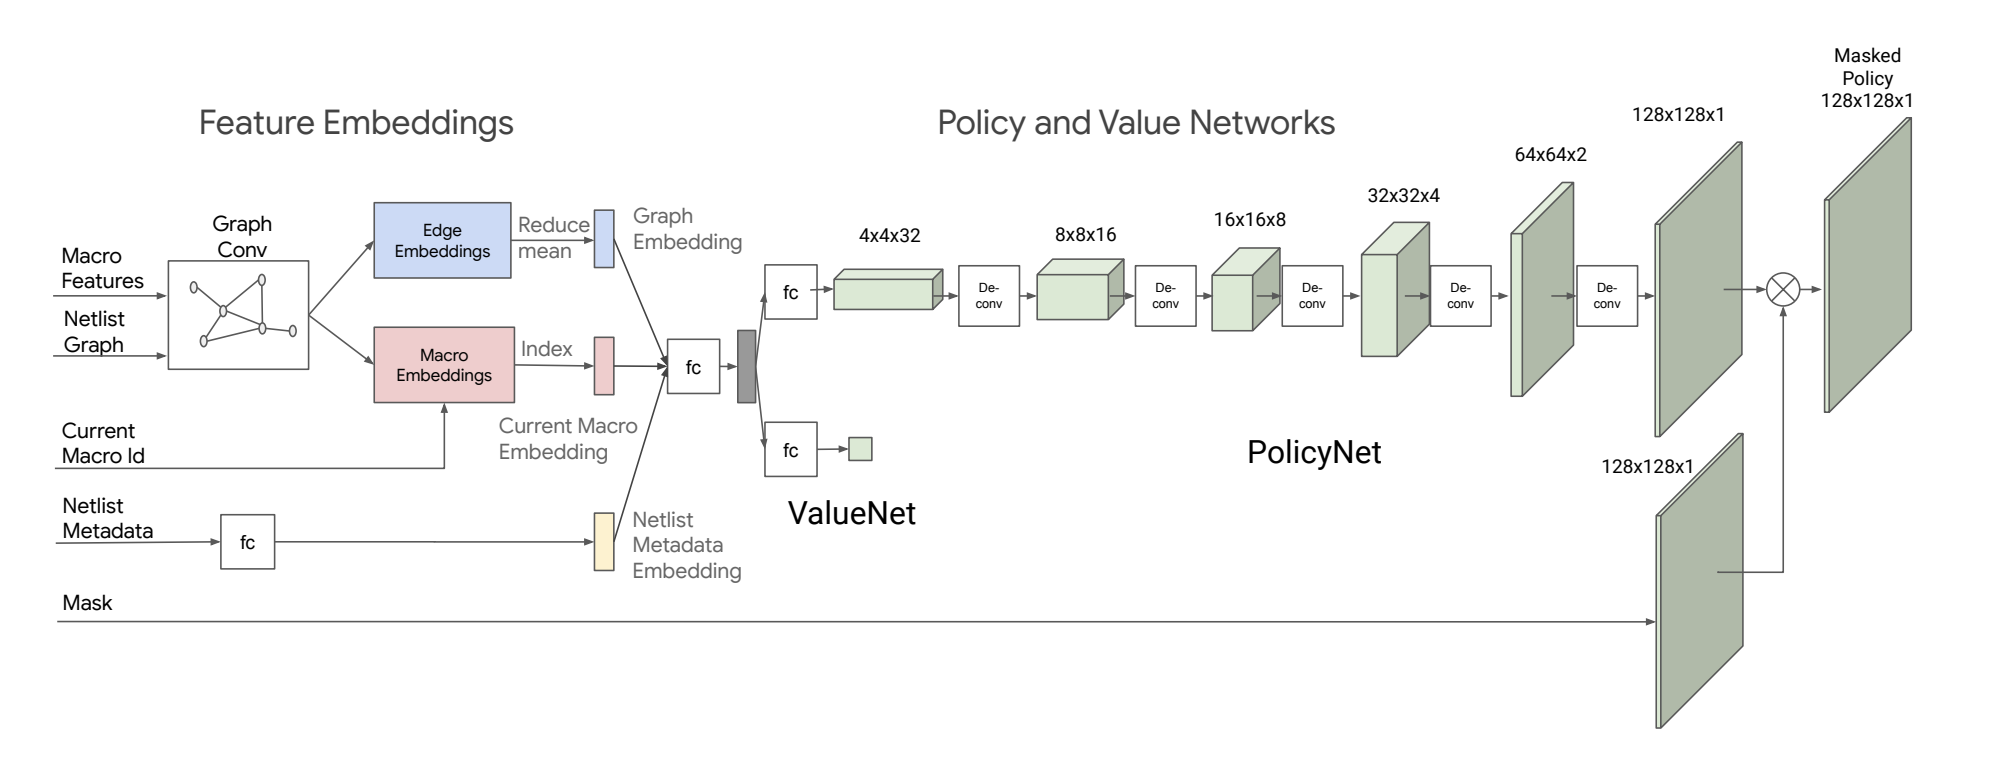
- Macro Feature, Netlist Graph, 현재 Macro ID, Netlist Metadata, 배치 가능 영역 Mask 기반 상태 표현과 정책·가치 네트워크 구성
선택 이유
- 수백만 Standard Cell 전체 대신 수백 개 Hard Macro만 강화학습 대상으로 제한해 탐색 복잡도 축소
- Netlist의 소자 특성과 연결 관계를 함께 다루기 위한 GCN 등 GNN 기반 Graph 데이터 처리
- 불가능한 위치를 Action Mask로 제외하는 제약 반영
트레이드오프
- 정확한 WNS·Dynamic Power 대신 빠르게 계산 가능한 Wire Length와 Routing Congestion을 보상으로 사용
- 물리적 Routing 결과와의 정확도 일부 희생으로 강화학습 Transition 생성 및 학습 비용 절감
- Placement Density 상한으로 비현실적 고밀도 배치를 탐색 공간에서 제외
주의할 점
- 짧은 물리적 Wire Length만으로는 영역별 Routing Resource 부족과 우회 경로를 반영하기 어려움
- 모든 Macro와 Standard Cell 배치 완료 시점에만 보상 계산, 중간 Step 보상은 0
- PPA는 Clock Frequency, Power, Area와 Routing 제약을 함께 고려하는 평가 기준