Control Room: 연구 인프라 전반의 모델 워크로드 추적 및 중단을 위한 중앙 시스템
Control Room: A central system to track and stop model workloads across our research infrastructure
OpenAI가 연구 모델 워크로드를 추적·중단하는 Control Room을 공개했습니다. 추론 계층의 권한 확인과 fail-closed 방식으로 안전 중단을 강화합니다.

강화학습 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
최근 30일 1개 · 많이 쓴 회사 마키나락스·데보션·버즈빌
20개 표시
Control Room: A central system to track and stop model workloads across our research infrastructure
OpenAI가 연구 모델 워크로드를 추적·중단하는 Control Room을 공개했습니다. 추론 계층의 권한 확인과 fail-closed 방식으로 안전 중단을 강화합니다.

Advancing computer use with Ironclad
OpenAI와 Ironclad는 복잡한 계약 업무에서 AI 에이전트를 훈련·평가하는 연구 협력을 공개했습니다. GPT‑6 Astra는 11개 연구 작업에서 GPT‑5.6 Sol보다 높은 점수와 낮은 추정 시간을 보였습니다.

AWS에서 VLA·강화학습용 Physical AI 학습, 시뮬레이션 검증, 엣지 배포 파이프라인을 구성했습니다. 학습 특성에 따라 SageMaker Pipelines·HyperPod를 선택하고 Greengrass로 모델을 배포합니다.

An Alien Mind
Jakub Pachocki는 급격히 고도화되는 AI의 정렬과 감시가 시급하다고 경고했습니다. 목표·가치 정렬의 한계와 일반화 검증의 중요성을 설명합니다.

GPT-Red: Unlocking Self-Improvement for Robustness
OpenAI가 자기 대결로 프롬프트 인젝션을 찾는 자동 레드팀 GPT‑Red를 공개했습니다. GPT‑5.6 Sol은 이를 학습에 활용해 직접 프롬프트 인젝션 실패를 크게 줄였습니다.

How Claude performs on robotics tasks
언어 모델의 로봇 제어 성능은 로봇 몸체보다 제어 인터페이스에 크게 좌우됨을 확인했습니다. 사전 학습 정책을 감독할 때 탐색·조작 성능이 높았지만 저수준 제어에는 한계가 남았습니다.

Teaching Claude why
Anthropic은 행동 시연보다 윤리적 이유와 원칙을 가르치는 정렬 학습의 효과를 공개했습니다. 평가와 먼 데이터도 에이전트 정렬 불일치를 줄이고 RL 과정에서 우위를 유지했습니다.
Where the goblins came from
OpenAI는 모델의 고블린 은유 증가가 Nerdy personality 보상에서 비롯됐다고 분석했습니다. 보상 신호와 SFT 데이터를 수정하고 Codex에 완화 지시를 추가했습니다.

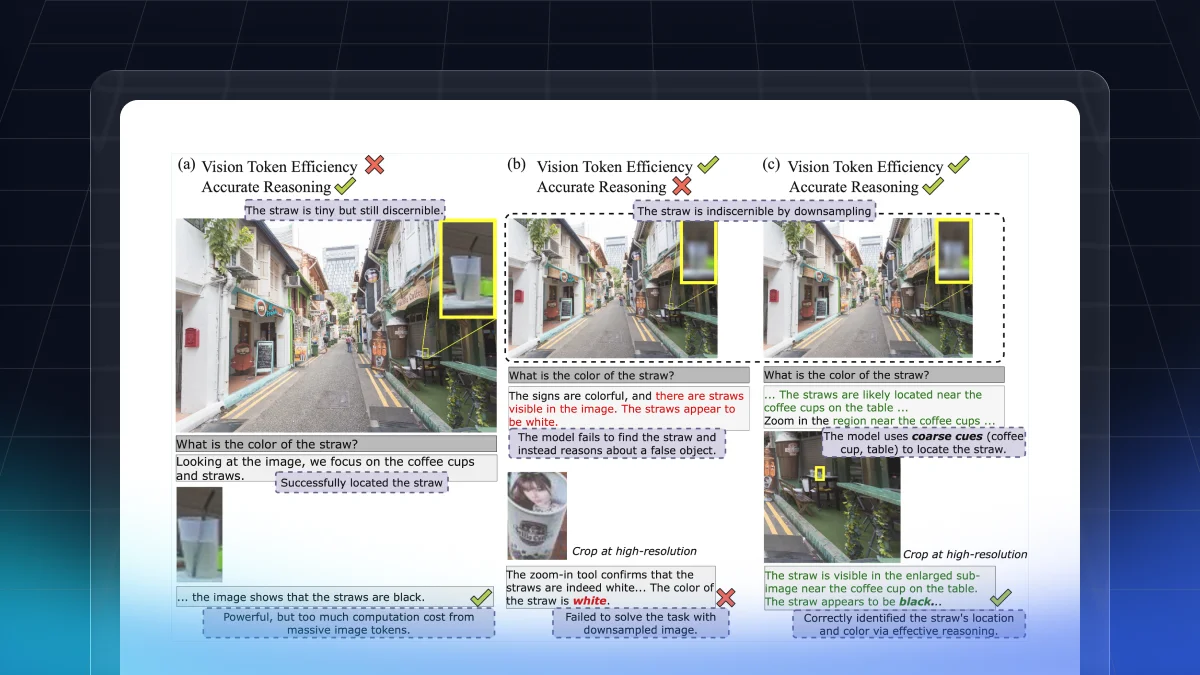
ERGO는 질의와 장면 문맥으로 중요한 영역을 먼저 찾는 2단계 비전-언어 추론을 제안했습니다. 강화학습 보상 설계로 비전 토큰을 줄이면서 정확도와 실제 지연 시간을 개선했습니다.

VAMS에 NVIDIA Isaac Lab을 통합해 로봇 자산에서 GPU 가속 RL 훈련과 평가를 직접 실행하는 방법을 소개했습니다. AWS Batch와 Step Functions로 인프라를 자동화하고 자산 계보와 결과 추적성을 강화했습니다.

ICAIF 2025 현장을 바탕으로 금융 AI의 최신 연구 흐름을 정리했습니다. 카카오뱅크의 쿼리 생성 파이프라인과 답변 가능성 평가, 그리고 신뢰성과 안전성의 중요성을 함께 소개했습니다.
NeurIPS 2025에서 데이터, 추론, 효율성, 벤치마크 한계 등 핵심 트렌드를 정리했습니다. XAI와 인과추론을 통해 AI를 더 신뢰하고 제대로 측정해야 한다는 메시지를 담았습니다.

if(kakao)25에서 카카오모빌리티가 자율주행 AI와 경로탐색, AI 업무 자동화 사례를 공유했습니다. 실서비스 적용과 기술 교류를 함께 강조한 행사 리뷰였습니다.
Reasoning 모델의 개념과 학습 방법, 성능 특징을 정리하고 AI 검색 고도화 방향을 소개했습니다. 질문 특성에 따라 Reasoning과 Non-Reasoning 모델을 선택해 정확도와 속도를 함께 높이는 방안을 다뤘습니다.

토스 광고 노출 과정과 추천 시스템의 전체 흐름을 ML 관점에서 정리했습니다. Targeting부터 Ranking까지 각 단계별 모델 활용 방식도 소개했습니다.
딥시크와 마누스의 등장으로 중국 오픈소스 LLM 생태계가 빠르게 다원화되고 있음을 정리했습니다. 딥시크는 고성능 개방형 LLM, 마누스는 자율 에이전트라는 서로 다른 방향을 보여주었습니다.
DeepSeek-R1의 구조와 학습 방식, GRPO와 지식 증류의 특징을 OpenAI o1과 비교해 정리했습니다. 비용 절감과 추론 성능 강점, 한국어 적용 시 주의점도 함께 살펴봤습니다.

퍼즐봇과 유저 행동 데이터를 바탕으로 퍼즐 스테이지의 품질을 수치화하는 지표를 설계했습니다. 폴리싱 효율을 높이기 위해 총 미션 수 구간별 기준을 달리 적용하고 사내 테스트로 검증했습니다.

성장과 호기심을 기준으로 강화학습의 탐색 개념을 커리어 선택에 적용했습니다. 좋은 동료, 회고, 목적 중심 커뮤니케이션에서 얻은 배움을 정리했습니다.

성장과 호기심을 기준으로 이직을 결정한 커리어 회고를 공유했습니다. 회고·비동기 소통·좋은 동료 문화가 팀 생산성과 몰입에 기여했음을 설명합니다.