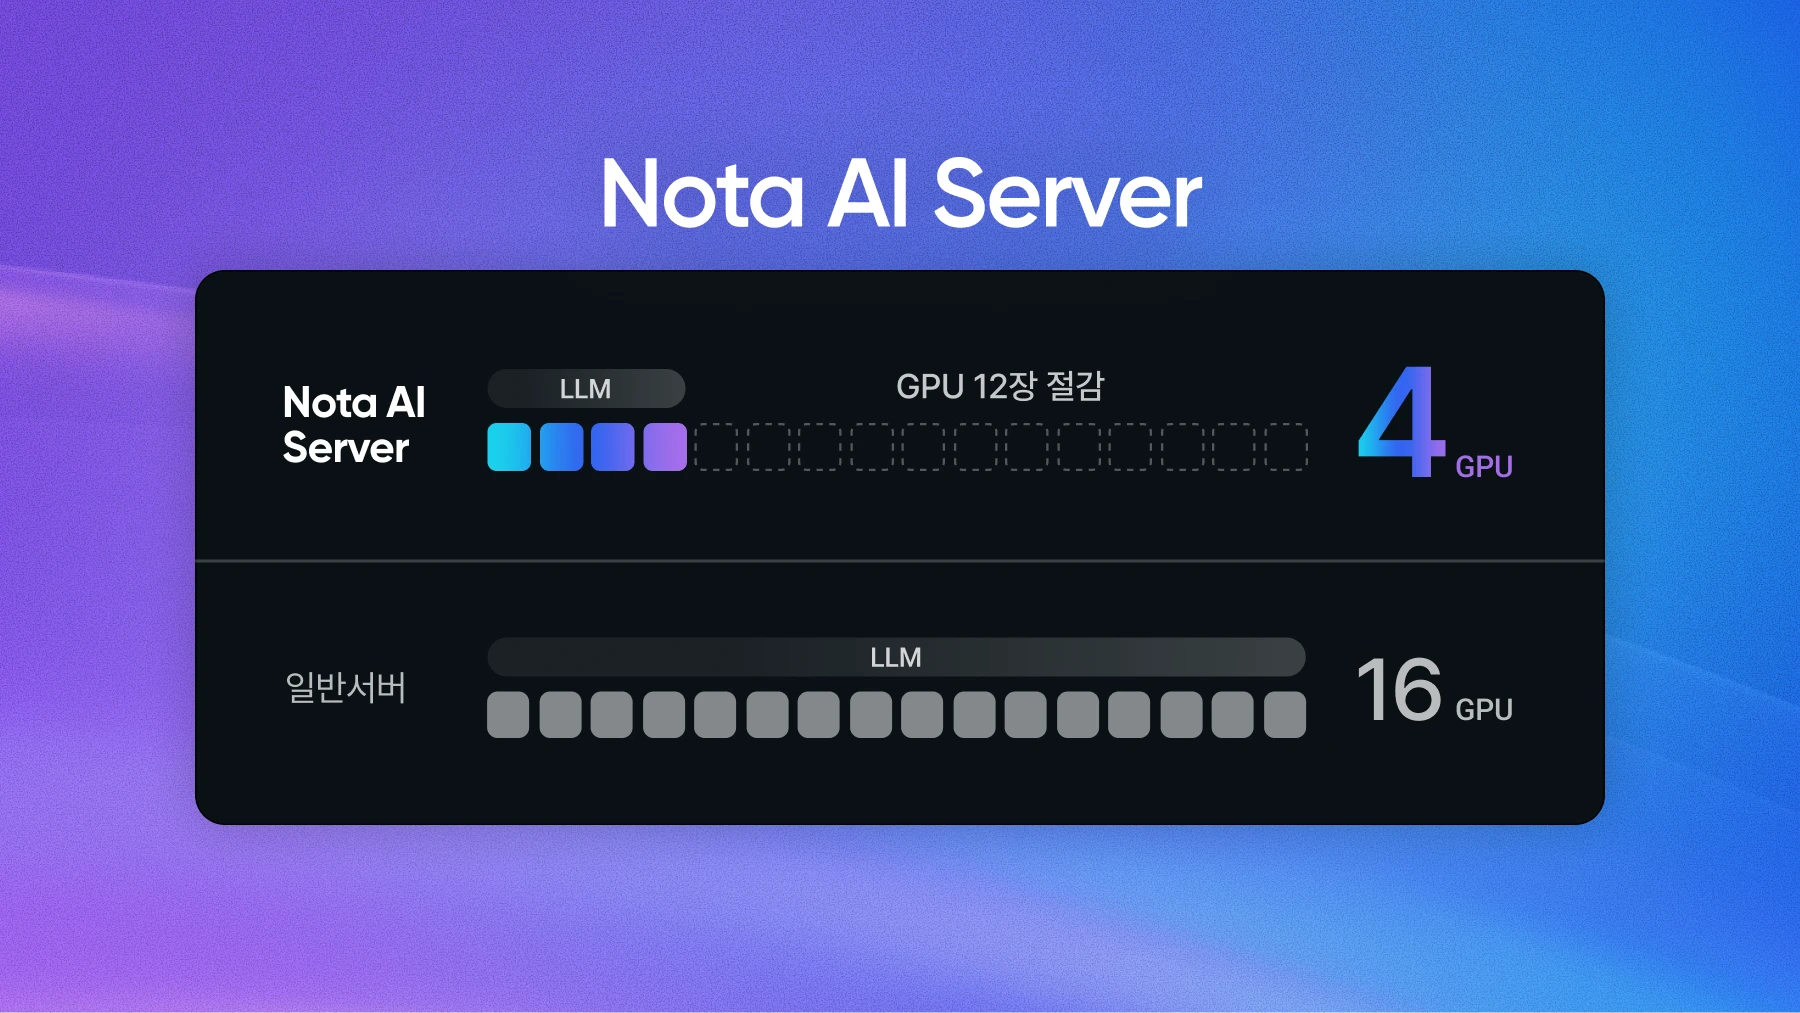
[Nota AI Server] 온프레미스 LLM 구축, GPU 사기 전에 확인해야 할 것
온프레미스 LLM의 GPU 수는 모델 크기뿐 아니라 양자화·가지치기와 KV 캐시 조건을 함께 고려해야 합니다. Nota AI Server는 최적화와 서빙 구성을 사전 검증해 GPU 절감 구성을 제공합니다.
#LLM#MoE#양자화
000
가지치기 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
4개 표시
온프레미스 LLM의 GPU 수는 모델 크기뿐 아니라 양자화·가지치기와 KV 캐시 조건을 함께 고려해야 합니다. Nota AI Server는 최적화와 서빙 구성을 사전 검증해 GPU 절감 구성을 제공합니다.
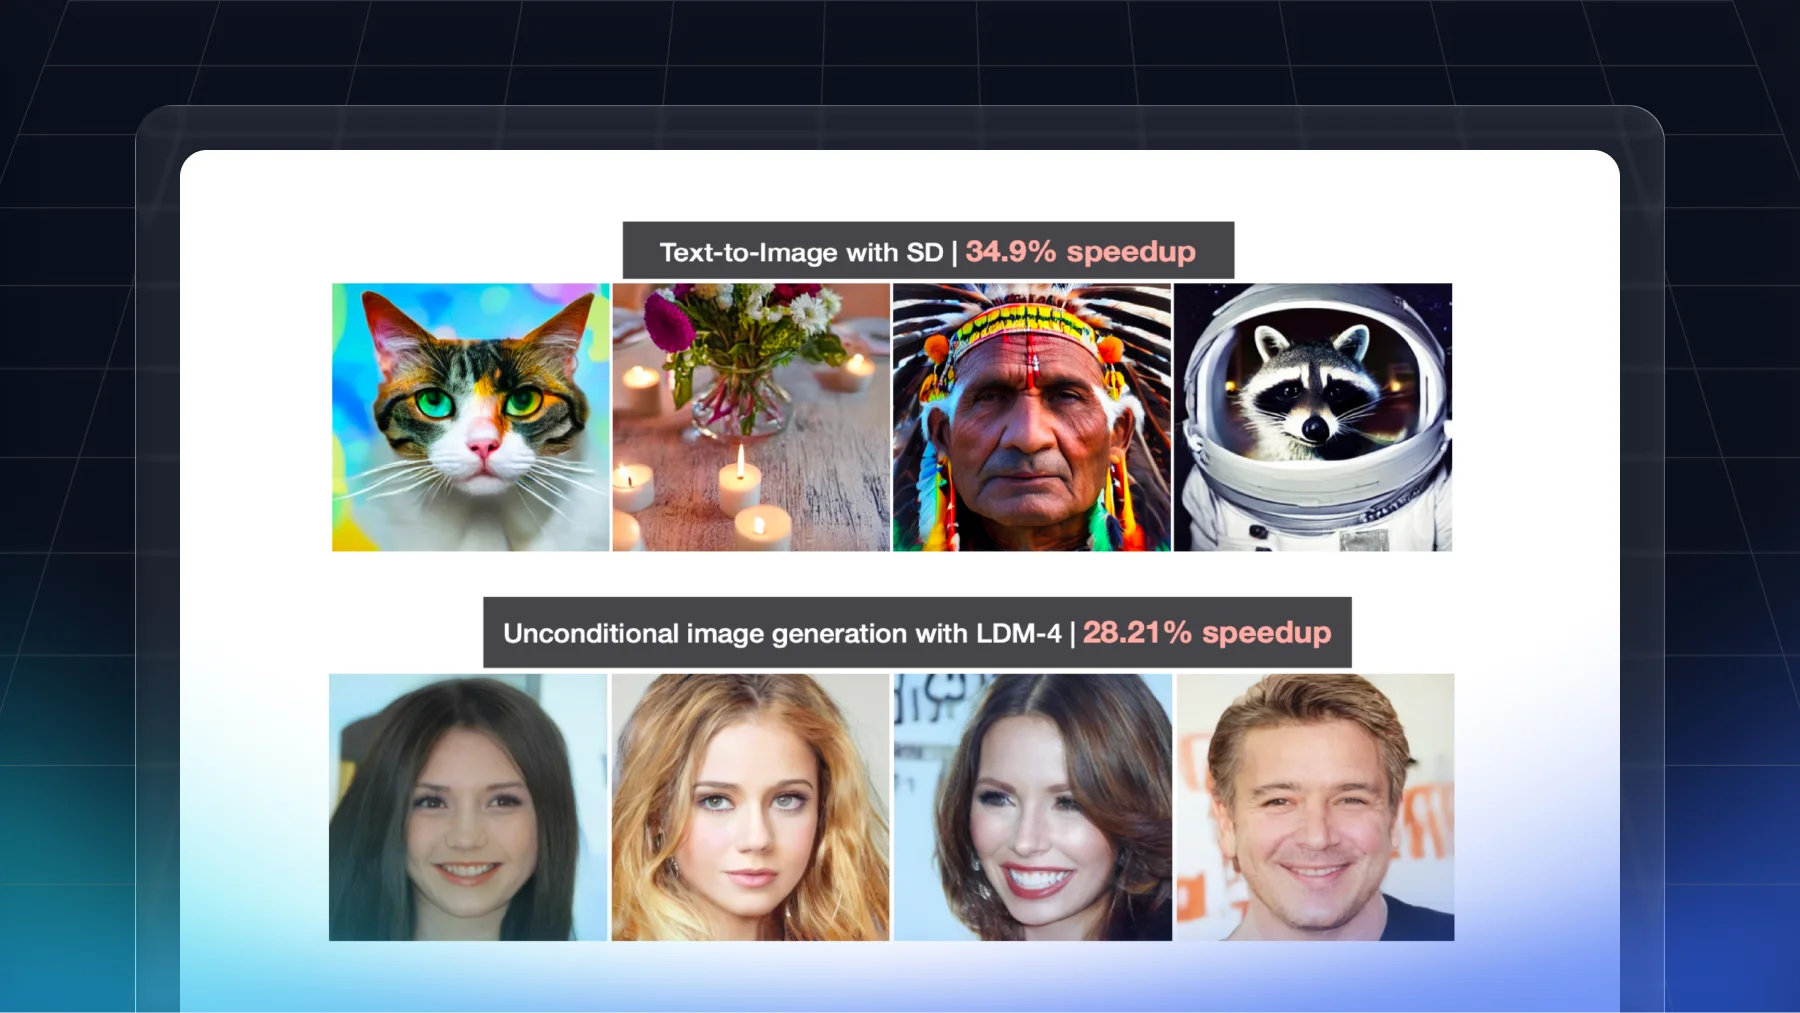
LD-Pruner는 잠재 표현 변화로 LDM Unet 연산자의 중요도를 평가해 가지치기합니다. 다양한 생성 작업에서 성능 저하를 줄이며 추론 속도와 메모리 효율을 개선했습니다.
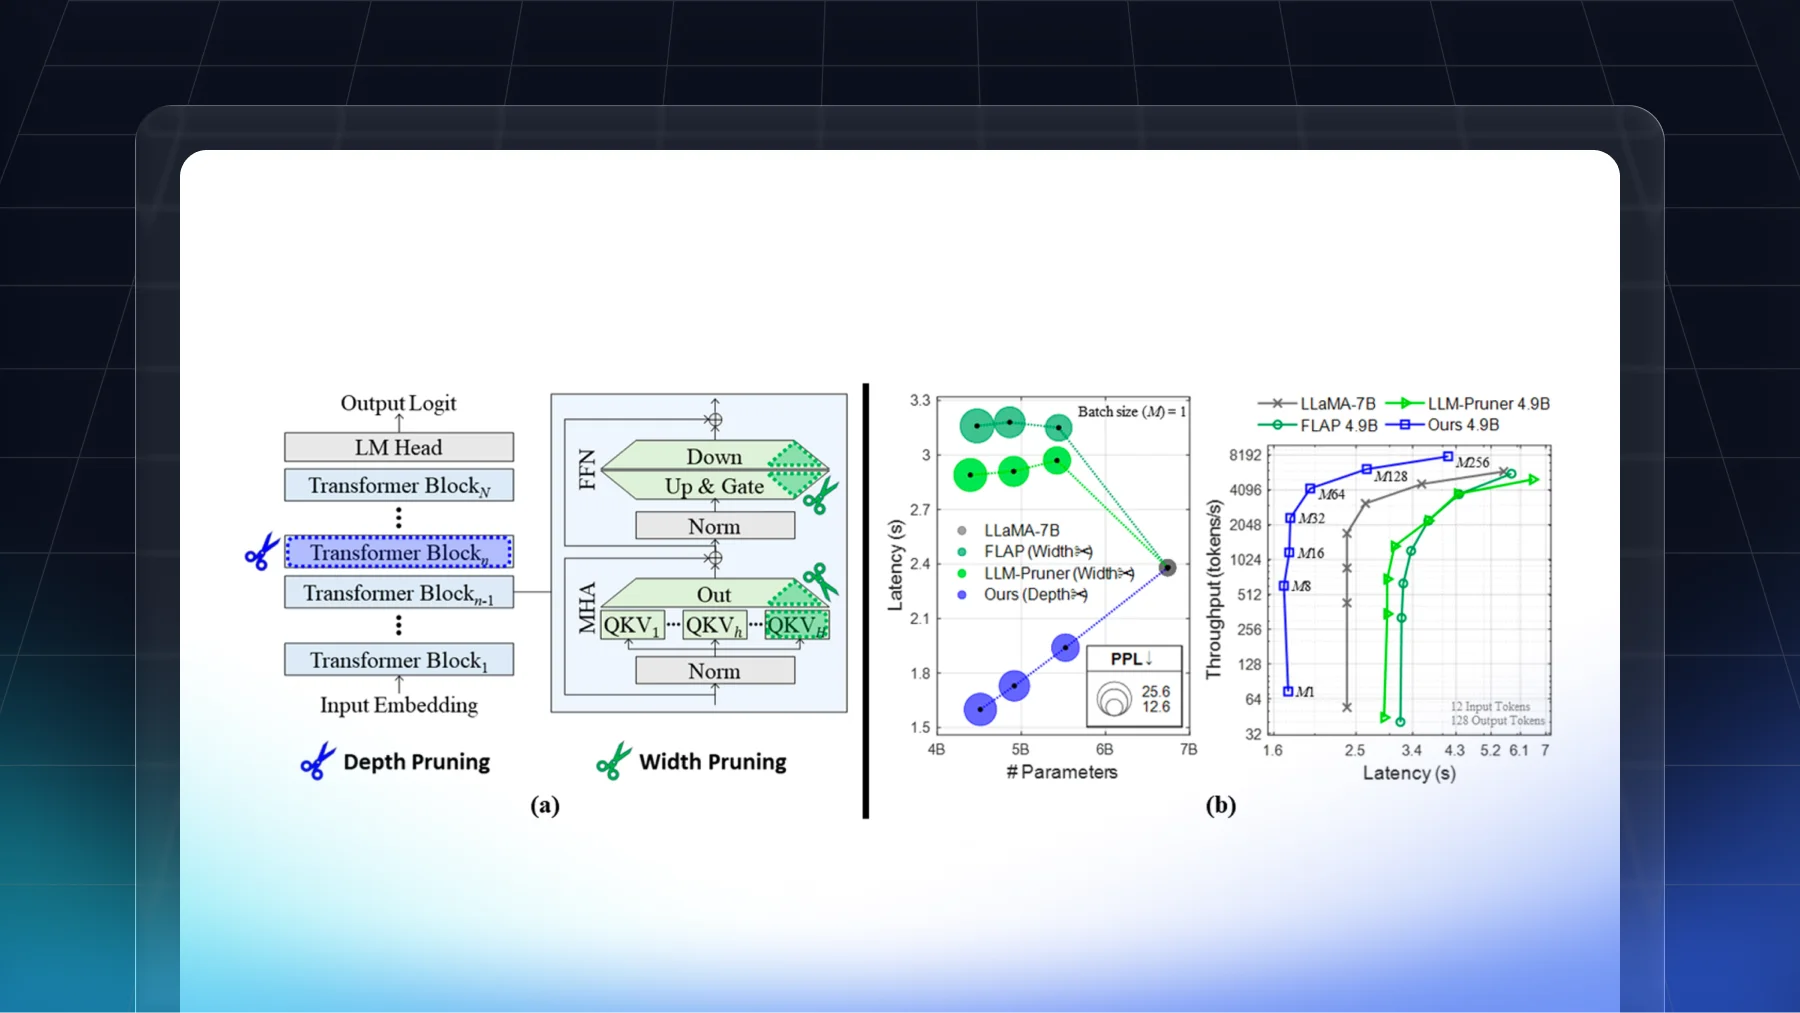
트랜스포머 블록을 제거하는 깊이 가지치기로 LLM 추론 비용과 지연을 줄였습니다.\n소규모 배치 환경에서 너비 가지치기보다 빠른 생성 속도와 경쟁력 있는 성능을 보였습니다.
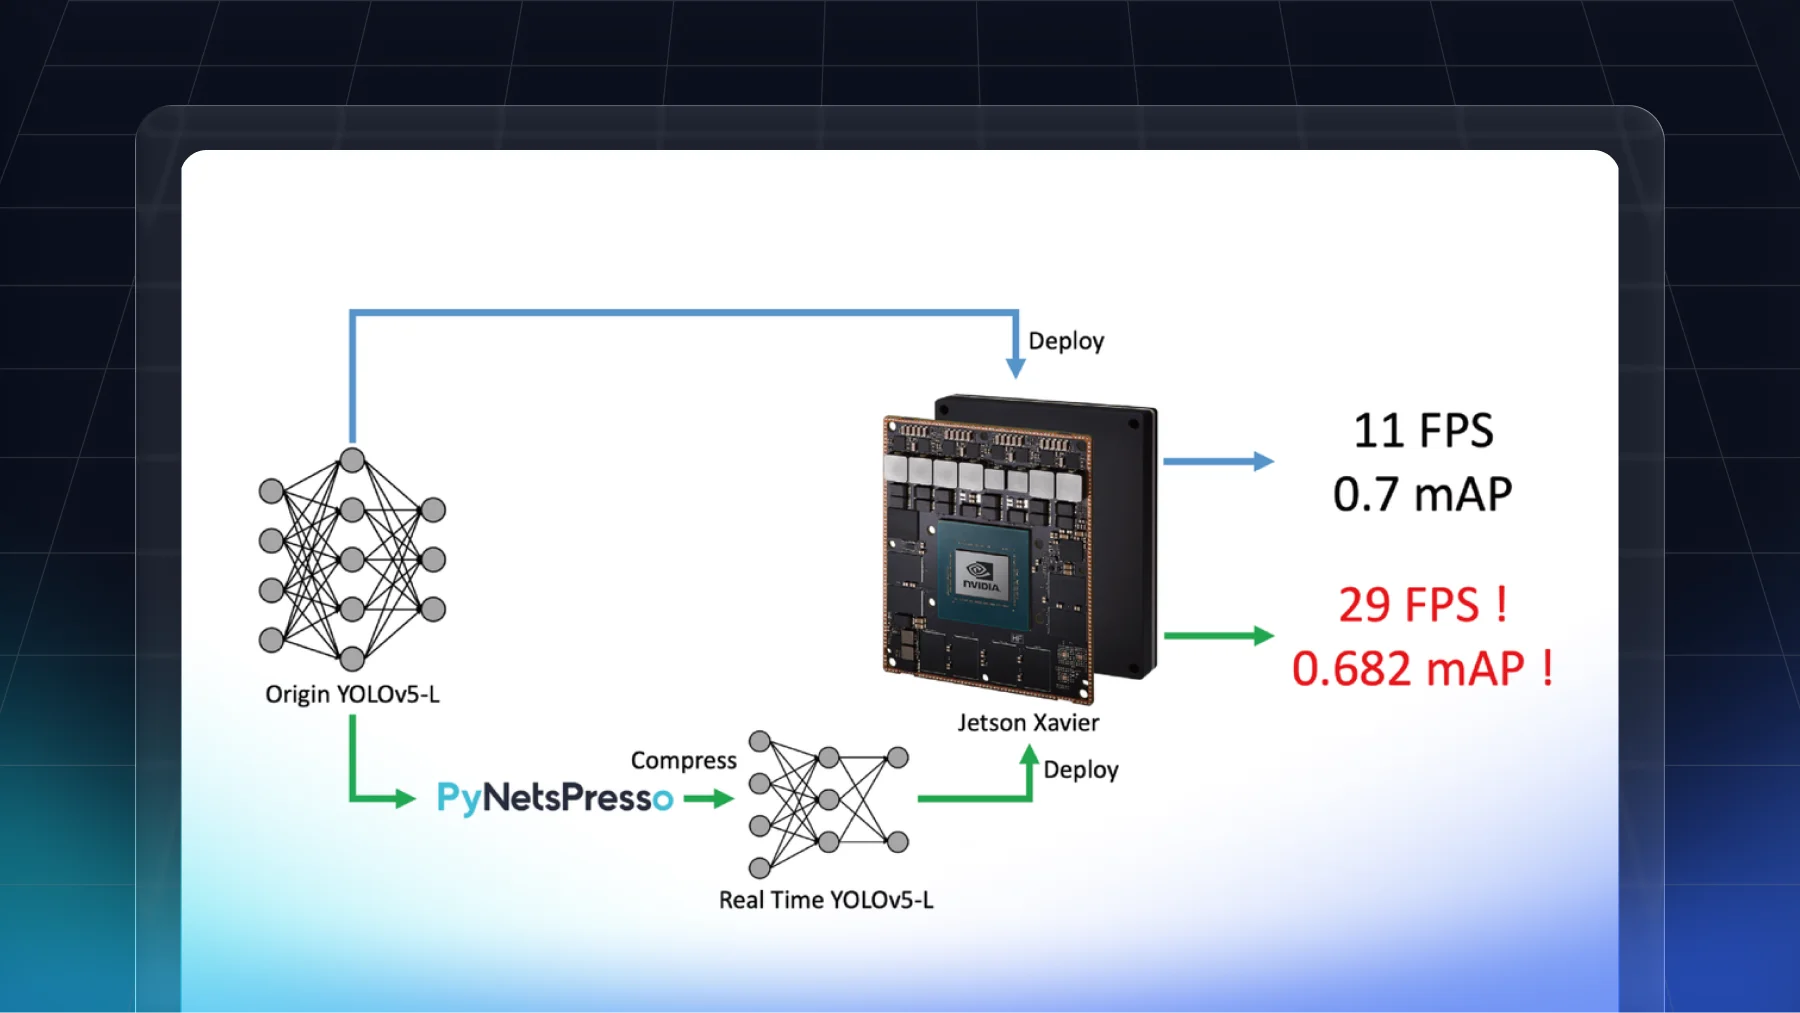
PyNetsPresso의 DAP로 YOLOv5-L에서 의존성을 고려한 파라미터 제거 방식을 소개했습니다. Jetson Xavier·TensorRT 환경에서 2.63배 성능 향상과 2% 수준의 성능 저하를 제시했습니다.