How we pipe data
여러 국가의 유저 행동 및 광고 데이터를 다양한 저장소에서 수집하는 환경을 소개했습니다. 분석과 활용을 위해 분산 데이터를 한곳에 모으는 필요성을 설명합니다.
#MySQL#DynamoDB#Redis
1700
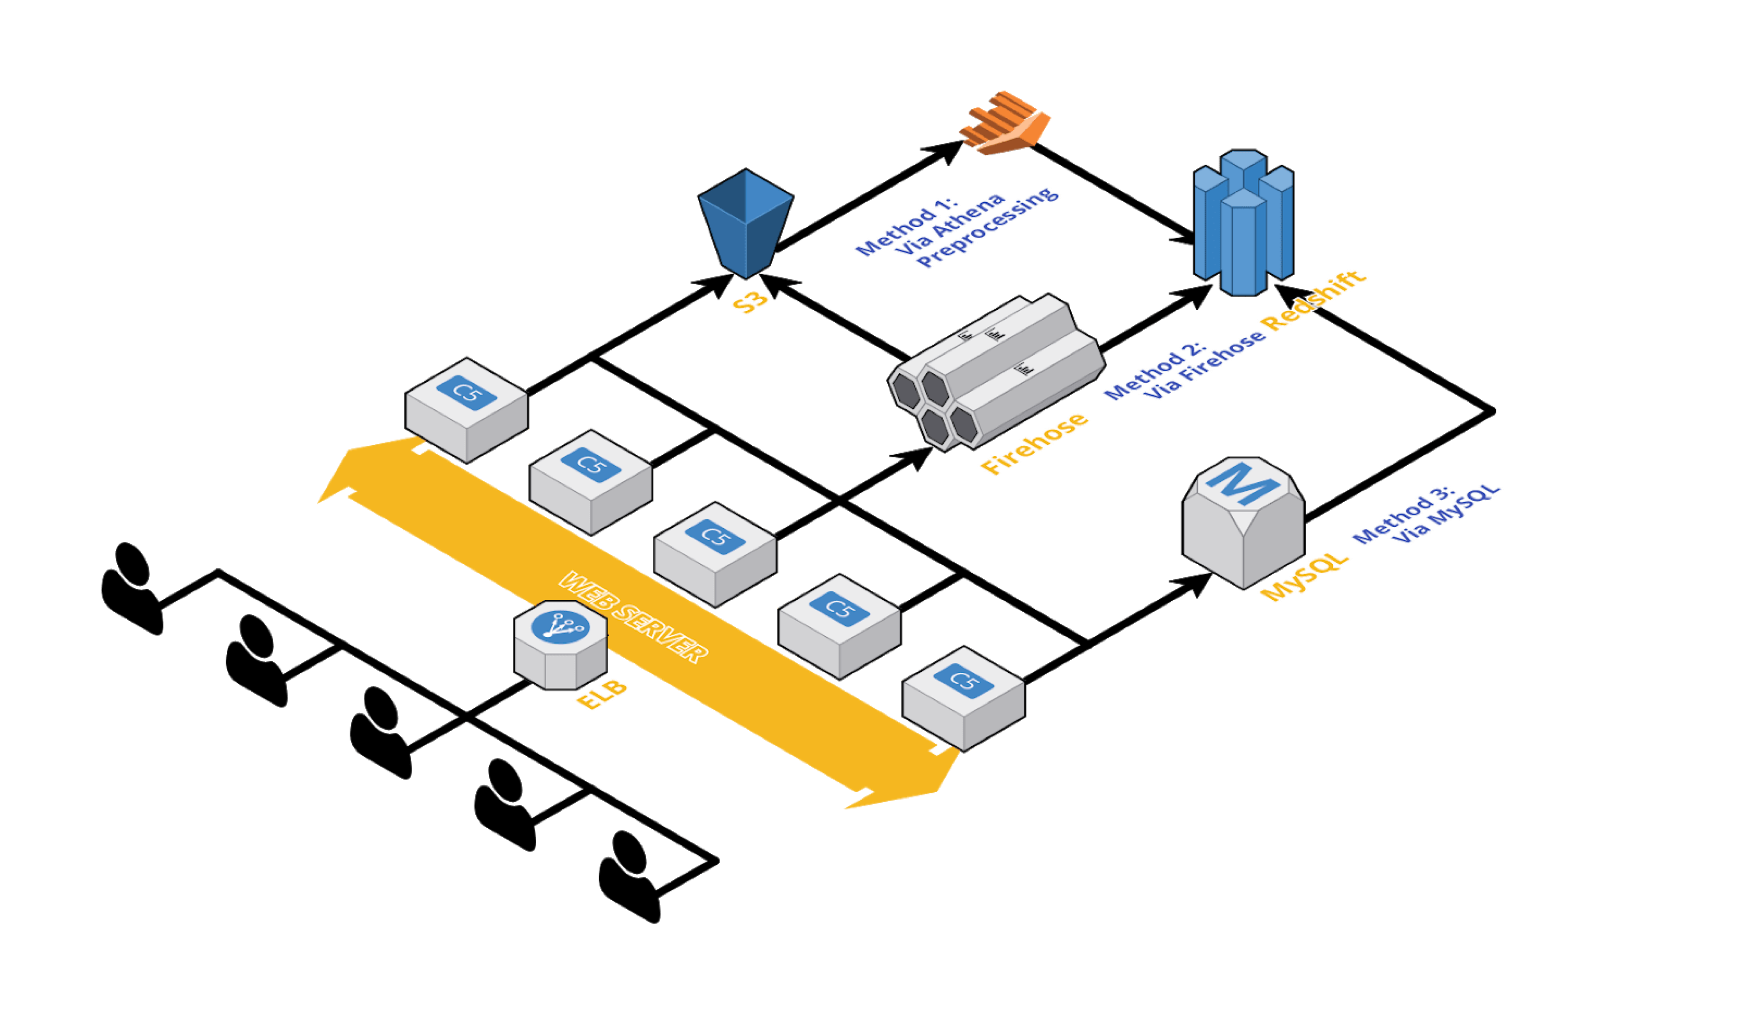
여러 국가의 유저 행동 및 광고 데이터를 다양한 저장소에서 수집하는 환경을 소개했습니다. 분석과 활용을 위해 분산 데이터를 한곳에 모으는 필요성을 설명합니다.
모바일 프로덕트 개선을 위한 A/B 테스트 실무 경험을 공유합니다. 샘플 사이즈 산정과 결과 해석에서 자주 생기는 질문을 다룹니다.
AWS Summit Seoul 2018의 행사 구성과 클라우드 기술 동향을 소개했습니다. 버즈빌의 다양한 AWS 인프라 활용 맥락도 함께 언급했습니다.
Django 기반 서비스에서 호출 비중이 약 80%인 Allocation API의 성능 병목을 확인했습니다. 해당 API만 Go로 분리 구현하는 방식의 서버 개발을 검토했습니다.
아마존 에코의 음성 인식으로 에어컨을 제어하는 방법을 다룹니다. 제어 회로 설계와 LIRC 사용을 쉽게 소개합니다.
모바일 광고 환경에서 LTV를 UA 채널 관리에 활용하는 사례를 소개합니다. NRU·DAU·리텐션과 함께 LTV 활용 맥락을 다룹니다.

신규 프로젝트에서 프론트엔드와 백엔드 분리 필요성을 검토했습니다. 백엔드에는 Django REST Framework, 프론트엔드에는 AngularJS를 적용했습니다.

스타트업에서 1년간 개발자로 일하며 겪은 업무와 성장 동기를 회고했습니다. 창업에 필요한 개발 경험을 폭넓게 배우려 했던 과정을 소개합니다.

허니스크린의 콘텐츠 추천 품질을 높이기 위한 유사 콘텐츠 분류 필요성을 다룹니다. Word2vec을 응용한 머신러닝 기반 콘텐츠 클러스터링 접근을 소개합니다.
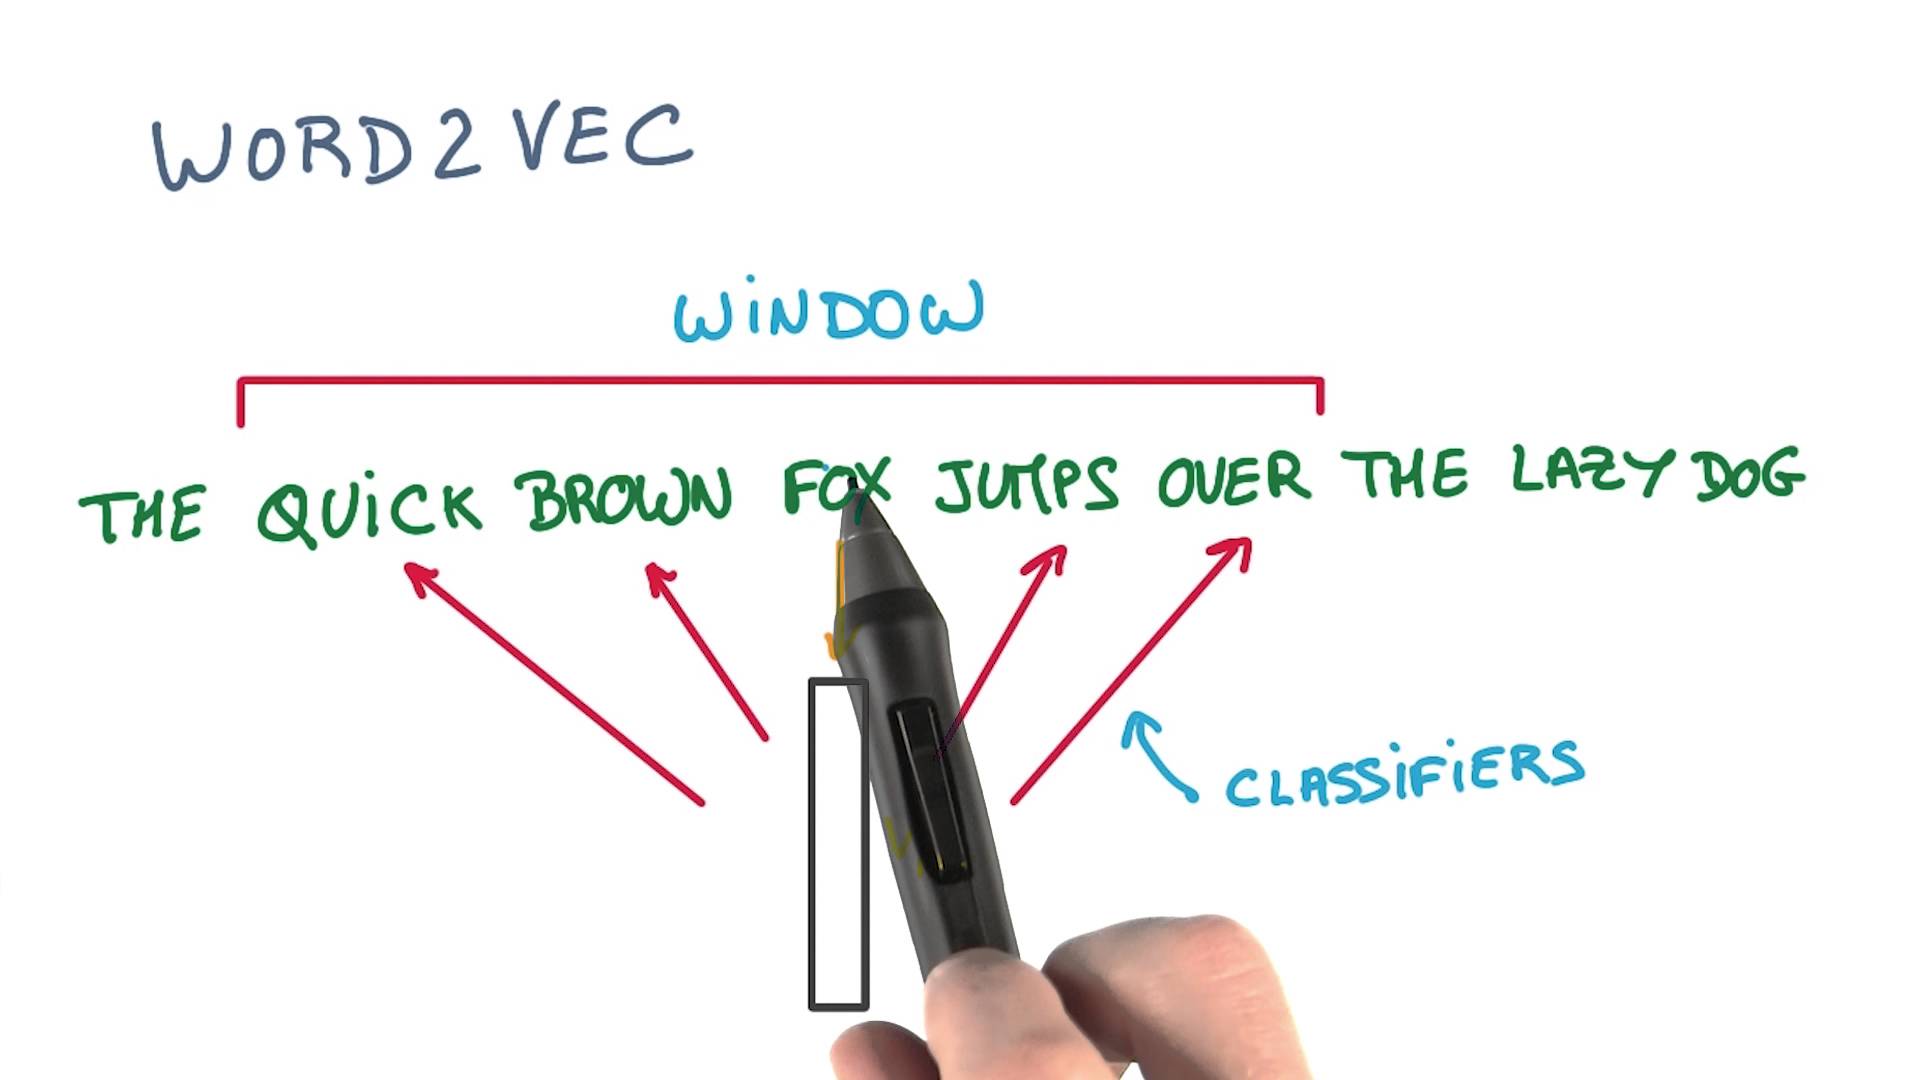
Honeyscreen 콘텐츠를 효율적으로 분류하기 위한 word2vec 기반 클러스터링을 소개했습니다. 단어 벡터 간 거리로 의미 유사도를 측정하는 방식을 설명합니다.
포인트 히스토리와 총 포인트 테이블을 통합해 일관성 있는 스키마를 구성했습니다. 포인트 타입별 분리와 단일 테이블 방식의 장단점을 검토했습니다.

허니스크린의 포인트 시스템은 기존 MySQL RDS로 운영했습니다. 서비스 성장에 따른 요청 급증으로 데이터베이스 부하가 커진 맥락을 다룹니다.
포인트 요청 증가로 MySQL RDS 부하가 커진 문제를 다뤘습니다. 확장성이 높은 AWS DynamoDB 기반 포인트 시스템 설계를 소개합니다.
광고·콘텐츠를 점수순으로만 할당할 때 반복 노출과 콜드 스타트 편향이 발생함을 설명했습니다. 점수 기반 순위와 무작위성을 결합한 선택 방식의 필요성을 제시합니다.
소수 개발 인력으로 여러 서비스를 운영하기 위해 AWS 관리형 서비스를 폭넓게 활용했습니다. 초기 인프라에서 자동 확장·서버리스·데이터 처리 서비스까지 사용 범위를 확장했습니다.

버즈빌의 첫 내부 해커톤과 연례 워크숍을 결합한 3일 행사를 소개했습니다. 전통적 형식에서 벗어난 팀 경험 중심의 프로그램을 시도했습니다.

Ghost Town으로 PhantomJS의 크래시와 메모리 문제를 견디는 이미지 렌더링 구조를 설계했습니다. 작업 큐, 워커 재할당, 프로세스 재시작으로 자동 확장과 복구를 지원합니다.