
AI
Content clustering using word2vec
두줄요약
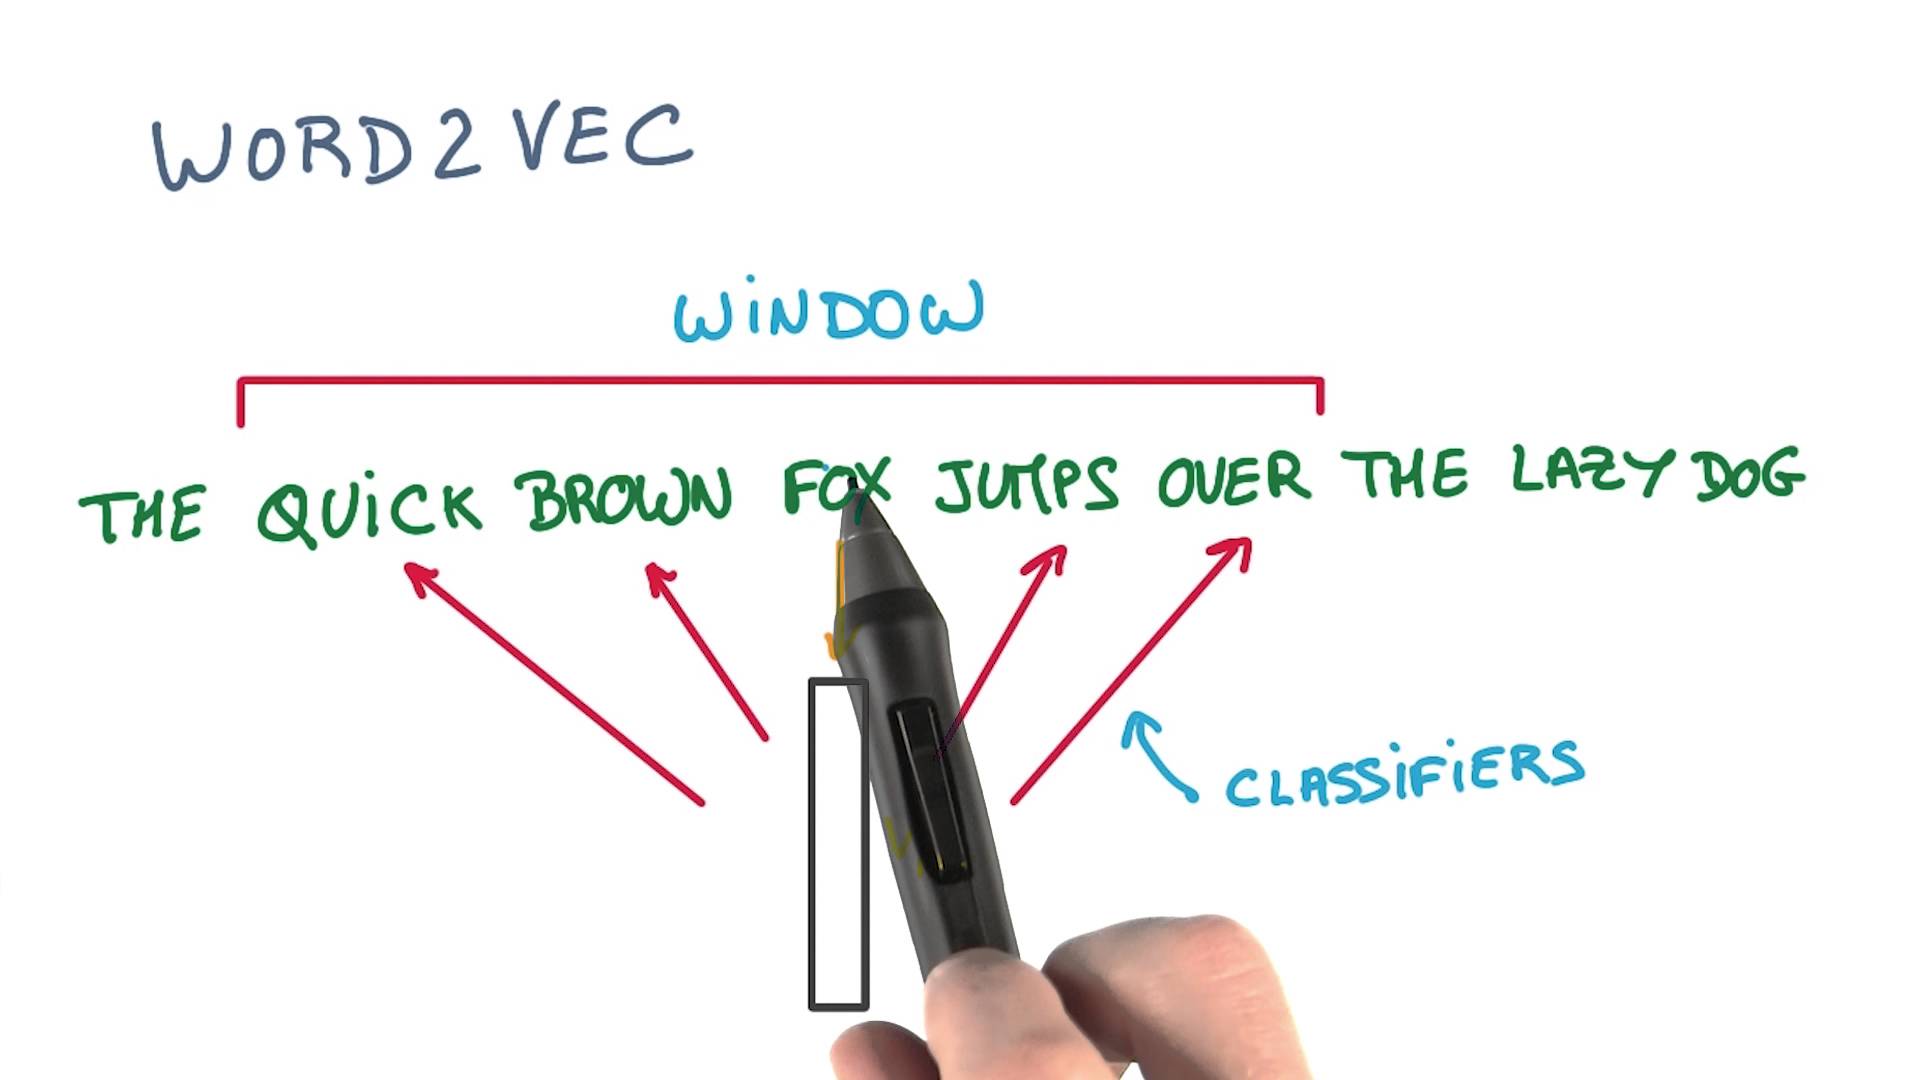
Honeyscreen 콘텐츠를 효율적으로 분류하기 위한 word2vec 기반 클러스터링을 소개했습니다. 단어 벡터 간 거리로 의미 유사도를 측정하는 방식을 설명합니다.
구조와 흐름
- 콘텐츠 본문·제목의 의미 기반 클러스터링과 협업 필터링 기반 클러스터링의 두 접근
- LDA, TF-IDF 등 자연어 처리 기법을 활용한 효율적 콘텐츠 분류 탐색
- 단어의 고차원 벡터 표현과 벡터 거리 기반 유사도 측정의 word2vec 방식
선택 이유
- 공동 출현 단어의 의미적 유사성 가정
- 정확도 향상 가능성과 표준 노트북 환경의 비교적 짧은 학습 시간
적용해볼 점
- 콘텐츠 카테고리 클러스터링에 word2vec 활용
- 사용자 대상 고품질·인기 콘텐츠 제공을 위한 분류 개선
