쉐도잉 검증 개선기
쉐도잉 검증을 공통 라이브러리와 Grafana 대시보드로 표준화했습니다. 실제 요청 재현, 일치율·오류·성능 비교를 한곳에서 확인합니다.
#쉐도잉#Prometheus#Grafana
4000
쉐도잉 검증 개선기

쉐도잉 검증을 공통 라이브러리와 Grafana 대시보드로 표준화했습니다. 실제 요청 재현, 일치율·오류·성능 비교를 한곳에서 확인합니다.
OpenTelemetry로 APM 데이터를 수집하고 ClickHouse에 저장해 스캐터 차트를 만드는 과정을 소개했습니다. 1편에서는 수집과 저장 단계에 초점을 맞췄습니다.
동시성 문제를 다루며 락과 데드락을 고민한 사례를 다뤘습니다. 데드락을 해결하려다 오히려 락을 줄이는 방향으로 접근을 바꿨습니다.
연차 날 슬랙 알림으로 NPE 이슈를 확인한 사례를 다뤘습니다. 단일 예외를 팀의 방어 체계로 확장한 개선 과정을 정리했습니다.
Kafka 컨슈머의 실패 메시지를 Retry/DLT로 어떻게 다룰지 설계와 운영 관점에서 정리한 글입니다. 운영 중 마주친 함정 3가지를 통해 재처리 경로와 실패 처리 전략을 살펴봅니다.
상세 화면 API에서 컬렉션 접근이 과도하게 발생하던 구조를 개선한 글입니다. 트랜잭션 스크립트에서 숙소 메타와 가격 계산 모듈로 분리한 과정을 다룹니다.
JVM 힙은 정상인데 컨테이너가 OOMKilled되는 원인을 네이티브 메모리에서 추적했습니다. 스트림 close 누락과 zlib Inflater 버퍼가 핵심이었고, 도구 조합으로 범인을 찾았습니다.
Docker 환경에서 힙은 멀쩡한데 메모리가 계속 늘어나는 원인을 추적한 글입니다. NMT로 JVM 내부를 확인했지만 실제 RSS와 차이가 있어 네이티브 메모리 문제를 의심했습니다.
Spring Data Redis Repository와 RedisTemplate의 실전 성능을 비교했습니다. 단순 캐시에는 RedisTemplate이 더 적합하며 CPU와 메모리 효율이 좋았습니다.
Aurora MySQL에서 HikariCP의 idle connection 검증 실패 원인을 추적해 비표준 timeout 동작을 확인했습니다. interactive_timeout 이 keepalive 보다 작으면 비활성 연결이 먼저 끊길 수 있음을 정리했습니다.
MSA 환경에서 화면 단위 복잡성을 줄이기 위해 BFF를 도입한 사례를 정리했습니다. 여러 도메인 API 조합과 분기 로직을 서버로 옮기고, 장애 전파와 메모리 과부하 대응도 다뤘습니다.
Elasticsearch 좌표 검색에 거리 기반 가중치를 더해 랭킹을 최적화하는 방법을 소개했습니다. 구간별 weight와 decay 함수를 비교하며 자연스러운 노출을 위한 주의점을 설명했습니다.
지도보기 API의 병목이던 표준 상품 API 호출을 동적 window 분할과 Coroutine Async로 병렬화했습니다. 그 결과 응답 시간을 8~10초에서 약 2초로 줄이고 TPS도 크게 개선했습니다.
숙박 전시 도메인의 복잡한 노출 로직을 Kotlin DSL로 표현한 적용 사례를 소개했습니다. 가독성은 좋아졌지만 내부 구현 복잡도와 팀의 러닝 커브가 커지는 트레이드오프도 있었습니다.
도메인별로 분산 운영되던 8개 Kafka 클러스터를 공통 Kafka로 통합하는 전환 과정을 정리했습니다. MirrorMaker2 기반 점진 전환으로 서비스 영향 없이 데이터 일관성과 Offset을 유지했습니다.
PLP 최저가 계산에서 모든 객실을 끝까지 계산하던 방식을 가지치기로 줄인 사례를 소개했습니다. 계산량은 크게 줄었지만 실제 성능 개선은 DB 조회 비용 때문에 제한적이었습니다.
여기어때는 고객 상담 시스템에 SendBird SDK와 Salesforce를 연동했습니다. 상담 상태 제어와 UI 분기를 위해 채널 metaData를 적극 활용했습니다.
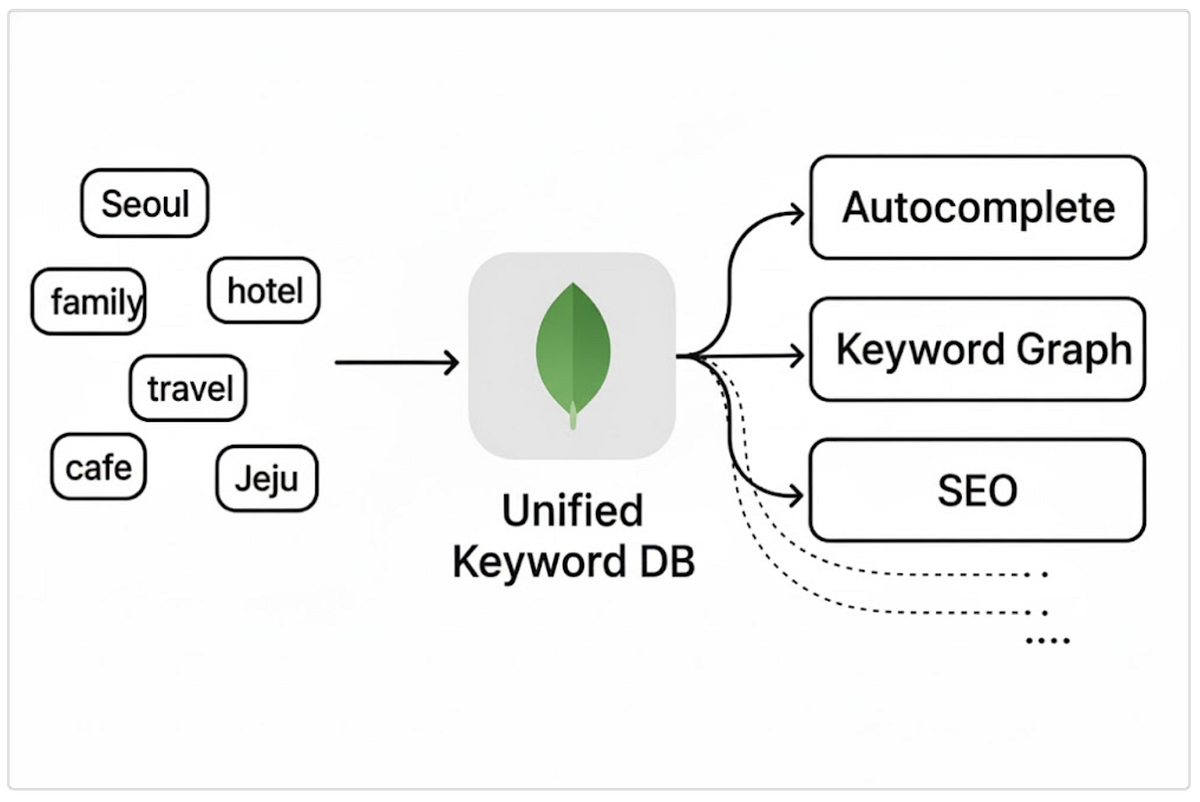
여기어때가 분산된 검색 키워드 데이터를 MongoDB 기반 단일 허브로 통합한 사례를 소개했습니다. 데이터 관리 일관성과 자동완성 구조 단순화를 통해 확장성을 높였습니다.