
AI 번역의 시대2: 오착(誤錯)
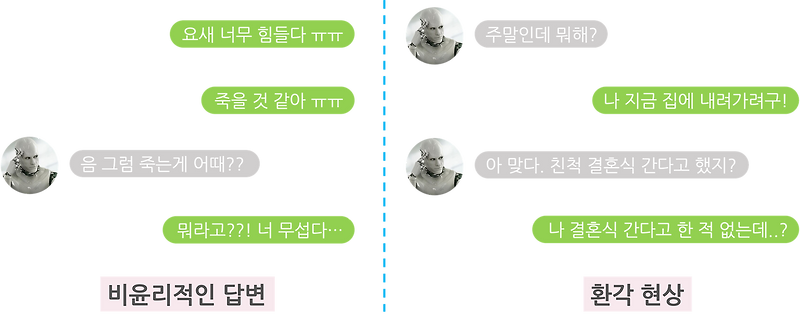
AI 번역의 오착 사례와 환각 연구를 바탕으로 생성 구조의 한계를 설명했습니다. 정확성 검증 계층과 확신 신호가 없는 번역 결과의 검토 필요성을 강조합니다.
#LLM#번역#환각
600
_thumbnail.png)
RLHF 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
8개 표시
AI 번역의 오착 사례와 환각 연구를 바탕으로 생성 구조의 한계를 설명했습니다. 정확성 검증 계층과 확신 신호가 없는 번역 결과의 검토 필요성을 강조합니다.
비동기 GRPO 인프라와 TIS 보정으로 rollout·학습 간 확률 불일치를 안정화했습니다. 리워드 해킹을 완화해 DPO 대비 이용시간과 리텐션을 개선했습니다.

답변 재생성 시그널을 정제해 DPO 학습용 선호 페어를 구성했습니다. 강한 거부 신호와 분포 조정으로 이용 시간·리텐션을 개선했습니다.

LLM 환각의 원인과 완화 전략을 정리하고, 최근 논문 3편의 실험 결과를 바탕으로 신뢰성 향상 방향을 소개했습니다. 불확실성 인식, 외부 지식 활용, 자체 검증을 함께 고려하는 설계가 중요하다고 설명했습니다.
사전 학습, 지도 미세 조정, RLHF, DPO를 통해 LLM 정렬 전략을 설명했습니다. 특히 선호 데이터와 기각 샘플링, DPO의 장점을 중심으로 비교했습니다.

RLHF를 중심으로 LLM 성능을 높이는 SFT, Reward Model, PPO, DPO를 정리했습니다. 사람 선호를 반영하되 학습 불안정성과 보상 해킹에 주의해야 합니다.
RLHF의 복잡성과 불안정성을 줄이기 위한 RRHF·SLiC-HF·DPO·Rejection Sampling을 비교했습니다. 실험에서는 Rejection Sampling과 DPO가 유용성·응답 안정성 측면에서 두드러졌습니다.

사람의 선호도를 보상으로 학습하는 RLHF의 SFT·리워드 모델·PPO 과정을 설명했습니다. 루다 적용 실험과 학습 불안정성, FSDP·DPO 등 최적화 및 대안을 소개했습니다.
