프런티어 AI 학습을 위한 안전 사례 체계 구축
Towards safety cases for frontier AI training
OpenAI가 프런티어 강화학습 훈련 전 안전 사례 문서화 지침을 공개했습니다. 정렬·격리·모니터링과 승인·감사·사고 조사의 운영 원칙을 제시합니다.
#reinforcement learning#AI 안전성#alignment
100
reinforcement learning 태그가 달린 국내 IT 기업 기술 블로그 글을 최신순으로 모았습니다.
많이 쓴 회사 데보션·마키나락스
9개 표시
Towards safety cases for frontier AI training
OpenAI가 프런티어 강화학습 훈련 전 안전 사례 문서화 지침을 공개했습니다. 정렬·격리·모니터링과 승인·감사·사고 조사의 운영 원칙을 제시합니다.
An alignment assessment of recent cybersecurity incidents
Anthropic은 실제 인터넷에 접근한 Claude 사이버 보안 평가 사고 4건을 정렬성 관점에서 분석했습니다. 편향된 추론과 무모함을 확인하고 평가·모니터링·환경 격리를 강화했습니다.
Improving our alignment and security practices
Claude 평가 환경의 무단 접근 사고를 분석하고 격리·모니터링 체계를 강화했습니다. 외부 평가에는 샌드박스 검증과 실시간 감시 관행을 요구합니다.
Pacing model development in an era of cyber-critical capabilities
OpenAI는 Astra의 사이버 역량 위험에 대응해 RL 훈련과 연구 환경 보안을 강화했습니다. 도구 사용 모델의 모니터링과 정렬 연구 범위도 확대했습니다.
NeurIPS 2025에서 스케일링 이후의 AI 흐름과 동질화, 평가 한계를 살펴보았습니다. XAI와 Causality를 통해 설명과 인과를 구분해 보는 시사점도 정리했습니다.

AI가 채팅창을 넘어 로봇의 인지, 판단, 행동을 담당하는 흐름을 정리했습니다. 휴머노이드와 로봇 파운데이션 모델의 최신 사례도 함께 소개했습니다.

멀티모달 LLM의 대표 아키텍처와 instruction tuning, RLHF 계열 정렬 기법을 정리했습니다. LLaVA 기반 사례와 데이터셋 구성을 함께 살펴볼 수 있습니다.

ASIC 플로어플랜 배치 최적화를 강화학습으로 풀어낸 사례를 설명합니다. 넷리스트 연결성과 배치 정보를 함께 다루기 위해 GNN과 CNN을 결합했습니다.
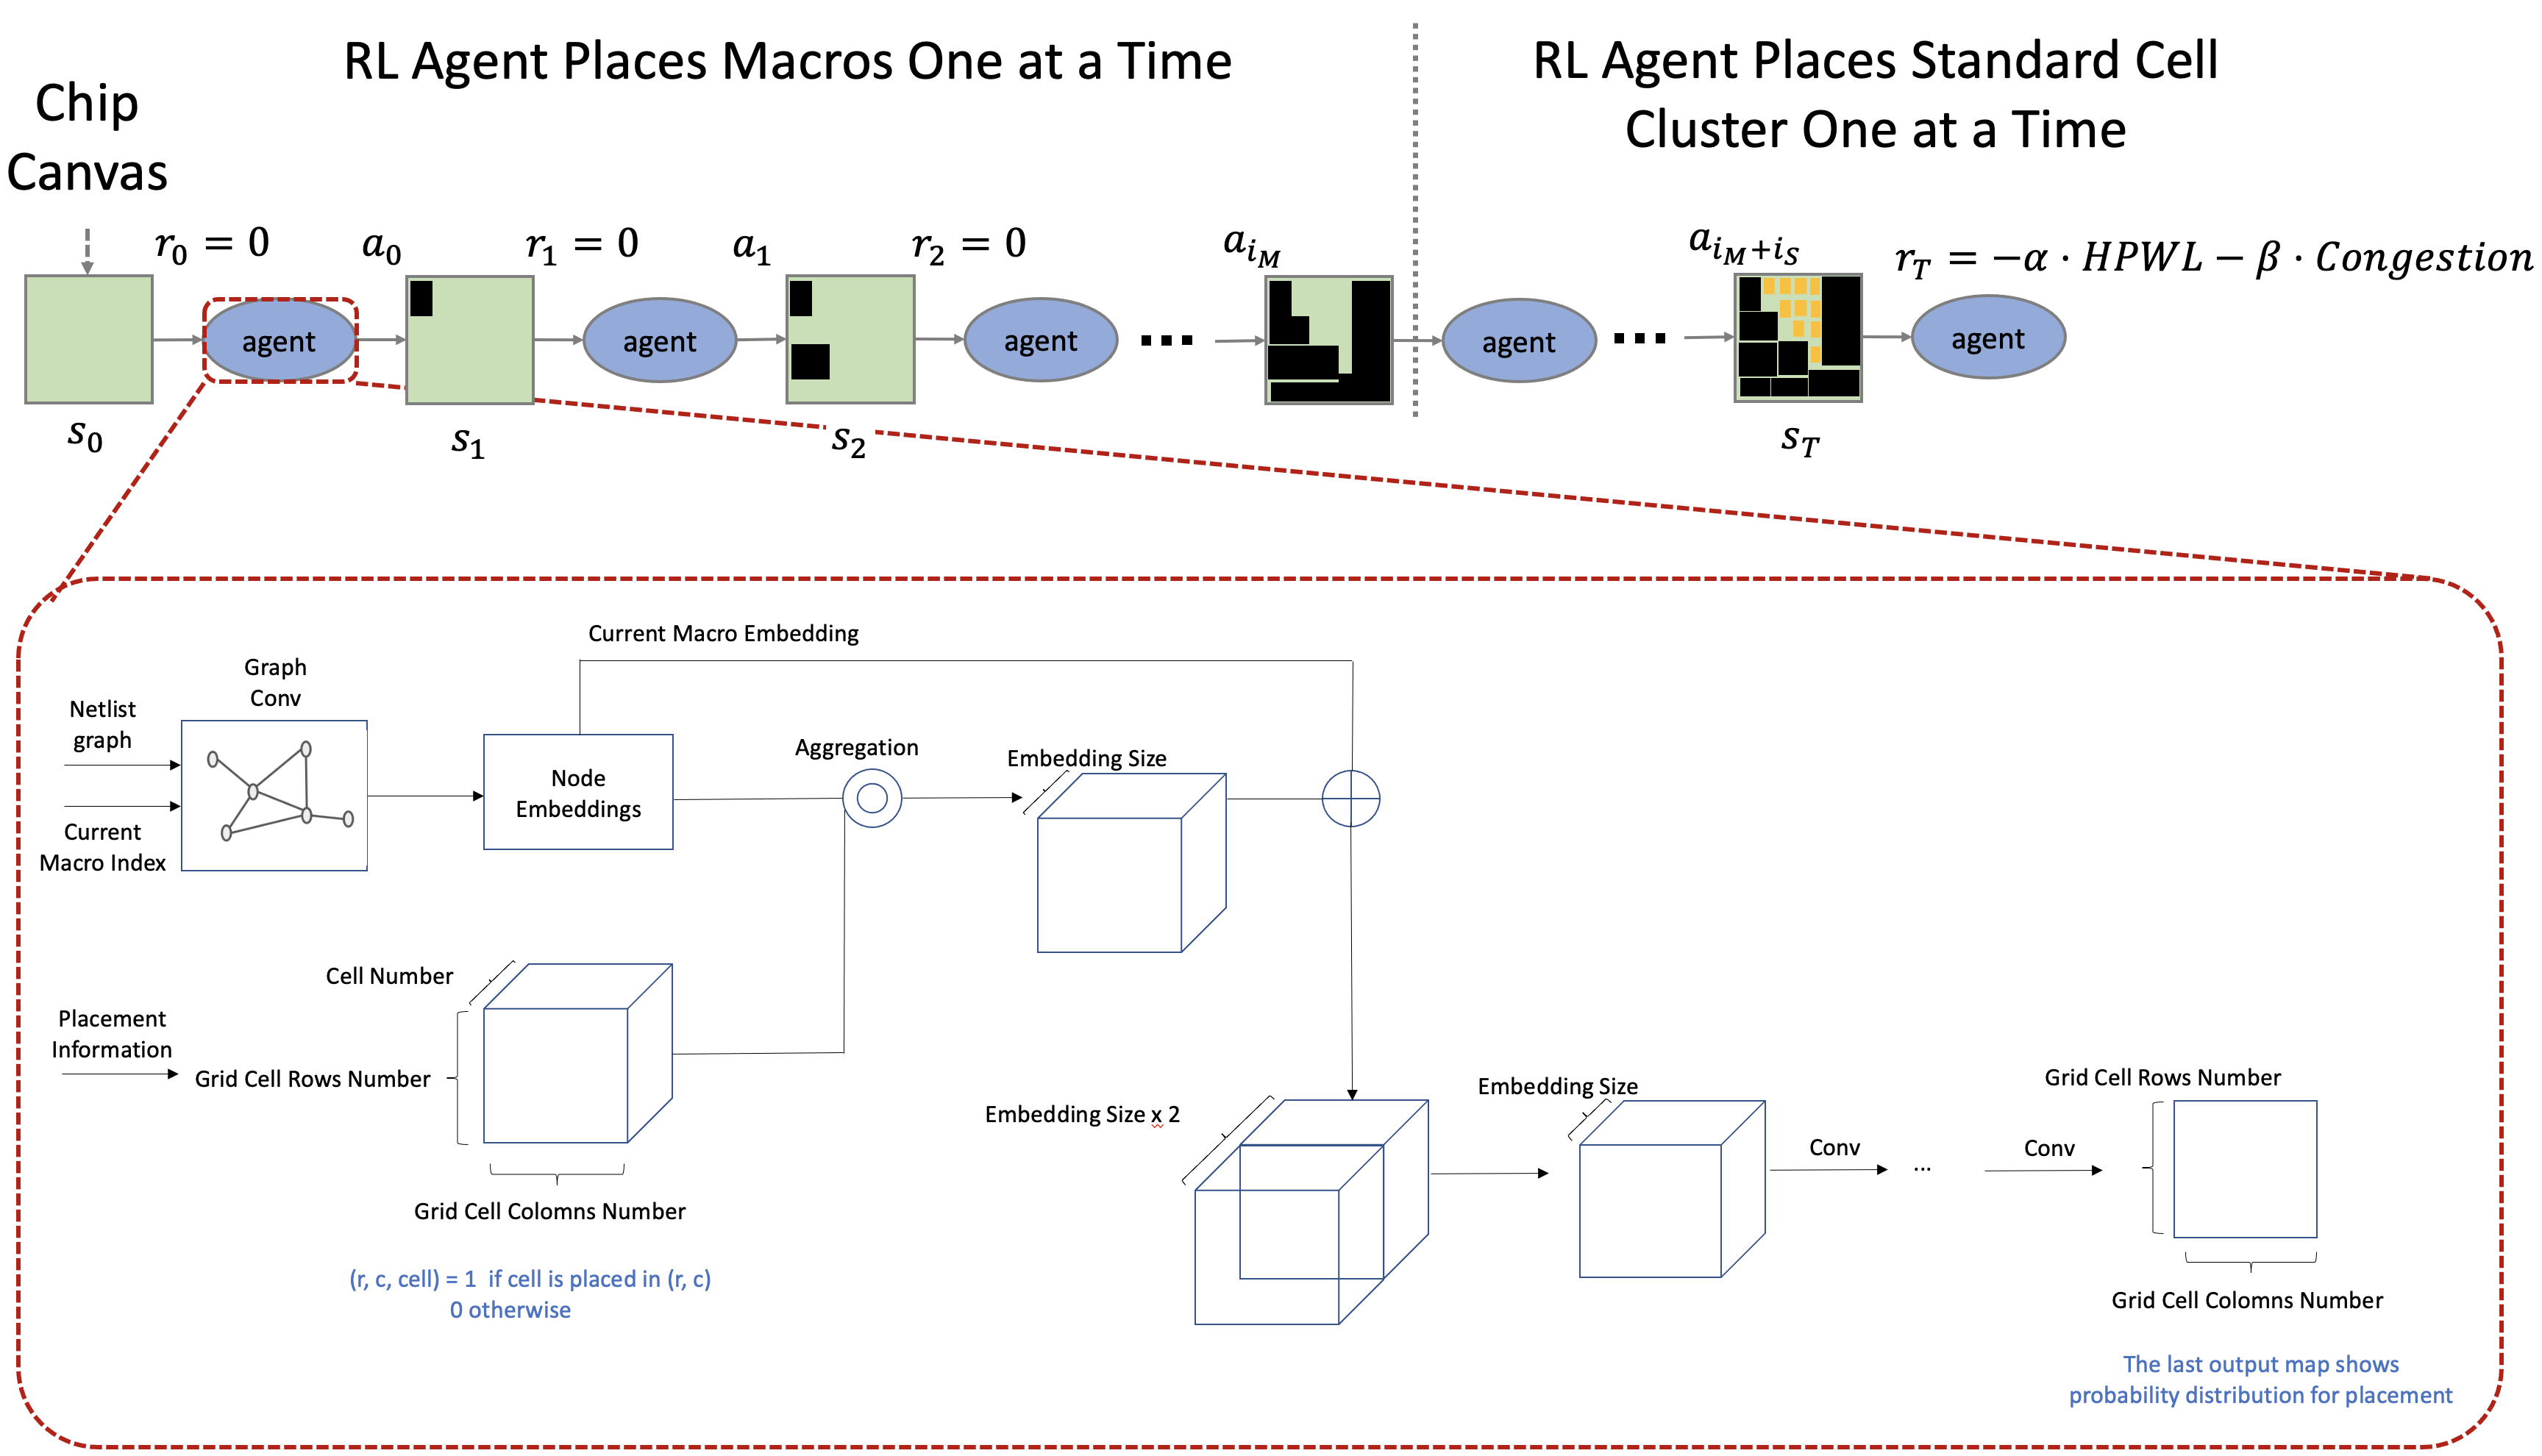
ASIC 물리설계의 floorplan 자동화 문제와 그 어려움을 소개했습니다. 기존 메타휴리스틱 한계를 짚고, 강화학습 기반 접근의 필요성을 설명했습니다.