


강화학습을 이용한 SMT 공정의 Chip Mount Planning 최적화
SMT 공정의 chip mount planning을 강화학습으로 최적화한 초기 결과를 소개했습니다. 33개 sample 실험과 IPC sample 분석을 통해 적용 가능성과 개선 과제를 확인했습니다.
#강화학습#최적화
1700
새로운 기술 블로그가 추가되었어요
SMT 공정의 chip mount planning을 강화학습으로 최적화한 초기 결과를 소개했습니다. 33개 sample 실험과 IPC sample 분석을 통해 적용 가능성과 개선 과제를 확인했습니다.

Dynamics Model을 제어와 시뮬레이션 문제에 활용하는 사례를 소개했습니다. 실제 데이터와 물리 모델을 결합해 sim-to-real gap을 줄이는 가능성을 설명했습니다.
자연어처리의 토픽 모델링을 개인화 추천에 적용하는 방식을 소개했습니다. 사용자 행동 데이터를 바탕으로 관심 주제를 추출해 맞춤형 추천을 구성하는 개념을 설명했습니다.


외부 데이터 제한 환경에서 BART 기반 한국어 대화요약 모델을 개선한 경진대회 사례를 공유했습니다. 사전학습·R3F·강화학습을 조합해 ROUGE-L 기준 성능을 높이고 본선 1위를 달성했습니다.
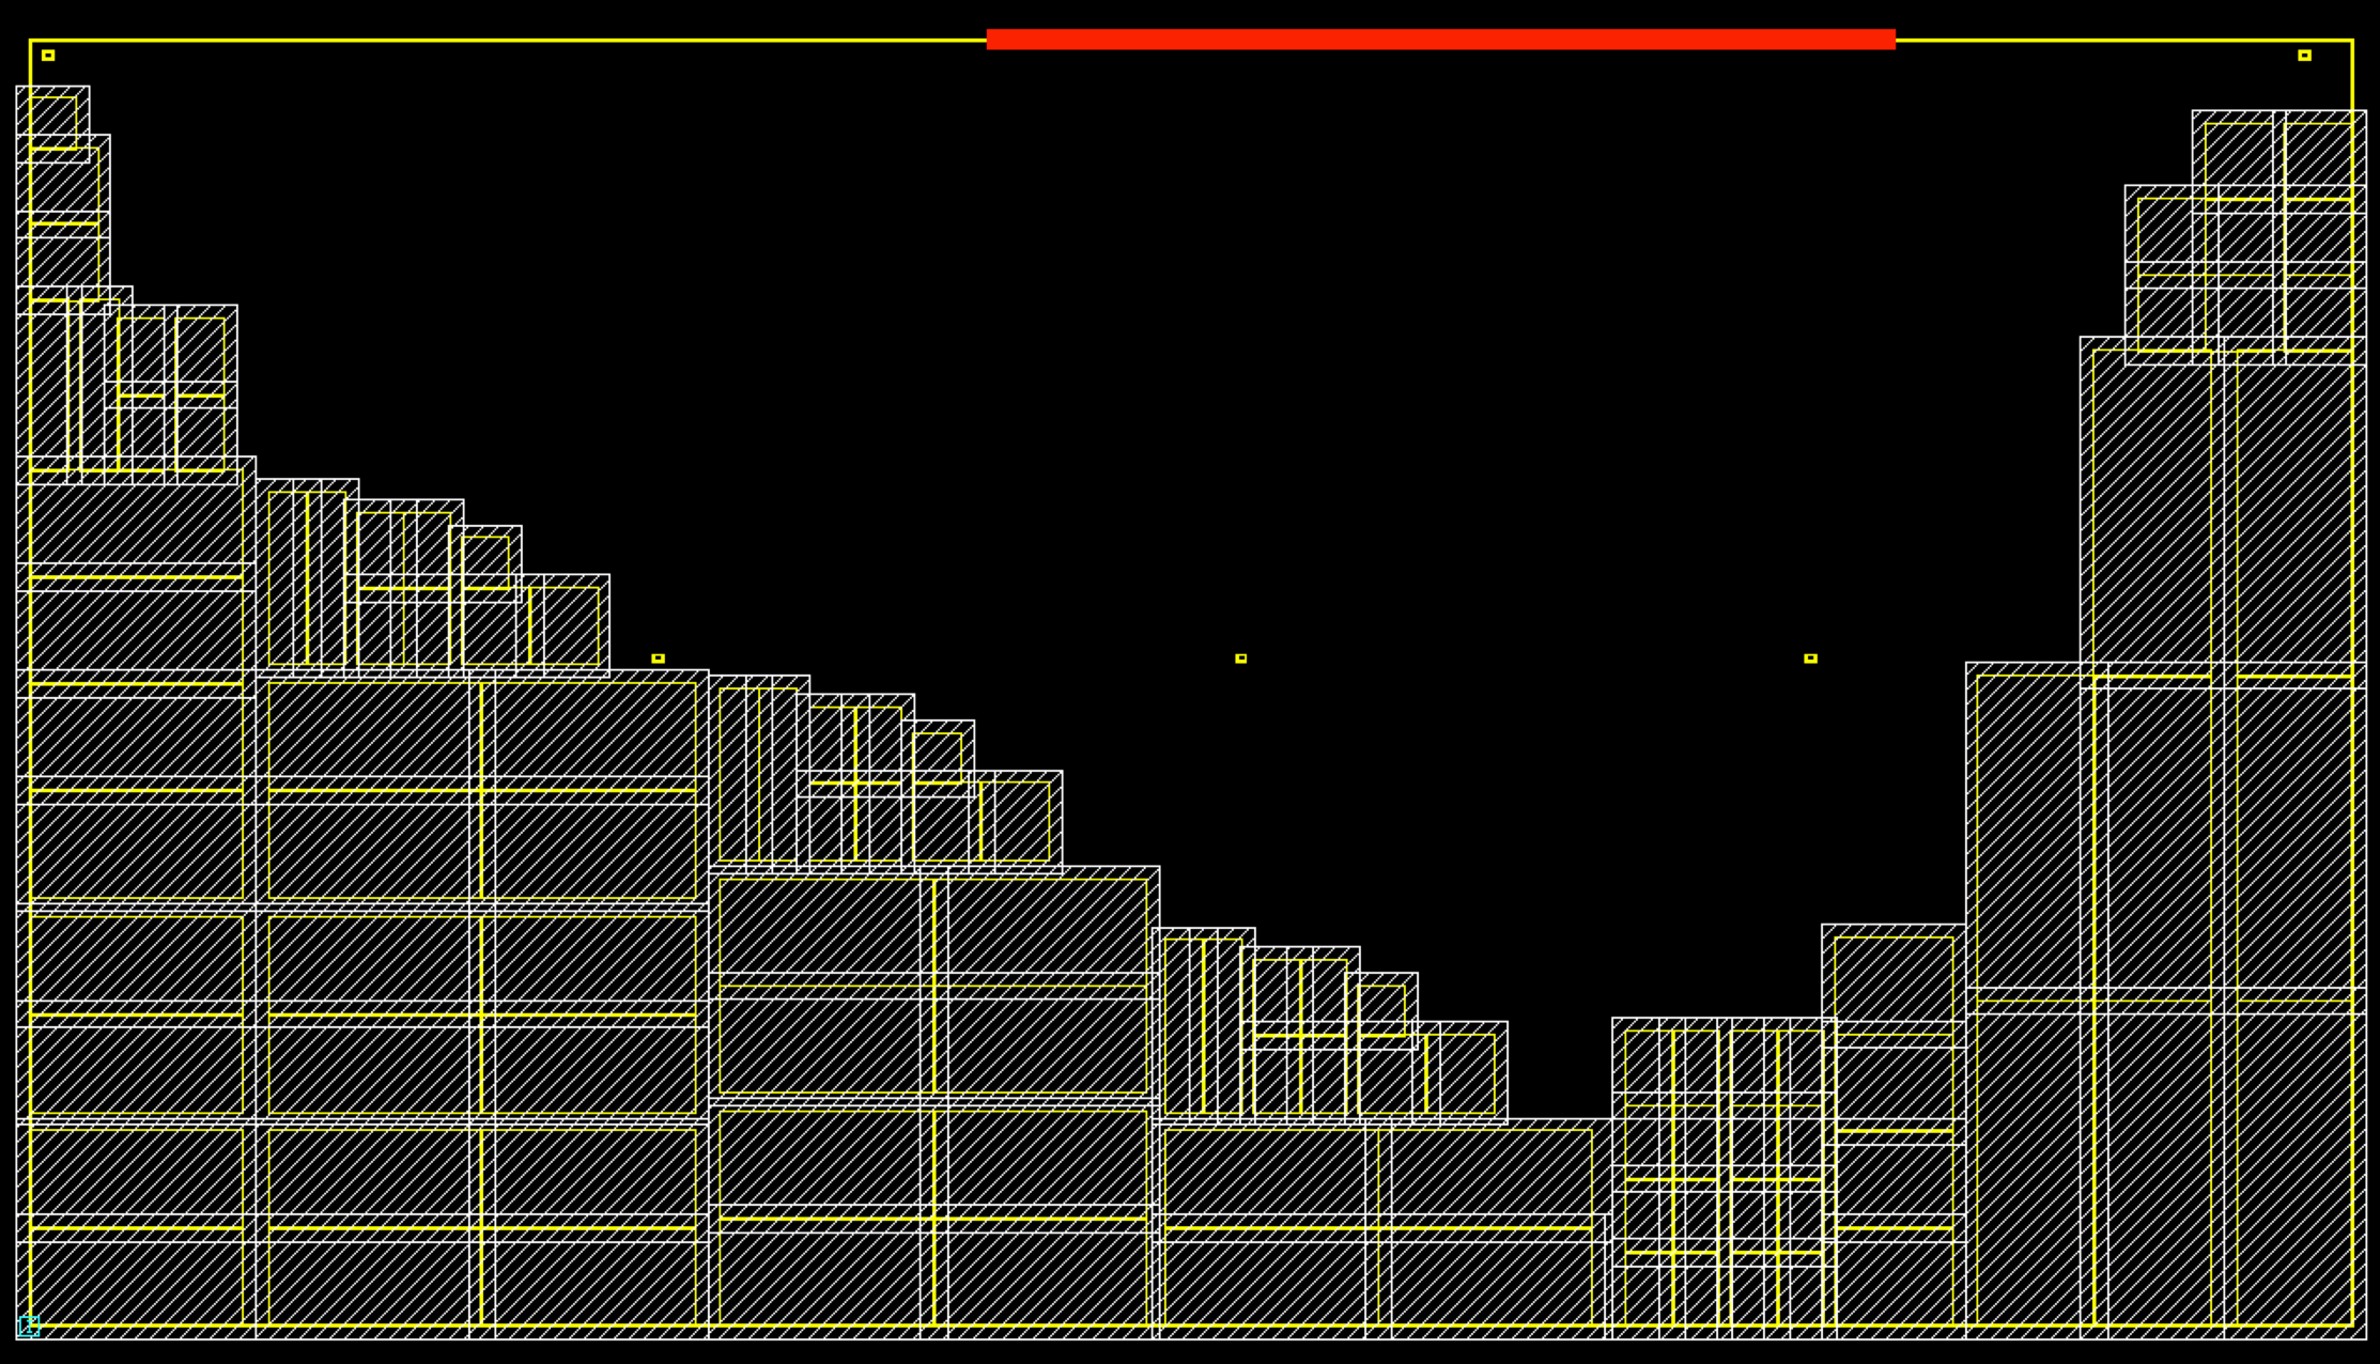
ASIC Floorplan 자동화의 난점과 PPA 기반 평가 기준을 설명했습니다. 강화학습 Placer가 저복잡도 문제에서 전문가·ICC2와 유사한 성능을 보였습니다.
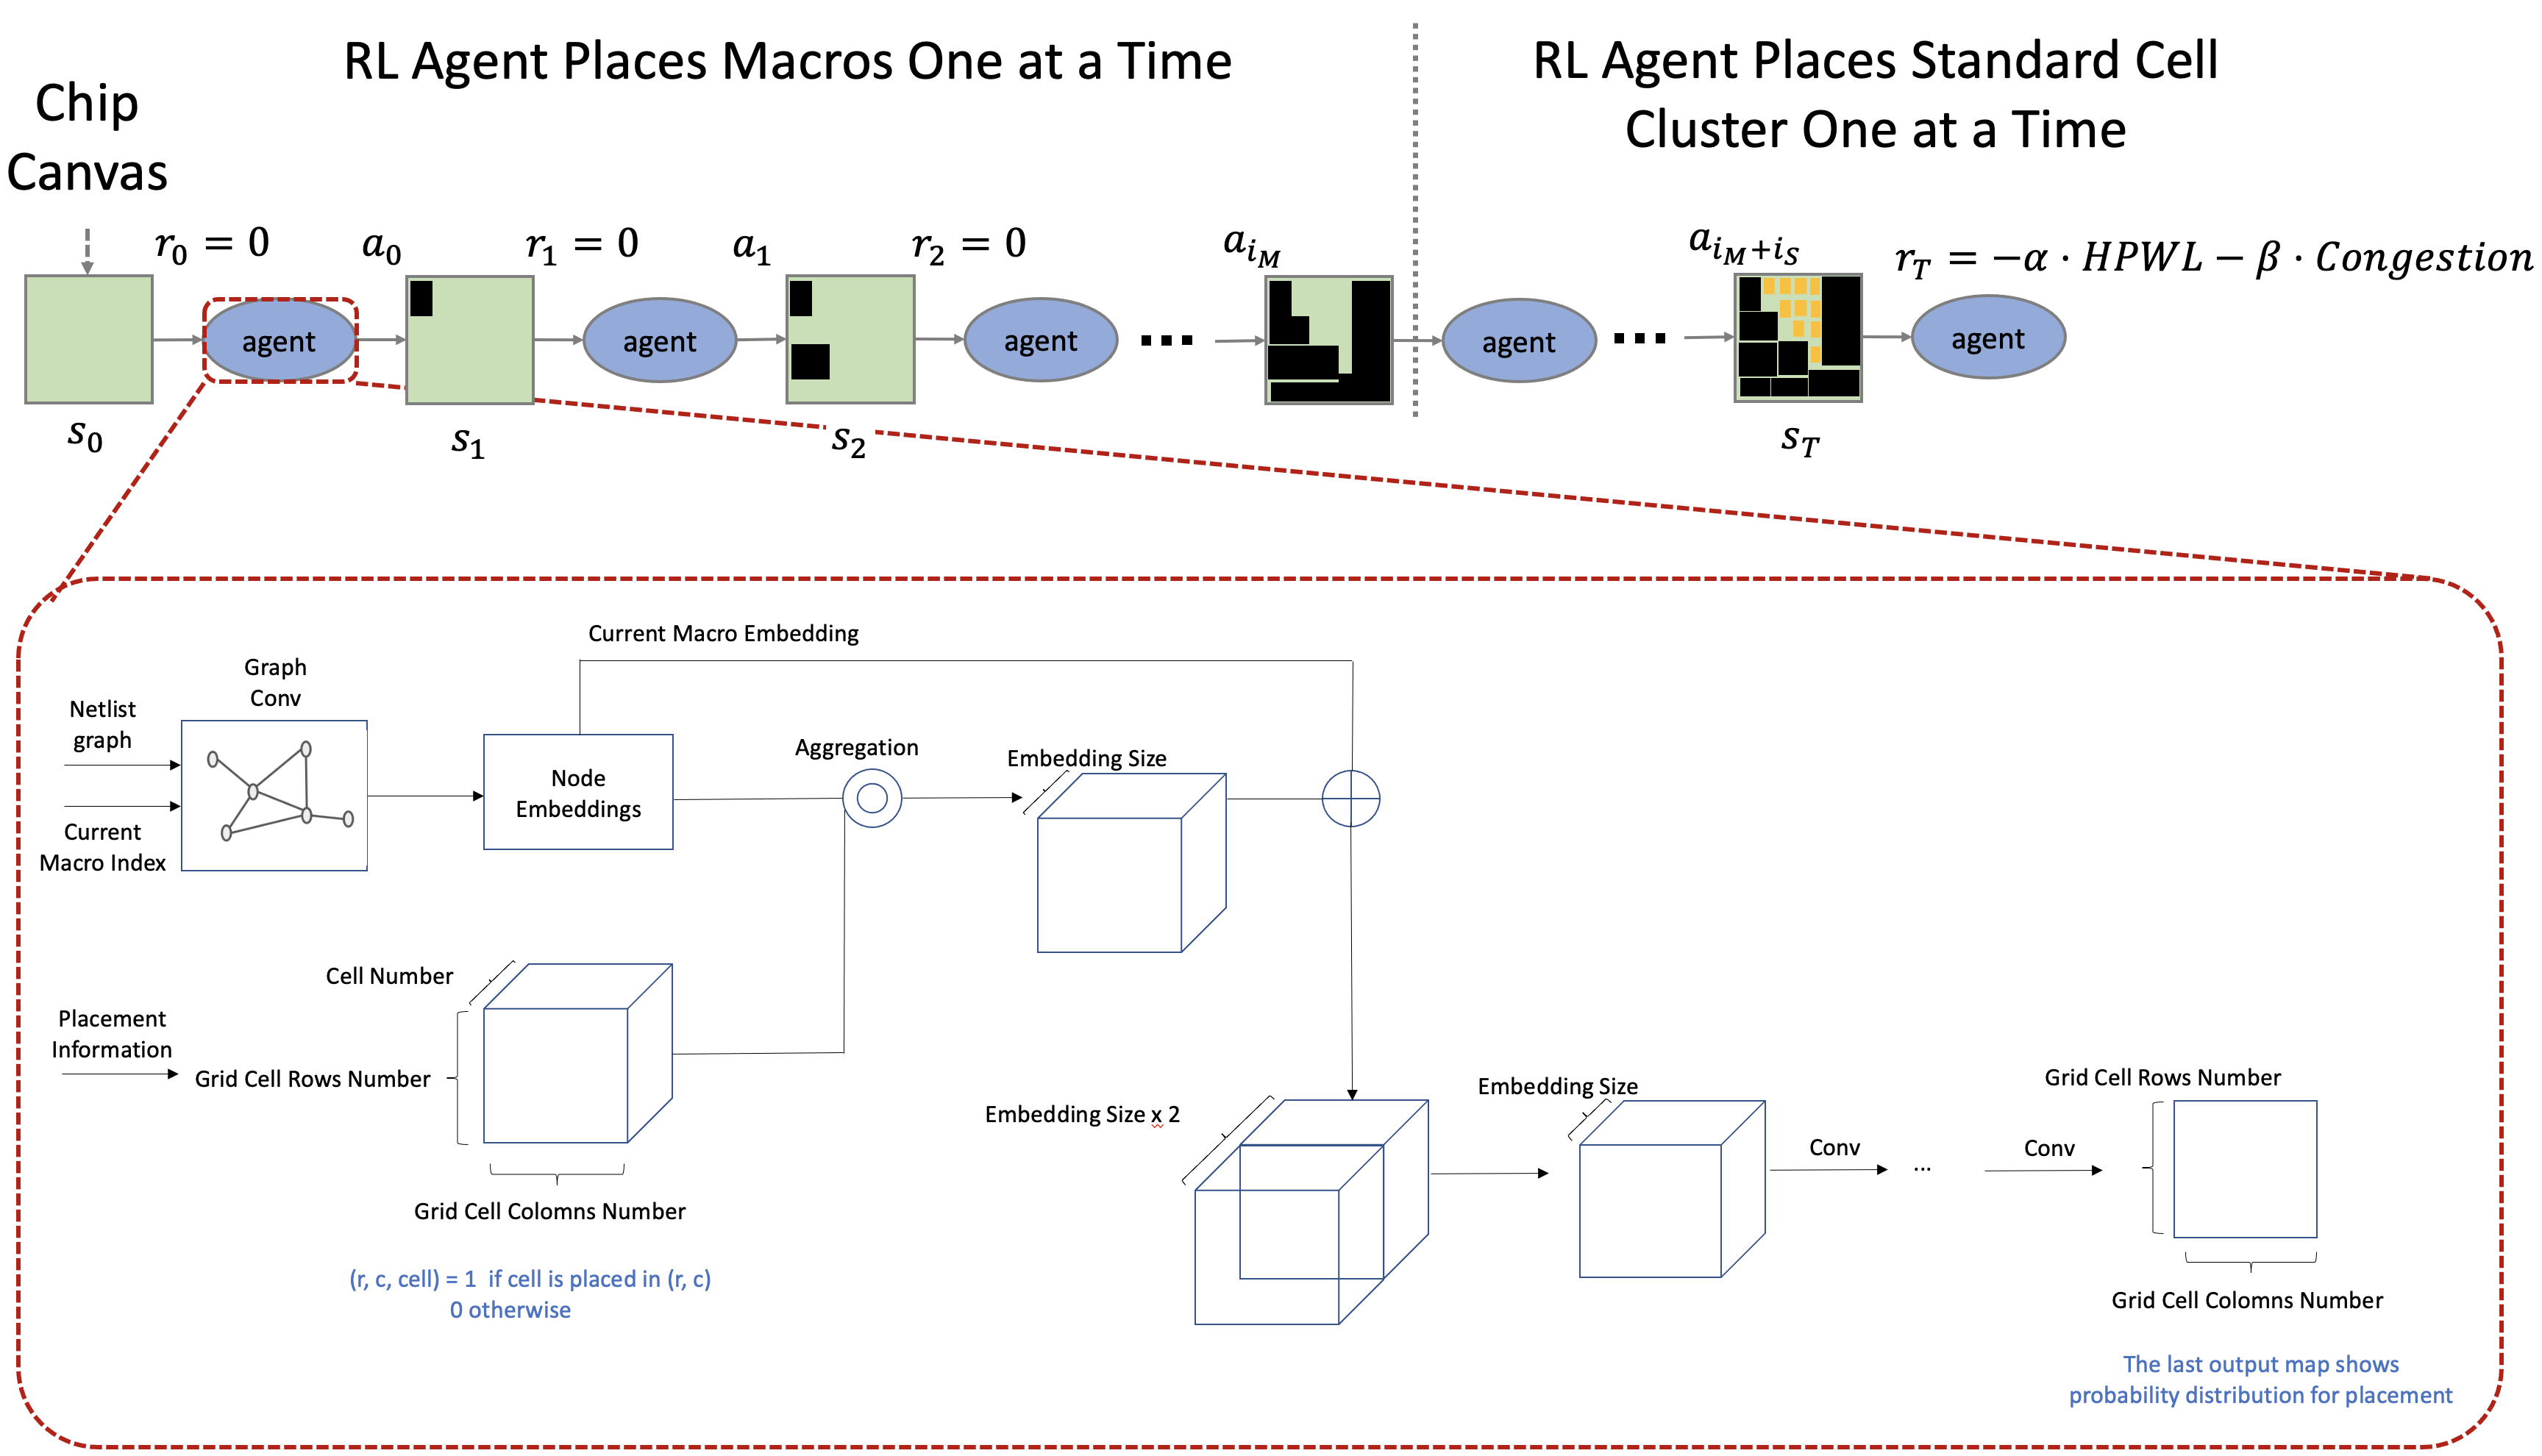
강화학습으로 ASIC Floorplan의 수작업 배치 문제를 자동화하는 환경과 모델을 설계했습니다. GNN·CNN과 HPWL·혼잡도 보상으로 배치 품질을 근사했습니다.

강화학습으로 ASIC Floorplan의 Macro와 Standard Cell Cluster 배치를 최적화했습니다. GNN·CNN과 HPWL·Congestion 보상으로 EDA 기준에 근접한 결과를 확인했습니다.
ASIC Floorplan의 수작업 배치 문제를 강화학습 기반 Placer로 자동화하는 접근을 소개했습니다. 저복잡도 Netlist에서 전문가와 ICC2 자동 배치에 가까운 성능을 확인했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
RLlib의 사용자 지정 포트 분산 학습 오류 원인을 ML-Agents의 포트 연결 방식에서 분석했습니다. worker_id 증가와 유닛 테스트를 추가해 PR로 수정 사항을 반영했습니다.
RLlib Unity3D Wrapper의 사용자 지정 포트 중복 문제를 분석하고 worker_id 증가 방식으로 해결했습니다.\n재발 방지 유닛 테스트와 CI·requirements 수정을 거쳐 PR을 머지했습니다.
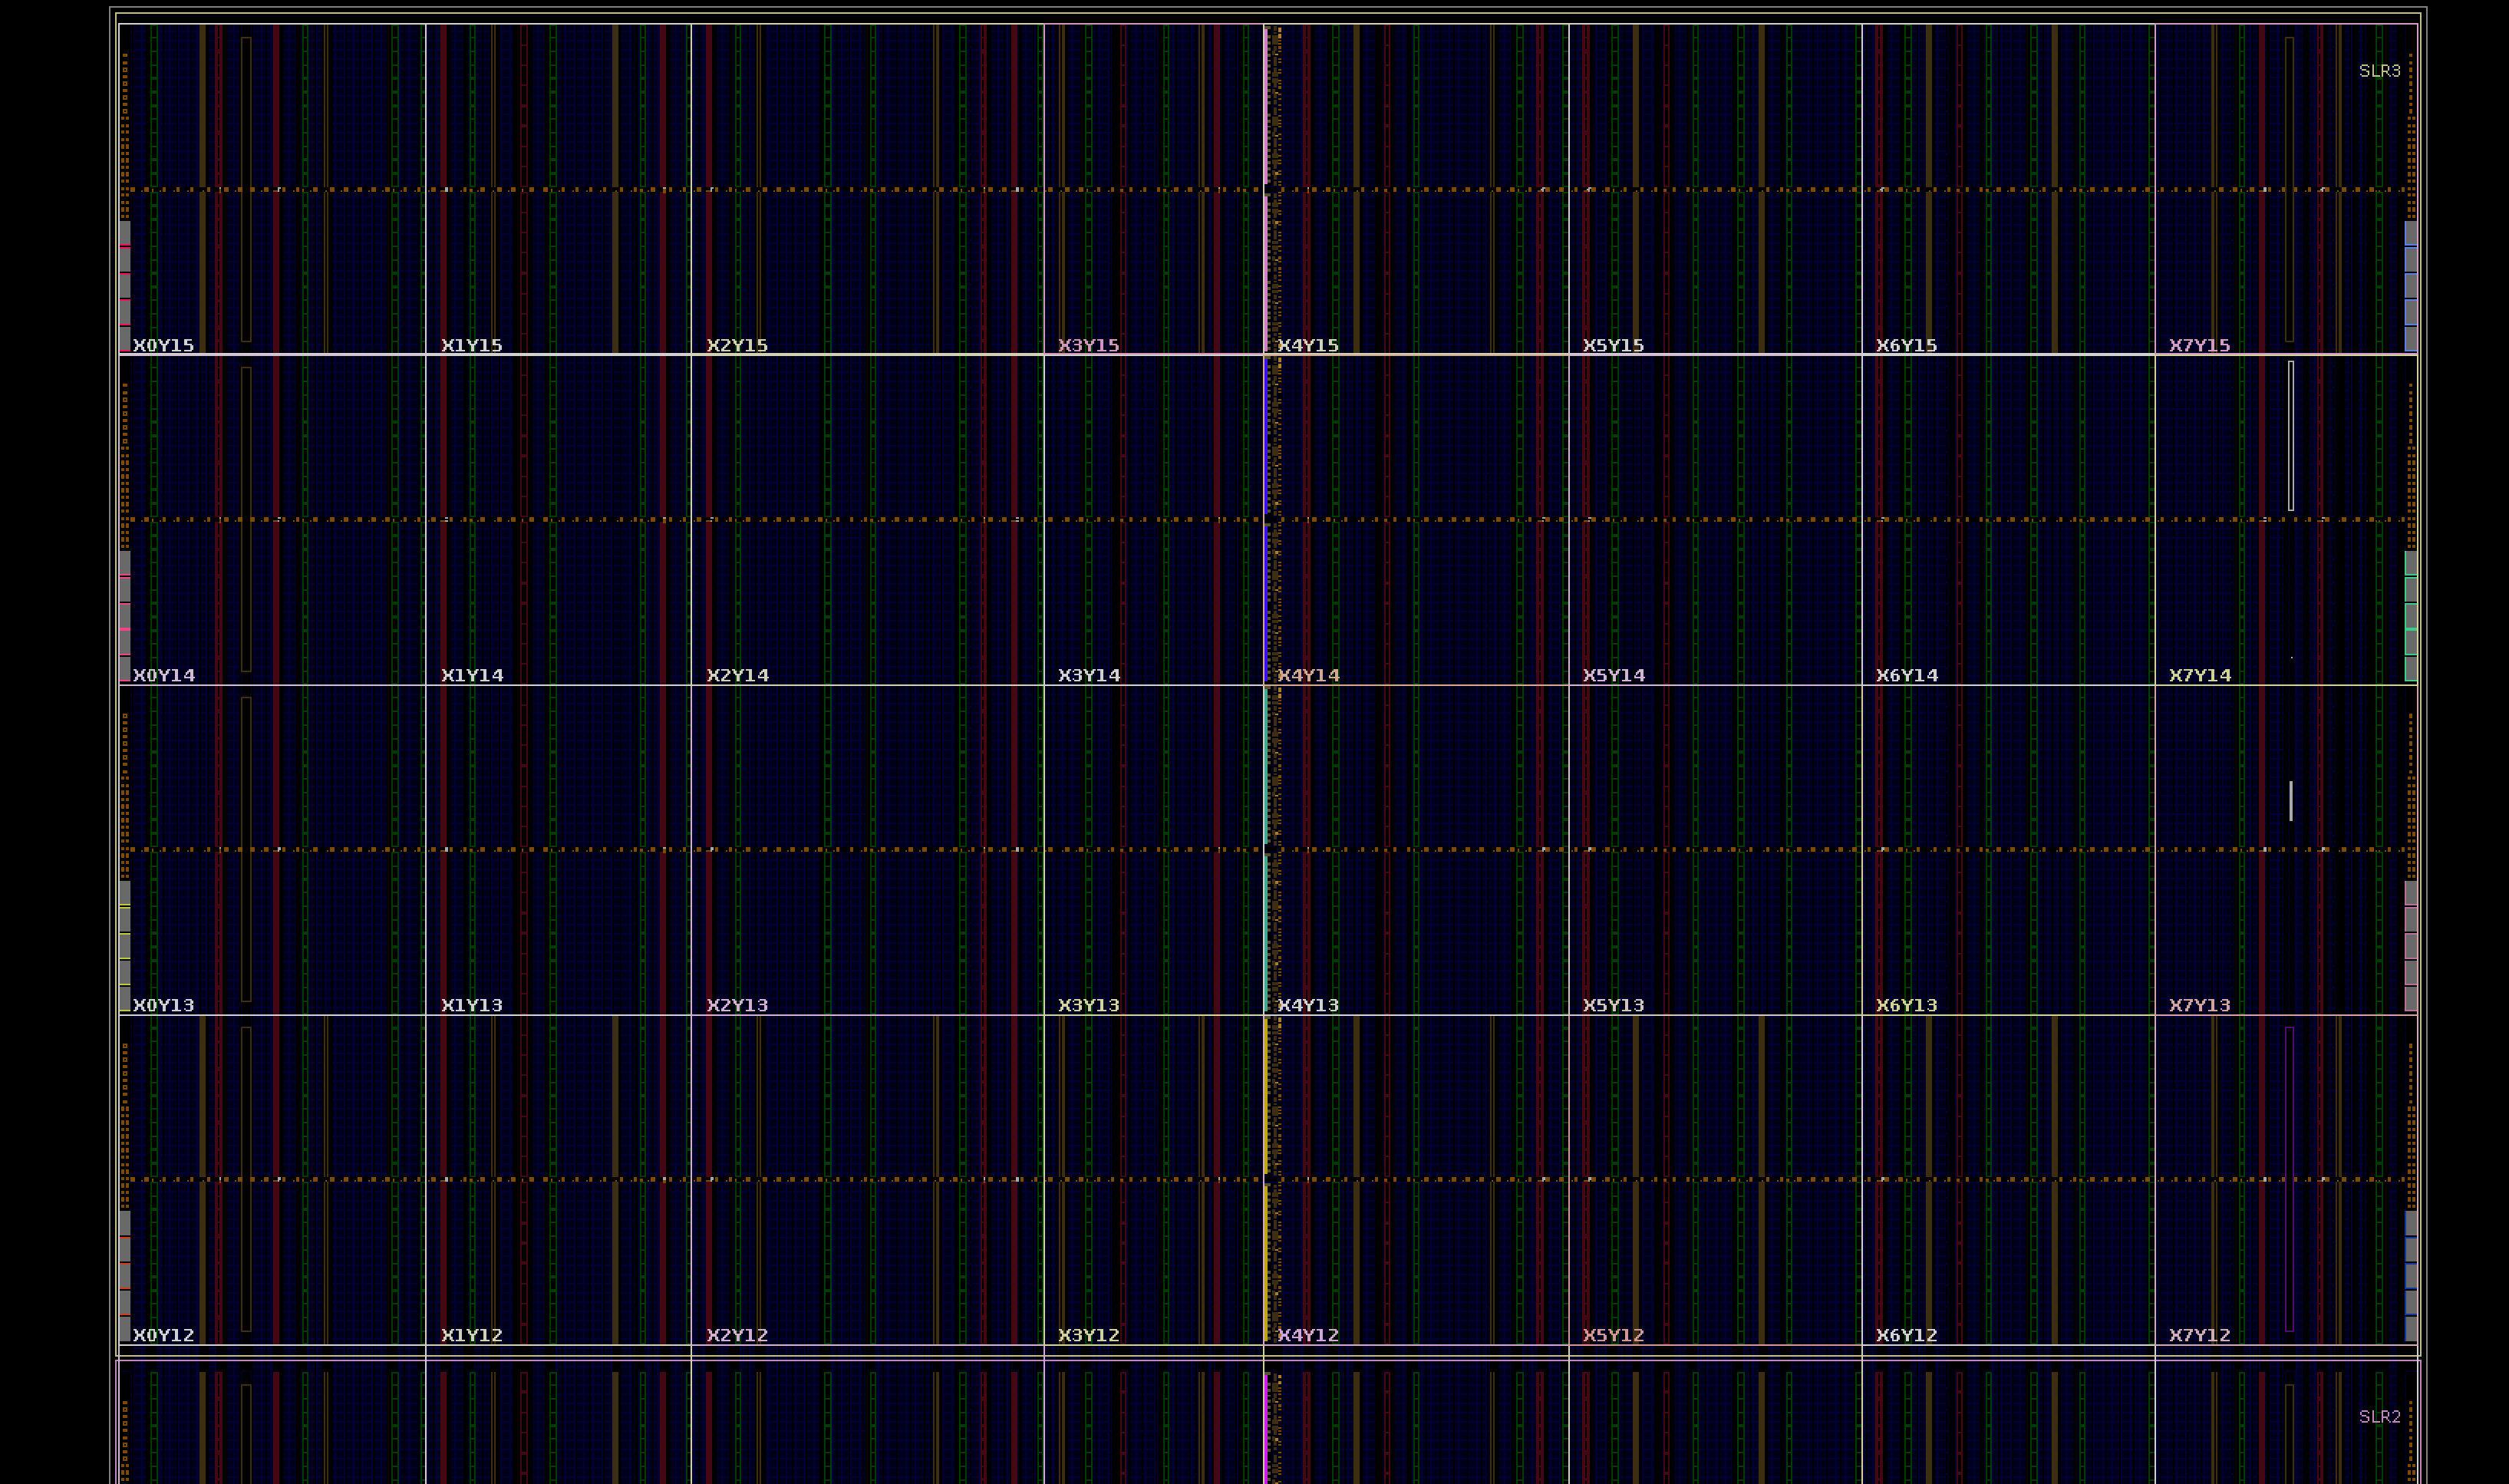
FPGA의 소자 배치를 강화학습으로 자동화하기 위한 환경과 에이전트 구조를 소개했습니다.\nGrid·Mask·보상·그래프 임베딩 설계에서의 도메인 특화 고려사항을 정리했습니다.
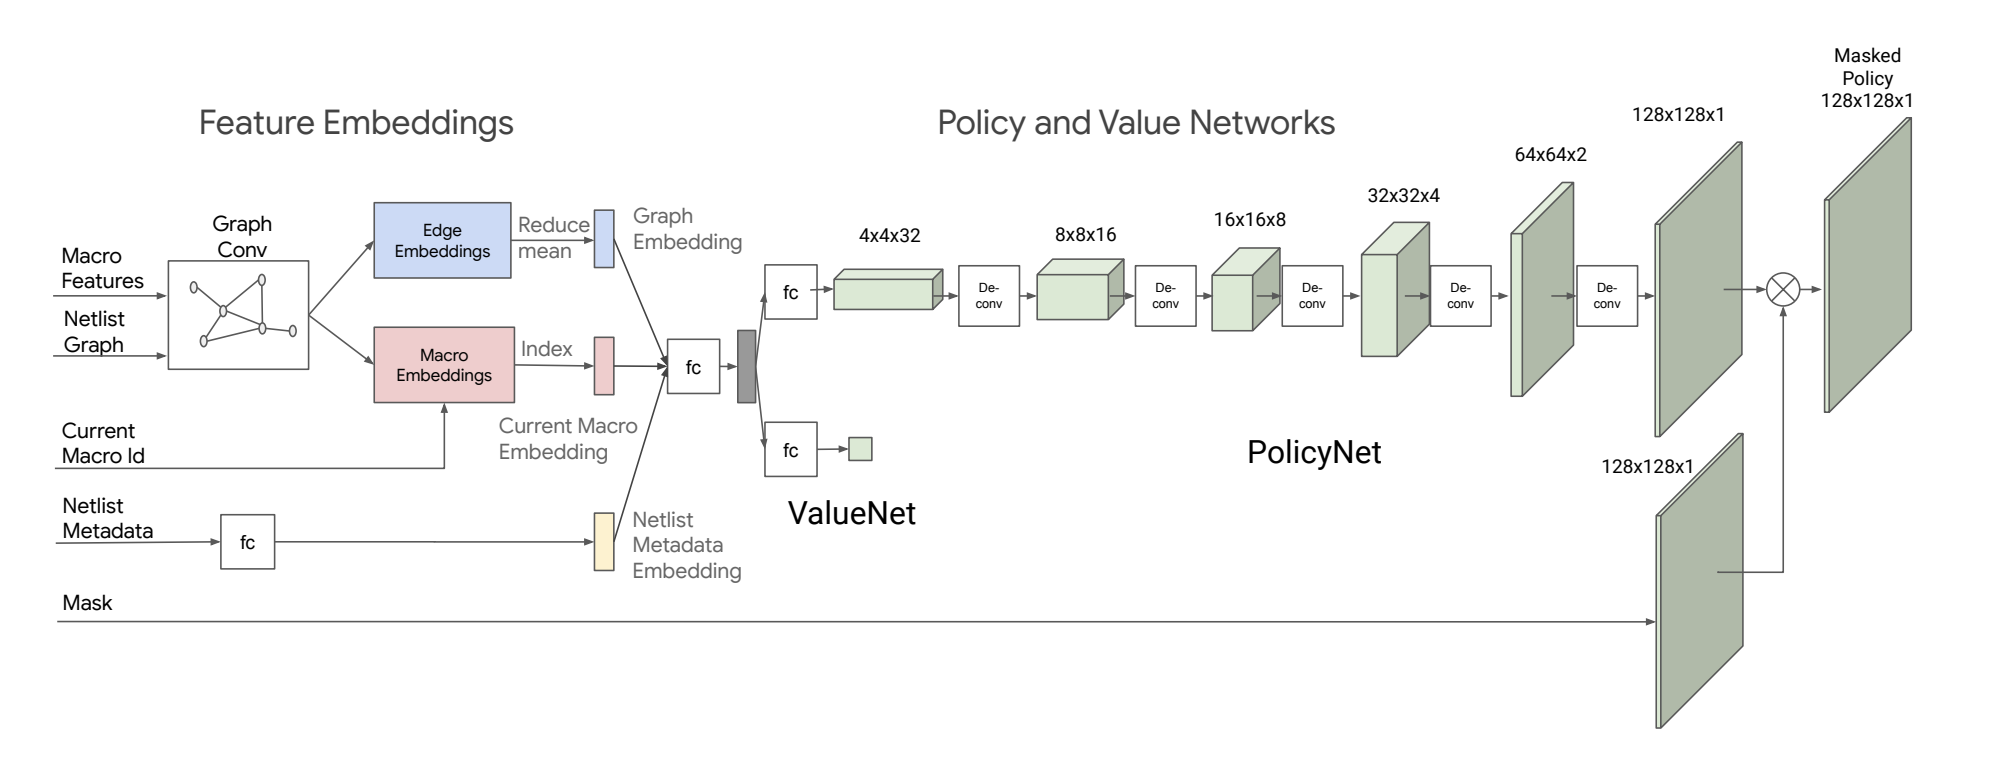
Chip Placement를 Hard Macro 순차 배치 MDP로 정의한 Google의 강화학습 방식을 소개했습니다.\nGNN 상태 인코딩과 Wire Length·혼잡도 보상으로 PPA 제약을 근사했습니다.

강화학습 퍼즐 봇으로 대규모 3매치 게임의 밸런싱 작업을 자동화했습니다.\nMock 환경과 PPO 모델을 활용해 업데이트 영향과 캐릭터 성능을 사전 정량화했습니다.