AI
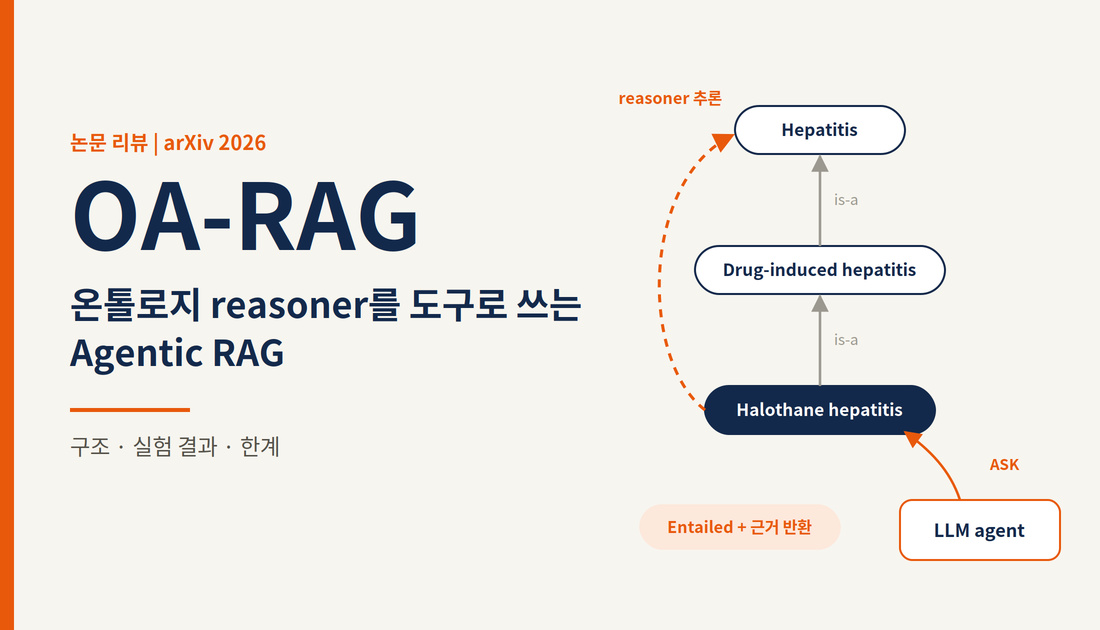
OA-RAG: 온톨로지 reasoner를 도구로 쓰는 Agentic RAG

두줄요약
OA-RAG의 온톨로지 reasoner·LLM 결합 구조와 실험 결과를 분석했습니다. 의료 QA의 효율성과 평가 편향, grounding 신뢰도 한계를 함께 짚었습니다.
구조와 흐름
- OA-RAG의 axiom 기반 논리 추론을 OWL reasoner에, annotation 기반 자연어 해석을 LLM에 분리
- Pre-tool reasoning, SPARQL 기반 ReAct loop, evidence digest 기반 최종 답변의 3단계 처리
- DESCRIBE·ASK·SELECT와 이름 연결·BM25 fallback으로 온톨로지 조회 실패 보완
선택 이유
- 문서 간 논리 연결을 LLM 내부 추론에만 맡기는 일반 RAG의 충실성 검증 한계
- GO·FoodOn·SNOMED CT처럼 형식화된 관계를 가진 지식원에서 명시되지 않은 entailment 도출 가능
- 답변 근거를 entailed·supported·related·unrelated로 구분하는 grounding level 제공
성능/운영 포인트
- Test 1·2에서 동일 온톨로지를 쓰는 ReAct-ont 대비 OA-RAG의 높은 평균 정확도
- Qwen 의료 QA에서 262k context i-MedRAG와 유사한 정확도, 문항당 약 1/10 token 사용량
- 정확한 근거 검색 비율이 객관식 61.7%, 주관식 23.6%에 그쳐 검색 단계가 주요 병목
주의할 점
- Test 1·2 정답이 OA-RAG 조회 대상 온톨로지의 reasoner 결과에 기반한 평가 설계
- Test 3에서 tool 제거 후 정확도 차이가 1%p 미만인 온톨로지 기여도 한계
- LLM 자기평가형 grounding level의 신뢰도 한계와 OWL 온톨로지 구축·closure 재계산 비용