데브옵스
S3 기반 데이터 티어링 도입기
두줄요약
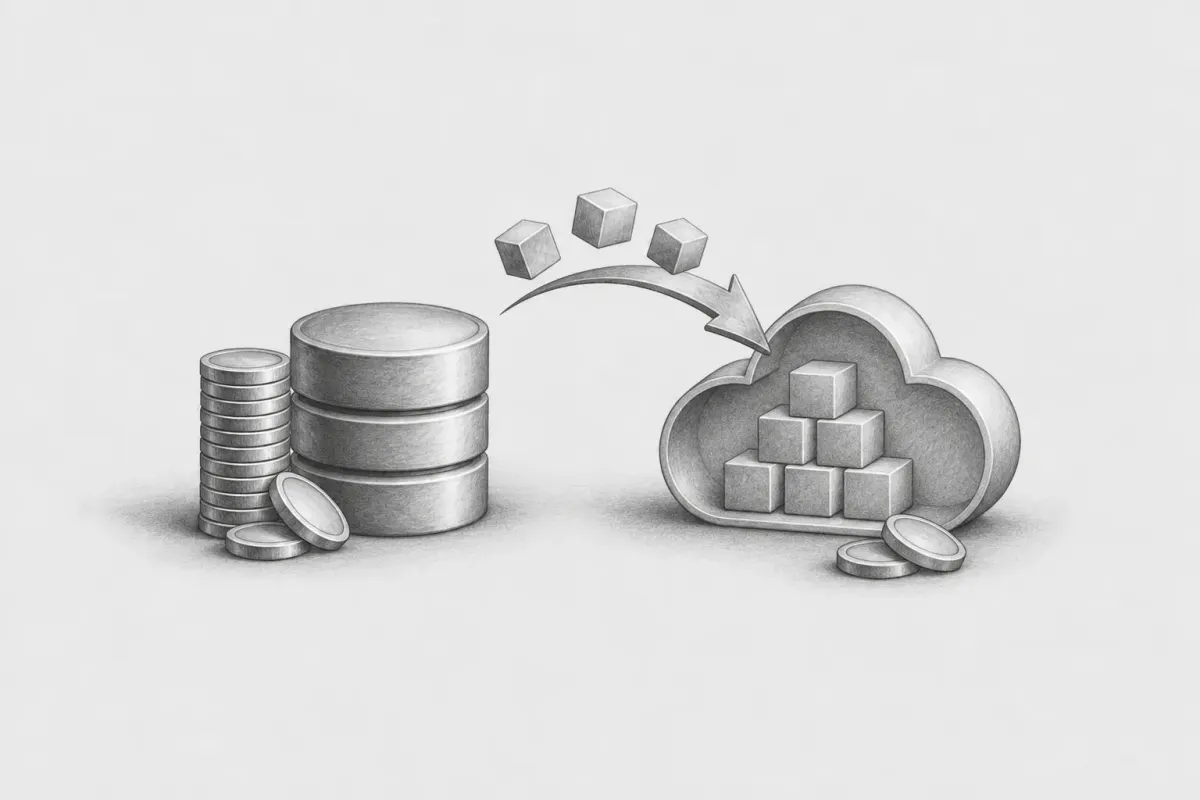
MSA 분산 로그 증가로 발생한 MongoDB 비용과 성능 문제를 데이터 티어링으로 해결했습니다. 최근 로그는 MongoDB에, 장기 로그는 S3에 자동 이관해 저장 비용과 메모리 부하를 줄였습니다.
문제 상황
- MSA 환경의 분산 로그 급증으로 MongoDB 용량·인덱스 확장과 RAM 압박 발생
- Replica Set 기반 고성능 스토리지 비용 증가와 디스크 I/O 병목에 따른 쿼리 지연
구조와 흐름
- 최근 30일 로그는 MongoDB Hot Tier, 31일~1년 로그는 AWS S3 Standard Cold Tier로 분리
- 2,000건 커서 페이징과 임시 파일 스트리밍으로 로그를 파일화한 뒤 S3 업로드
- 업로드 완료 후 ID 기준 10,000건 단위 배치 삭제 및 S3 객체 만료 설정
선택 이유
- 최근 로그 중심의 조회 패턴과 장기 로그의 감사·사후 분석 목적 구분
- S3의 낮은 저장 비용과 서버리스 객체 스토리지를 통한 저장소·컴퓨팅 분리
- 제네릭과 함수형 인터페이스 기반 공통 마이그레이션 로직 재사용
성능/운영 포인트
- MongoDB 보관 범위 고정으로 인덱스를 RAM 용량 내 관리
- 대량 데이터를 메모리에 적재하지 않는 스트리밍·배치 처리로 OOM 및 DB 쓰기 부하 완화
- 오래된 로그의 저비용 보관과 프로덕션 쿼리 지연 완화