포스코DX의 엔지니어링 암묵지를 AI가 활용할 수 있는 지식 자산으로 전환하기
포스코DX는 현장 암묵지를 AI가 활용할 수 있는 지식 자산으로 전환하는 PoC를 진행했습니다. Graphiti와 Amazon Bedrock 기반 지식 그래프로 설계 규칙을 구조화하고, 검색과 추론까지 자동화했습니다.
#LLM#RAG#지식 그래프
3800
포스코DX의 엔지니어링 암묵지를 AI가 활용할 수 있는 지식 자산으로 전환하기

포스코DX는 현장 암묵지를 AI가 활용할 수 있는 지식 자산으로 전환하는 PoC를 진행했습니다. Graphiti와 Amazon Bedrock 기반 지식 그래프로 설계 규칙을 구조화하고, 검색과 추론까지 자동화했습니다.
하나투어는 Amazon Neptune 기반 GraphRAG와 Bedrock AgentCore로 여행상품 기획 에이전트를 구축했습니다. 수작업 초안 시간을 2~3일에서 2~3분으로 줄이고, 관계 기반 그라운딩으로 환각을 낮췄습니다.
Amazon Bedrock AgentCore로 에이전트 운영의 관측성, 평가, 최적화를 하나의 AgentOps 사이클로 정리했습니다. 트레이스와 메트릭, 로그를 바탕으로 품질과 안전성을 지속 개선하는 흐름을 설명했습니다.
에이전틱 AI를 프로덕션에 올리기 위한 AgentOps와 파운데이션, 게이트웨이 패턴을 소개했습니다. Amazon Bedrock AgentCore로 모델, 도구, 에이전트 접근을 통합하는 방법을 설명했습니다.
공모전 브리핑 작성의 진입 장벽을 낮추기 위해 AWS Bedrock과 Strands Agents SDK 기반 AI 에이전트를 도입했습니다. 초안 생성과 검수, 분석을 분리해 응답 속도와 운영 효율을 높이고, 브리핑 이탈률도 줄였습니다.
동원F&B가 Bedrock AgentCore와 OpenSearch 하이브리드 검색으로 AI 쇼핑 어시스턴트를 구축했습니다. 토큰 97% 절감과 TTFT 2.58초 개선, CS 문의 23% 감소 성과를 얻었습니다.

Deep Insight의 Inner Loop 챗봇 설계에서 데이터 보호, 속도, 신뢰성, 비용을 맞추는 4가지 결정을 정리했습니다. DuckDB 샌드박싱과 세션 단위 OLAP 상주, SQL 투명성, prompt cache로 대화형 분석 도구를 구현했습니다.
농약 제품 사진을 인식해 정보를 찾는 3단계 AI 검색 시스템을 구축했습니다. Vision LLM 오인식을 오타 보정, OpenSearch Fallback, LLM Reranker로 보완했습니다.
Amazon Bedrock에서 Claude Code와 Codex를 함께 돌리는 협업 하네스를 구현해 48런 실험을 진행했습니다. 단독 실행보다 교차 리뷰가 버그를 더 잘 잡았고, 하네스 설계가 결과를 좌우함을 확인했습니다.
프롬프트 인젝션에 대비해 에이전트 보안을 LLM 밖의 인프라에서 강제하는 다층 방어 패턴을 설명했습니다. AgentCore, JWT 전파, RLS, Index Mapper로 사용자 간 데이터 경계를 지키는 방법을 정리했습니다.
Sim-to-Real과 Real-to-Sim이 Physical AI의 현실 적용을 가로막는 격차를 어떻게 줄이는지 설명했습니다. 시뮬레이션 충실도와 합성 데이터 파이프라인이 VLA 성능을 좌우한다고 정리했습니다.
온톨로지와 분산형 에이전트 구조로 소형 언어모델 기반 AI 챗봇을 고도화했습니다. 멀티턴 대화와 주제 전환을 처리하면서 정확도, 비용, 지연 시간을 함께 개선했습니다.

패션 이커머스의 부정 반품 요청을 차단하기 위해 Amazon Nova 2 Lite를 Fine-tuning해 도메인 특화 가드레일을 구축했습니다. 837개 샘플 학습으로 Unsafe 탐지 정확도를 94.6%까지 높였고, 소형 모델의 비용 효율성도 확인했습니다.
Amazon Braket에서 양자-고전 하이브리드 잡을 생성하고 실행하는 방법을 소개했습니다. 콘솔 기반과 코드 기반의 차이, 런타임과 디바이스 선택 흐름도 함께 설명했습니다.

AWS와 NVIDIA Isaac으로 Physical AI를 시뮬레이션과 실세계 학습으로 나눠 가속화하는 아키텍처를 소개했습니다. 엣지 배포와 운영 데이터 재학습을 통해 sim-to-real gap을 줄이는 방법을 설명했습니다.

OpenSearch 기반 이력서 검색에서 하이브리드 검색과 자연어→DSL 변환을 최적화한 사례를 다뤘습니다. Function Calling과 RAG를 결합해 검색 정확도와 응답 속도를 개선했습니다.
기존 상품명 중심 검색의 한계를 해결하기 위해 Amazon Bedrock Knowledge Bases 기반 자연어 검색 시스템을 구축했습니다. 하이브리드 검색과 메타데이터 필터링, 병렬 처리로 정확도와 응답 속도를 개선했습니다.

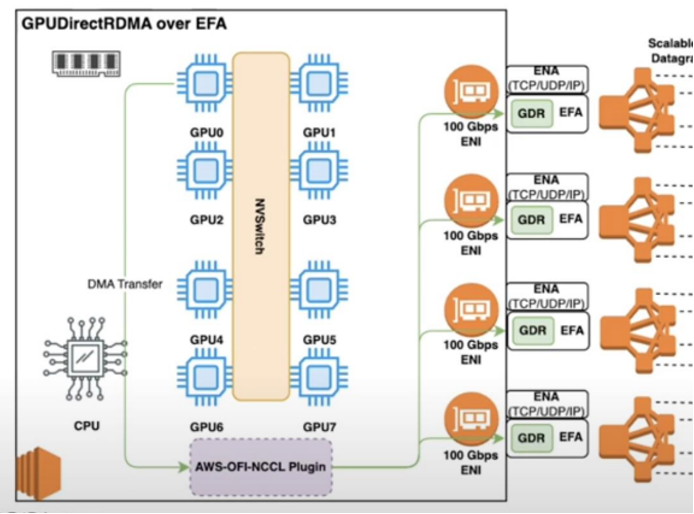
AWS 분산 트레이닝에서 GPU 간 통신 기술의 발전과 최적화 방향을 정리했습니다. MoE와 Dense 모델에 따라 NCCL, NVSHMEM, PPLX-kernels의 선택 기준을 설명했습니다.