

Amazon Bio Discovery 사용법: AI 항체 설계 실습
Amazon Bio Discovery의 항체 후보 설계부터 분석·Wet Lab 연계까지의 사용 과정을 소개했습니다. HER2 실습을 통해 Recipe·Experiment 구성과 EU 기반 비용 구조를 확인했습니다.
#Amazon Bio Discovery#AWS
000
새로운 기술 블로그가 추가되었어요
Amazon Bio Discovery의 항체 후보 설계부터 분석·Wet Lab 연계까지의 사용 과정을 소개했습니다. HER2 실습을 통해 Recipe·Experiment 구성과 EU 기반 비용 구조를 확인했습니다.
인프라 티켓 반복 업무를 신청·승인·배포 포털로 전환한 배럭 구축 사례를 소개했습니다. 기존 ArgoCD·Terraform 파이프라인을 재사용하며 안전한 셀프서비스를 구현했습니다.
Amazon Quick으로 사내 데이터와 업무를 연결하는 AI 에이전트 실습을 소개했습니다. 보안 거버넌스와 자연어 기반 분석·자동화 기능을 함께 다뤘습니다.
Jev와 AWS DevOps Agent를 결합한 Slack DevOps 봇의 판단·조사 구조를 소개했습니다.\n규칙보다 팀 지식과 피드백을 활용해 품질을 높이고 관리형 에이전트 한계를 보완했습니다.
AWS Elemental Live와 AWS 서비스를 활용한 모바일 라이브커머스 재방송 자동 송출 사례를 소개합니다. 라이브 종료 후에도 방송을 이어가기 위한 운영 자동화에 초점을 맞췄습니다.
IVS 단일 리전 의존과 이중 송출 운영 문제를 해소하기 위해 Elemental Live를 도입했습니다. 인코딩·먹싱·재방송을 통합하고 이중화와 비용 절감 방향을 정리했습니다.

AWS에서 VLA·강화학습용 Physical AI 학습, 시뮬레이션 검증, 엣지 배포 파이프라인을 구성했습니다.\n학습 특성에 따라 SageMaker Pipelines·HyperPod를 선택하고 Greengrass로 모델을 배포합니다.
무븐트는 AWS 이벤트 기반 파이프라인으로 댄스 영상을 구조화된 학습 데이터로 변환했습니다.\nGPU 추론과 API를 분리한 다중 계층 서빙으로 성능과 확장성을 개선했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
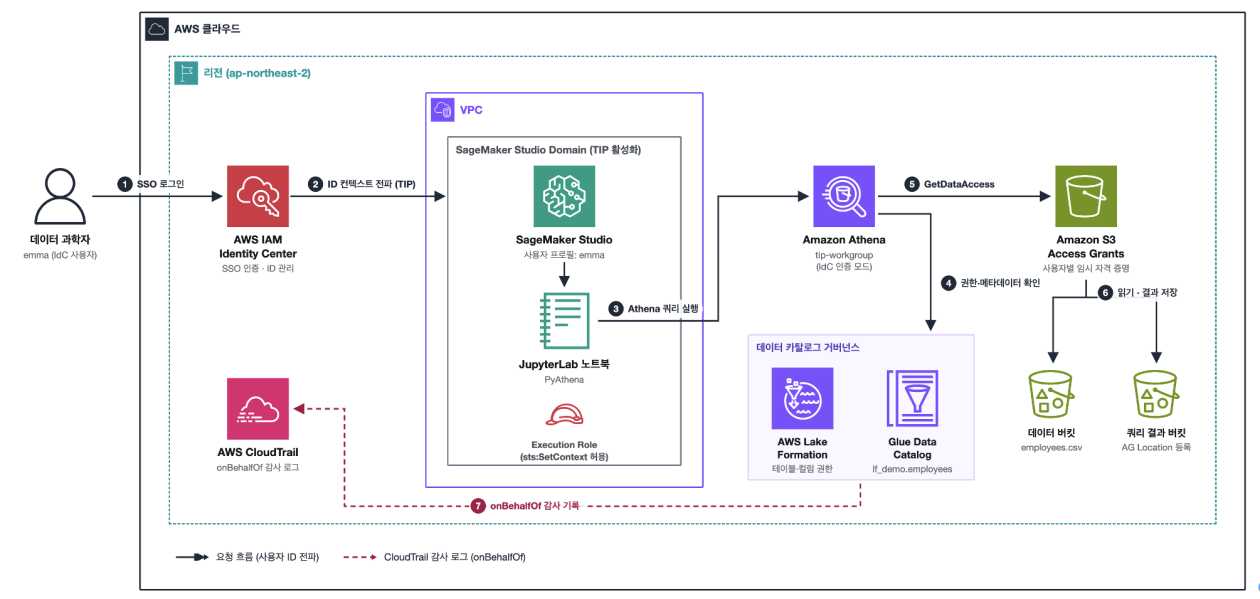
SageMaker Studio의 TIP로 사용자 ID를 Athena·S3·Lake Formation까지 전파하는 구성을 안내했습니다. S3 Access Grants와 CloudTrail을 통해 사용자별 권한 제어 및 감사 추적을 구현했습니다.

AWS Elastic Disaster Recovery로 온프레미스 21대 서버의 DR 환경을 구축한 사례를 정리했습니다. 복제, 부팅, 서비스 단계의 이슈와 서버별 복구 목표 설정 과정을 공유했습니다.
장애 대응과 별개로 복구 설계를 사전에 준비해야 한다는 점을 RTO/RPO로 설명했습니다. 워크로드 티어링과 DR 전략 선택, 정기적인 복구 테스트의 필요성을 정리했습니다.

Strands Agents와 Bedrock AgentCore로 발전설비 진단 보조 에이전트를 구성한 사례를 소개했습니다. 판단 절차와 데이터 조회를 분리하고 검색·응답을 따로 평가한 점이 핵심입니다.
발전소 진단 지식을 Strands Agents와 Bedrock AgentCore로 연결하는 방법을 소개했습니다. 검색 계층과 응답 계층을 분리 평가해 근거 기반 진단 흐름을 설계했습니다.

쿠버네티스와 AWS EKS를 활용해 LLM 추론 인프라를 안정적으로 운영하는 방법을 설명했습니다. 특히 KV 캐시를 고려한 라우팅과 prefill/decode 분리를 통해 성능과 비용을 함께 개선하는 흐름을 다뤘습니다.